Aquí tienes un breve resumen
De un total de 2.372 indicaciones, Pangram 4.1 alcanza una precisión del 99,66 % en las respuestas de Claude Haiku 5.5 con el nivel de razonamiento «alto», y una precisión del 99,75 % con el nivel de razonamiento «medio», lo que supone una precisión total del 99,70 % en ambos ajustes.
Anthropic lanzó Claude Haiku 5.5 el 7 de octubre de 2026, tras el lanzamiento anterior de los demás modelos de esta serie: Sonnet 5.5 y Opus 5.5. Haiku es un modelo pequeño y muy económico que, por lo general, no se utiliza para tareas de redacción, sino que está pensado para generar resúmenes, realizar clasificaciones, consultar bases de datos o prestar un servicio rápido de atención al cliente. ¡Pero, de todos modos, lo someteremos a pruebas de rendimiento!
Haiku 5.5 es el primer modelo de Haiku con distintos niveles de esfuerzo, por lo que realizamos las pruebas tanto con un nivel de razonamiento alto como con uno medio. En 2.372 ejemplos de indicaciones, Pangram 4.1 clasificó 1 resultado de Haiku 5.5 como «humano», 6 como «mixto» y 2.365 como «generado íntegramente por IA», alcanzando una precisión del 99,70 % en Haiku 5.5.
| Modelo | Ejemplos | Índice de detección |
|---|---|---|
| Claude Haiku 5.5 (alto nivel de razonamiento) | 1,183 | 99.66% |
| Claude Haiku 5.5 (nivel de razonamiento medio) | 1,189 | 99.75% |
Para generar el conjunto de referencia, utilizamos 1.200 indicaciones de primera ronda del conjunto de datos LMSYS-Chat-1M (Zheng et al., 2023). A continuación, las introdujimos en Haiku 5.5 con niveles de razonamiento medio y alto, y procesamos el resultado con Pangram 4.1.
Resultados por categoría
En general, Pangram obtuvo muy buenos resultados en Haiku 5.5, tanto en el nivel de razonamiento alto como en el medio. No se observó una diferencia significativa en la tasa de detección entre el nivel de razonamiento medio y el alto (p = 0,73).
Razonamiento superior
Cuando Haiku 5.5 se configuró con un nivel alto de razonamiento, Pangram 4.1 clasificó 0 respuestas como humanas, 4 como mixtas y 1.179 como generadas íntegramente por IA, alcanzando una tasa de recuperación del 99,66 %.
| Categoría | Ejemplos | IA | Misto | Humano |
|---|---|---|---|---|
| Argumentos | 70 | 70 | 0 | 0 |
| Correos electrónicos / cartas | 60 | 60 | 0 | 0 |
| Ensayos / artículos | 139 | 139 | 0 | 0 |
| Explicaciones | 495 | 494 | 1 | 0 |
| Poemas y otros textos creativos | 107 | 106 | 1 | 0 |
| Opiniones | 2 | 2 | 0 | 0 |
| Historias | 97 | 97 | 0 | 0 |
| Programación y matemáticas | 10 | 10 | 0 | 0 |
| Juegos de rol y juegos | 60 | 60 | 0 | 0 |
| Otros | 143 | 141 | 2 | 0 |
| Total | 1,183 | 1,179 | 4 | 0 |
Razonamiento medio
En el razonamiento de nivel medio, el Pangram 4.1 clasificó 1 respuesta como humana, 2 como mixtas y 1.186 como generadas íntegramente por IA, alcanzando una tasa de recuperación del 99,75 %.
| Categoría | Ejemplos | IA | Misto | Humano |
|---|---|---|---|---|
| Argumentos | 70 | 70 | 0 | 0 |
| Correos electrónicos / cartas | 60 | 60 | 0 | 0 |
| Ensayos / artículos | 139 | 138 | 1 | 0 |
| Explicaciones | 496 | 494 | 1 | 1 |
| Poemas y otros textos creativos | 109 | 109 | 0 | 0 |
| Opiniones | 2 | 2 | 0 | 0 |
| Historias | 97 | 97 | 0 | 0 |
| Programación y matemáticas | 10 | 10 | 0 | 0 |
| Juegos de rol y juegos | 61 | 61 | 0 | 0 |
| Otros | 145 | 145 | 0 | 0 |
| Total | 1,189 | 1,186 | 2 | 1 |
¿Cómo funciona Haiku 5.5?
Al igual que GPT-6.1 Sol, Haiku 5.5 tiene una lista de nombres preferidos para la ficción. A Haiku 5.5 le gustaban especialmente Maya, Ruth y Mara. A diferencia de GPT-6.1 Sol y Gemini 4 Argon, Haiku 5.5 no utiliza guiones largos, y solo los emplea dos veces en todas sus respuestas (ambas en respuesta a la misma pregunta, para cortar una línea de diálogo). A Haiku 5.5 tampoco le gusta escribir intervalos con un guion corto; en lugar de escribir «5–10», Haiku 5.5 casi siempre escribe «5 a 10».
Pruebas de rendimiento anteriores
Pangram muestra un buen rendimiento frente a Haiku 5.5 en indicaciones de lenguaje natural y lo detecta con una precisión observada del 99,66 % en el nivel de razonamiento alto. Detecta Haiku 5.5 en el nivel de razonamiento medio con una precisión observada del 99,75 %, lo que supone un total combinado de 2.365 de 2.372 (99,70 %) en ambos ajustes. Pangram es capaz de generalizar a nuevos modelos porque las nuevas versiones suelen heredar gran parte del estilo y la voz de sus predecesores, por lo que no es necesario volver a entrenarlo con cada nuevo lanzamiento.
A continuación se muestra una comparación entre Haiku 5.5 y nuestros resultados de pruebas de rendimiento de otros modelos de vanguardia recientes:
| Modelo | Detectado como IA | Precisión |
|---|---|---|
| GPT-6.1 Sol | 1.091/1.105 | 98.73% |
| Gemini 4 Argón | 1.159/1.174 | 98.72% |
| Géminis 3.8 Flash | 998/1.000 | 99.80% |
| Gemini 3.1 Pro | 997/1.000 | 99.70% |
| Soneto 5.5 de Claude | 1.019/1.022 | 99.71% |
| Claude Opus 5.5 | 997/1.000 | 99.70% |
| GPT-6 Astra | 982/986 | 99.59% |
| Fábula 5.1 | 1.093/1.097 | 99.64% |
| Claude, Op. 5 | 1.105/1.107 | 99.82% |
| GPT-5.6 | 3.408/3.423 | 99.56% |
| Claude Soneto 5 | 1.145/1.147 | 99.83% |
Si quieres consultar un documento concreto, puedes probar Pangram aquí.
Lecturas relacionadas
Cómo preparar tu empresa para el LLM y la IA general
¿Puede Pangram detectar a Claude Opus 5.5?
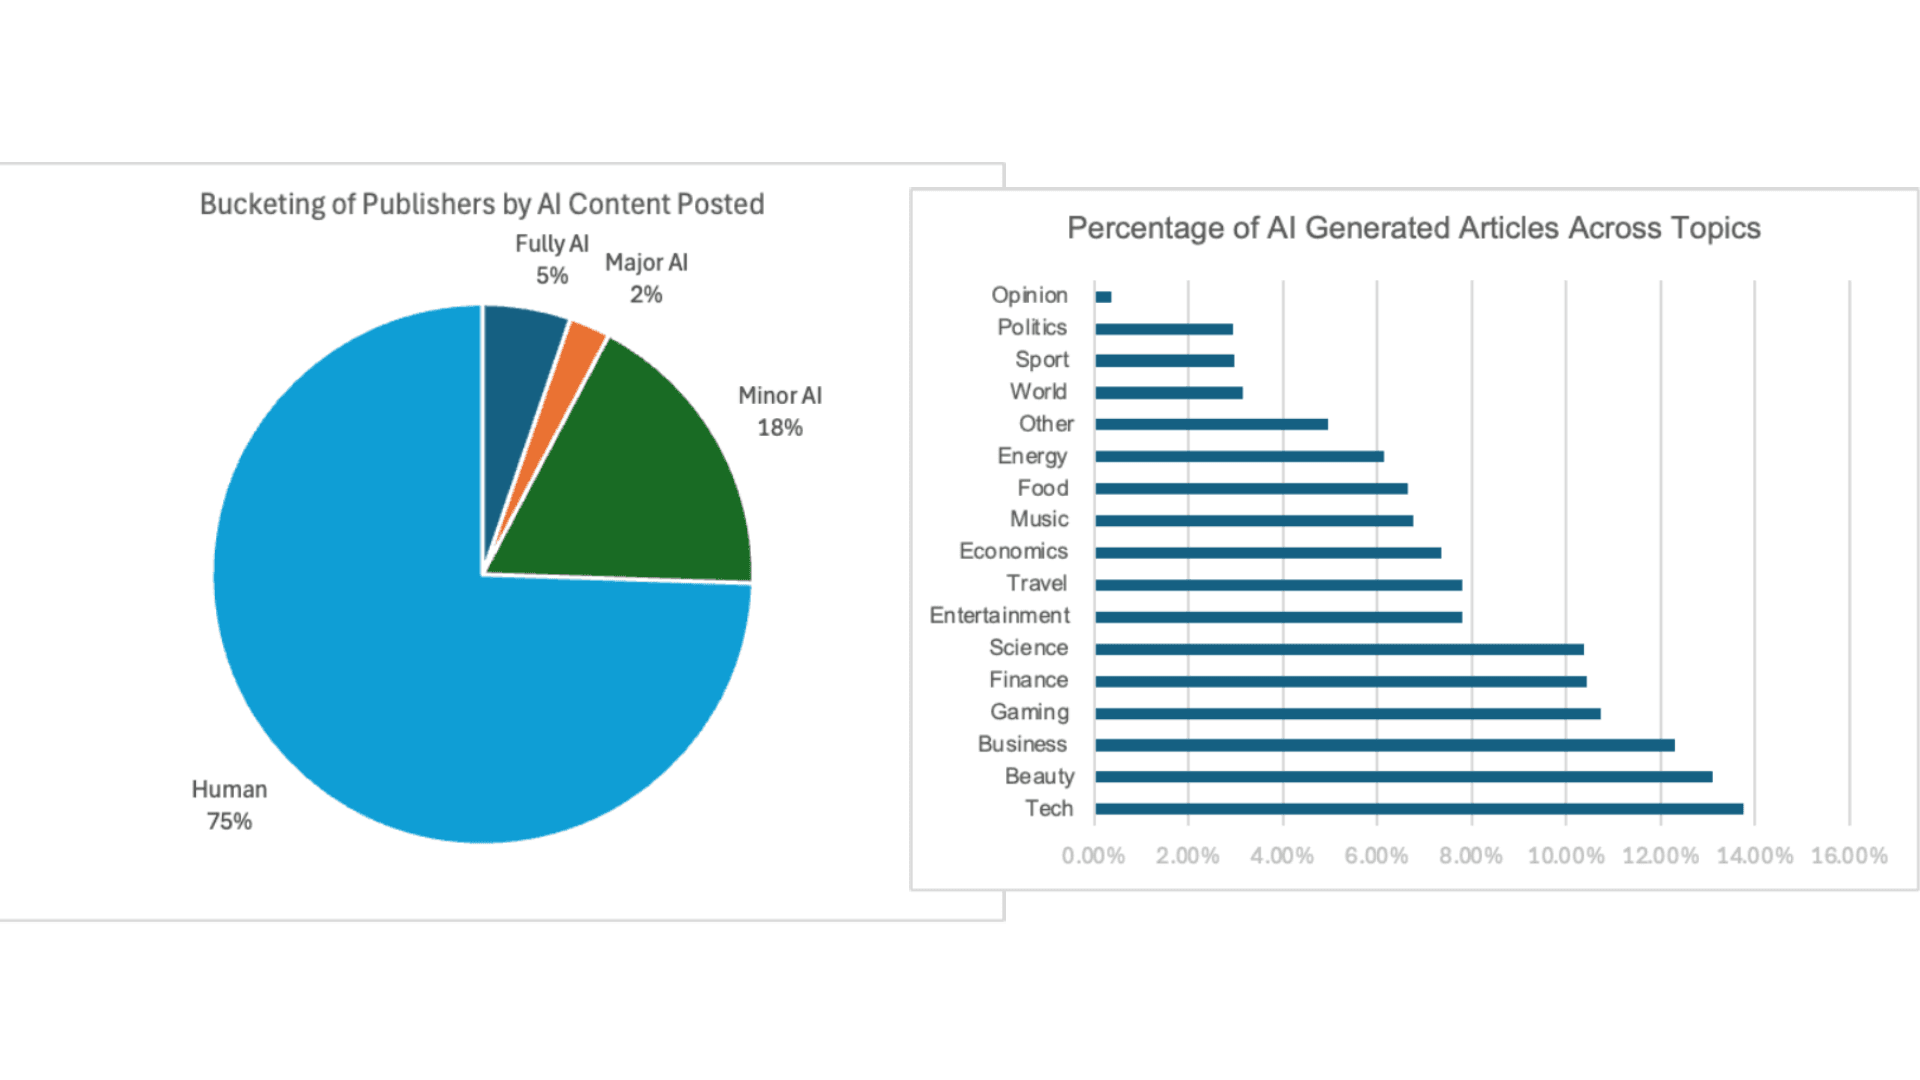
Cada día se publican 60 000 artículos de noticias generados por IA
¿Puede Pangram detectar el Argon del Gemini 4?

Rendimiento de Pangram en un enjambre de agentes que actúan en colusión