簡単にまとめると
2,372件のプロンプトのうち、Pangram 4.1は、Claude Haiku 5.5の出力に対して、高推論モードでは99.66%、中推論モードでは99.75%の精度を達成し、両設定を合わせた総合精度は99.70%となった。
Anthropic社は、同シリーズの他のモデルであるSonnet 5.5およびOpus 5.5に続き、2026年10月7日にClaude Haiku 5.5をリリースしました。Haikuは非常に安価な小型モデルであり、一般的に文章作成には使用されず、要約の生成、分類、データベースのクエリ、あるいは迅速なカスタマーサポートへの活用が主な用途とされています。とはいえ、ここではあえてそのベンチマークを行ってみましょう!
Haiku 5.5は、努力レベルが異なる初のHaikuモデルであるため、我々は「高推論」と「中推論」の両方でテストを行いました。2,372件のプロンプト例に対し、Pangram 4.1はHaiku 5.5の出力を「人間によるもの」を1件、「混合」を6件、「完全なAI生成」を2,365件と分類し、Haiku 5.5において99.70%の精度を達成しました。
| モデル | 例 | 検出率 |
|---|---|---|
| Claude Haiku 5.5(高度な推論) | 1,183 | 99.66% |
| クロード・ハイク 5.5(中程度の推論) | 1,189 | 99.75% |
ベンチマークセットを生成するために、LMSYS-Chat-1Mデータセット(Zheng et al., 2023)から1,200件の初回プロンプトを使用しました。次に、それらをHaiku 5.5に「中」および「高」の推論レベルで入力し、その出力をPangram 4.1で処理しました。
カテゴリー別結果
全体として、PangramはHaiku 5.5において、高レベルの推論と中レベルの推論の両方で非常に良好な結果を示した。中レベルの推論と高レベルの推論の間で、検出率に有意な差は見られなかった(p=0.73)。
高度な推論
Haiku 5.5の推論レベルを「高」に設定したところ、Pangram 4.1は0件の回答を「人間によるもの」、4件を「混合」、1,179件を「完全なAIによるもの」と分類し、99.66%のリコール率を達成しました。
| カテゴリ | 例 | AI | 混合 | 人間 |
|---|---|---|---|---|
| 引数 | 70 | 70 | 0 | 0 |
| 電子メール/手紙 | 60 | 60 | 0 | 0 |
| エッセイ・記事 | 139 | 139 | 0 | 0 |
| 説明 | 495 | 494 | 1 | 0 |
| 詩やその他の創作作品 | 107 | 106 | 1 | 0 |
| レビュー | 2 | 2 | 0 | 0 |
| ストーリー | 97 | 97 | 0 | 0 |
| プログラミングと数学 | 10 | 10 | 0 | 0 |
| ロールプレイとゲーム | 60 | 60 | 0 | 0 |
| その他 | 143 | 141 | 2 | 0 |
| 合計 | 1,183 | 1,179 | 4 | 0 |
中程度の推論
Reasoningの「中」レベルにおいて、パングラム4.1は、回答のうち1件を「人間によるもの」、2件を「混合」、1,186件を「完全なAIによるもの」と分類し、99.75%のリコール率を達成しました。
| カテゴリ | 例 | AI | 混合 | 人間 |
|---|---|---|---|---|
| 引数 | 70 | 70 | 0 | 0 |
| 電子メール/手紙 | 60 | 60 | 0 | 0 |
| エッセイ・記事 | 139 | 138 | 1 | 0 |
| 説明 | 496 | 494 | 1 | 1 |
| 詩やその他の創作作品 | 109 | 109 | 0 | 0 |
| レビュー | 2 | 2 | 0 | 0 |
| ストーリー | 97 | 97 | 0 | 0 |
| プログラミングと数学 | 10 | 10 | 0 | 0 |
| ロールプレイとゲーム | 61 | 61 | 0 | 0 |
| その他 | 145 | 145 | 0 | 0 |
| 合計 | 1,189 | 1,186 | 2 | 1 |
Haiku 5.5 はどのように記述するのでしょうか?
GPT-6.1 Solと同様に、Haiku 5.5もフィクション作品に好んで使う名前の候補リストを持っています。 Haiku 5.5は特に「Maya」、「Ruth」、「Mara」を好んでいました。GPT-6.1 SolやGemini 4 Argonとは異なり、Haiku 5.5は長ダッシュ(em dash)を使用せず、すべての回答を通じて長ダッシュを使ったのは2回のみでした(いずれも同じプロンプトへの応答で、会話の一行を切り取るために使用されました)。 また、Haiku 5.5はエンダッシュを使った範囲表記を好まず、「5–10」と書く代わりに、ほぼ常に「5 to 10」と表記します。
これまでのベンチマーク
Pangramは、自然言語プロンプトにおいてHaiku 5.5に対して堅牢であり、高難度の推論では99.66%の実測精度でこれを検出します。中難度の推論においても99.75%の実測精度でHaiku 5.5を検出しており、両設定を合わせた合計では2,372件中2,365件(99.70%)を検出しています。 Pangramは、新しいモデルが先行モデルのスタイルや語り口を多く継承する傾向があるため、新しいモデルへの汎化が可能であり、新しいモデルがリリースされるたびにPangramを再学習させる必要はありません。
Haiku 5.5と、他の最近の最先端モデルに関する当社のベンチマーク結果を比較すると、以下の通りです:
| モデル | AIとして検出されました | 正確性 |
|---|---|---|
| GPT-6.1 Sol | 1,091/1,105 | 98.73% |
| ジェミニ4 アルゴン | 1,159/1,174 | 98.72% |
| ジェミニ3.8フラッシュ | 998/1,000 | 99.80% |
| ジェミニ3.1プロ | 997/1,000 | 99.70% |
| クロード・ソネット 5.5 | 1,019/1,022 | 99.71% |
| クロード 作品5.5 | 997/1,000 | 99.70% |
| GPT-6 アストラ | 982/986 | 99.59% |
| フェイブル5.1 | 1,093/1,097 | 99.64% |
| クロード・オパス5 | 1,105/1,107 | 99.82% |
| GPT-5.6 | 3,408/3,423 | 99.56% |
| クロード・ソネット第5番 | 1,145/1,147 | 99.83% |
特定の文書を確認したい場合は、こちらのPangramを試してみてください。
関連記事
ビジネスをLLMおよびジェネレーティブAIに対応させる
パングラムは「クロード・オーパス5.5」を検出できるでしょうか?
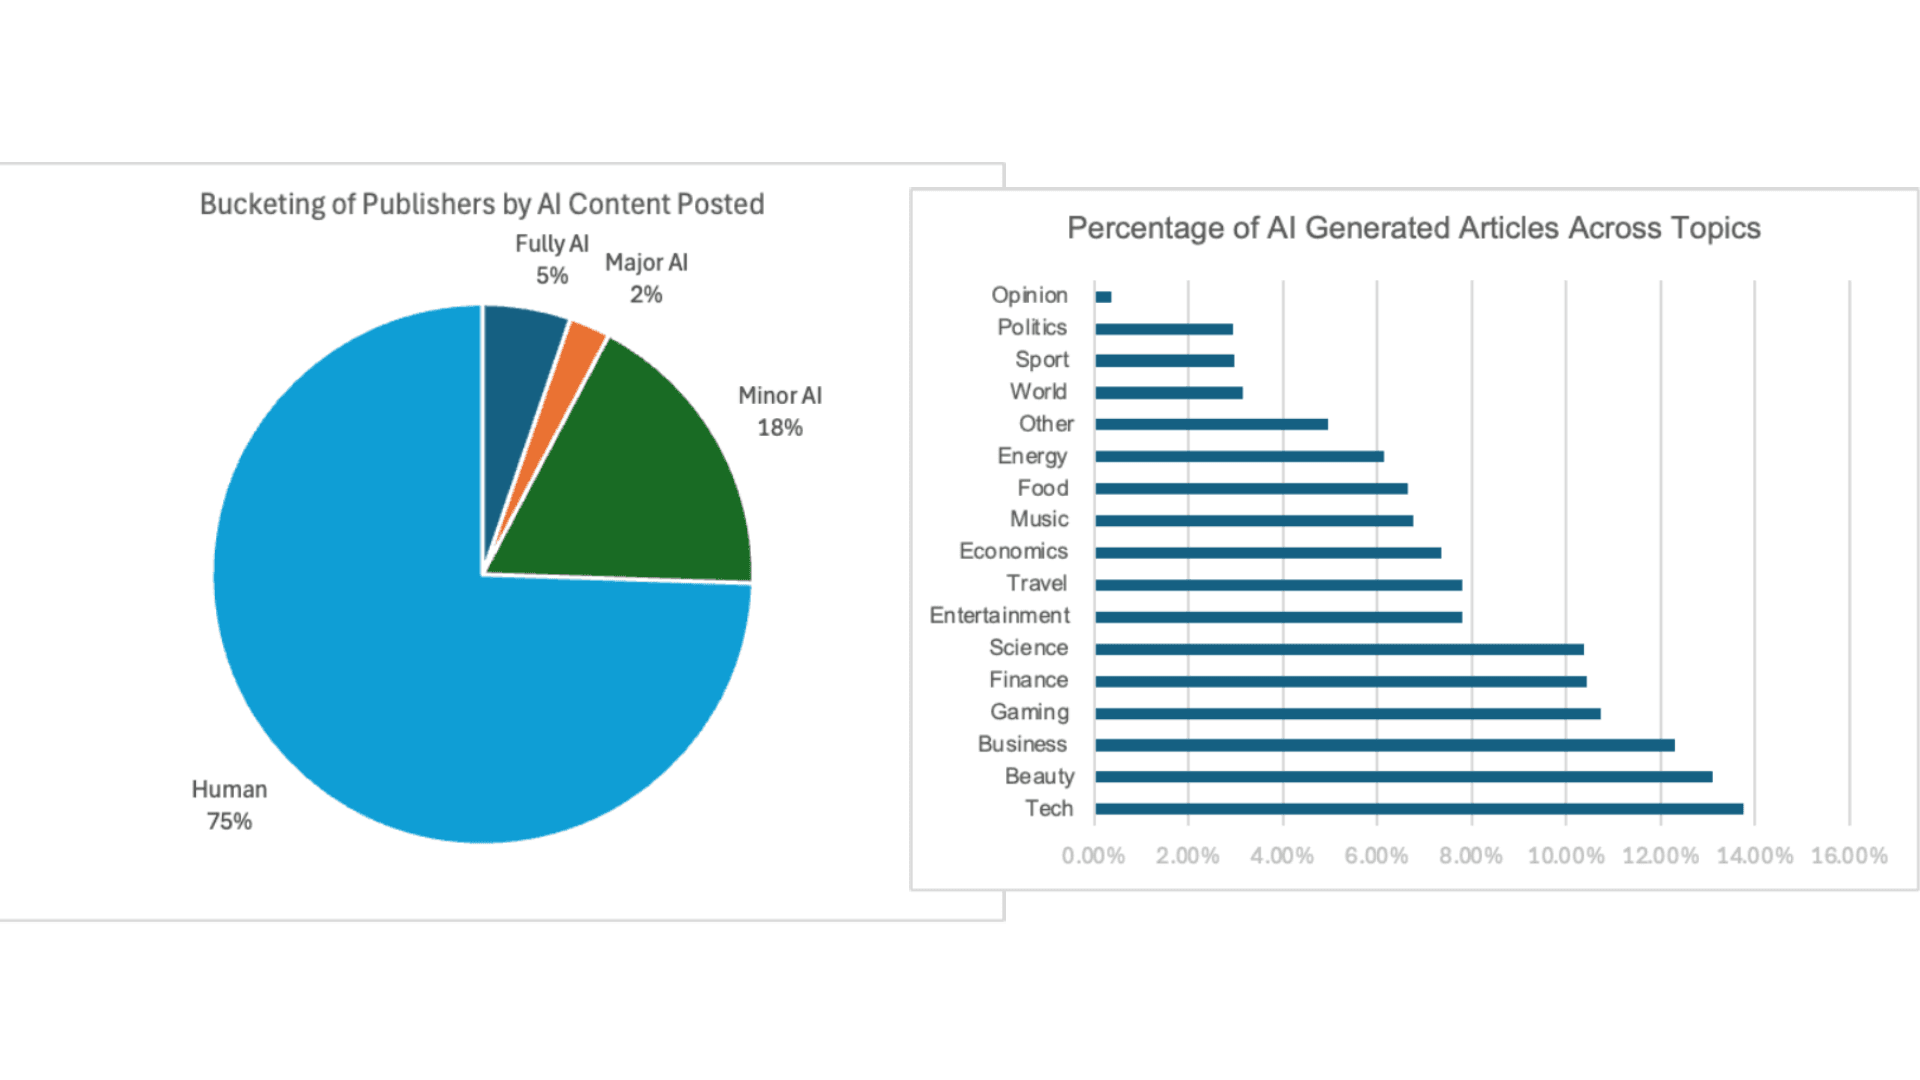
毎日6万本のAI生成ニュース記事が公開されている
パングラムはジェミニ4号のアルゴンを検知できるだろうか?

共謀するエージェントの群れにおけるパングラムの性能