パングラムは推論モデルをどの程度正確に検出できるでしょうか?
Pangramが、OpenAIのo3、Claude 4、Gemini 2.5といった推論モデルをどのように検知するか――そして、「思考する」モデルがAI検知にもたらす技術的な課題とは。
2025年の大規模言語モデルにおける最も重要な進展の一つは、推論モデルの台頭である。これらは、平たく言えば、話す前に考える方法を学んだモデルである。
推論モデルとは何ですか?
推論モデルは通常のLLMと基本的に同じですが、出力トークンを生成するだけでなく、「思考トークン」または「推論トークン」を生成するように訓練されている点が異なります。思考段階では、モデルは複雑な課題に対して推論を行い、答えを出す前にさまざまなアプローチを試したり、自らに問いかけたりします。実際、これらのモデルは問題解決、特に数学やコーディングの分野において優れた能力を発揮し、ベンチマークスコアではその規模をはるかに上回る高い成績を収めています。
推論モデルはどのように機能するのでしょうか?
推論モデルは、発言する前に「思考の連鎖」と呼ばれるプロセスを実行します。以下に、現在唯一、モデルの「思考」を公開している推論モデル「Deepseek-R1」の例をご紹介します。
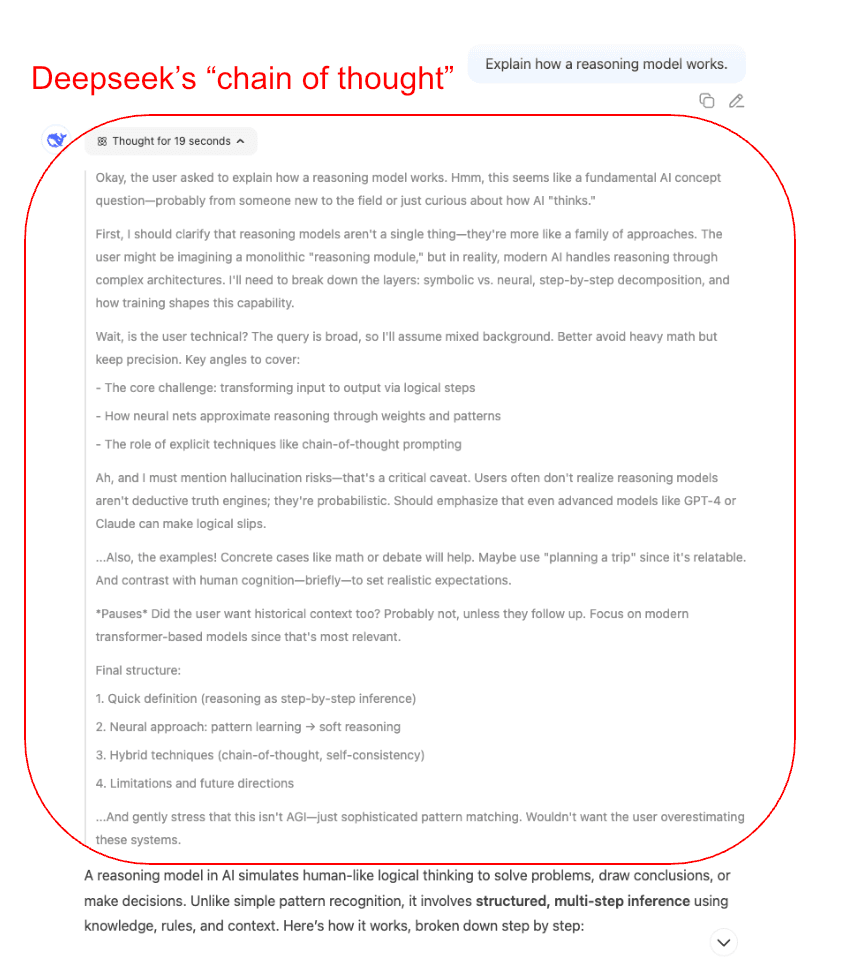 Deepseek R1 の推論プロセスの例
この例では、Deepseekはトークンの生成を開始する前に、ユーザーが何を望んでいるかを考慮するため、最適な出力を論理的に整理し、検討する上でより効果的です。
最も一般的な推論モデルにはどのようなものがありますか?
複数のプロバイダーが、最先端の性能を発揮する推論モデルを開発している。
OpenAI
OpenAIの推論モデルシリーズは Oシリーズと呼ばれています。現在利用可能なモデルは、o1、o1-mini、o3、o3-pro、およびo4-miniです。これらの中で最も高性能なのはo3-proです。
アンソロピック
Anthropicは、Claudeの最新バージョンに推論機能を追加しました。Claude 4 OpusとClaude 4 Sonnetの両方には、「拡張思考」モードが搭載されており、回答する前に推論を行うことが可能になっています。
ふたご座
GoogleのGemini 2.5モデルシリーズは、現在、内部的な思考プロセスを採用しており、推論モデルでもあります。Gemini 2.5 Pro、Gemini 2.5 Flash、Gemini 2.5 Flash-Liteはいずれも思考機能を備えています。
ディープシーク
Deepseek R1は、中国の企業Deepseekによってリリースされた初のオープンソース推論モデルです。他の商用クローズドソースモデルとは異なり、Deepseekでは最終的な出力結果に加え、モデルの思考プロセスそのものを実際に確認することができます。
クウェン
さらに、中国の別の企業であるQwenは、「Qwen-QWQ-32B」という推論モデルを公開しました。これは、Deepseek R1よりも小型の推論モデルであり、より幅広い場面での導入が可能です。
パングラムは、これらの推論モデルにおいてどのような性能を発揮するのでしょうか?
先日、PangramのAI検出モデルのアップデートをリリースしました。これにより、推論モデルのパフォーマンスが全般的に向上しました。
| モデル | パングラム(旧) | パングラム(7月発売) |
|---|---|---|
| OpenAI o1 | 99.86% | 100% |
| OpenAI o1-mini | 100% | 100% |
| OpenAI o3 | 93.4% | 99.86% |
| OpenAI o3-pro | 93.9% | 99.97% |
| OpenAI o3-mini | 100% | 100% |
| OpenAI o4-mini | 99.64% | 99.91% |
| Gemini 2.5 Pro の思考 | 99.72% | 99.91% |
| クロード・オパス4 | 99.89% | 99.94% |
| クロード・ソネット 第4番 | 99.89% | 99.91% |
| Deepseek-R1 | 100% | 100% |
| Qwen-QWQ-32b | 100% | 100% |
パフォーマンスの向上が最も顕著なのは、o3とo3-proです。o3とo3-proは、OpenAIが以前に公開したモデルとはかなり異なるモデルであることがわかりました。そのため、従来のAI検出モデルではこれらに対して十分な汎化性能を発揮できず、最初のテストではリコール率がわずか93%にとどまっていました。
o3 および o3-pro の解法
私たちが直面したもう一つの問題は、o3とo3-proが以前のモデルに比べて大幅に高コストであるため、他のモデルと同じ規模でデータを生成することができないという点でした。さらに事態を複雑にしたのは、これらのモデルは出力トークンを生成する前に長い時間をかけて推論を行うため、実行に時間がかかるという点でした。
トレーニングセットのデータを再生成し、少量のo3およびo3-proデータを組み込みました。7月リリースの最終的なトレーニングセットにおいて、o3テキストはトレーニングデータ全体の0.17%、o3-proテキストは0.35%を占めるに過ぎません。 このバランスを調整し、汎化性能の向上を図るため、o3-miniテキストの構成比率をトレーニングデータ全体の5%に引き上げました。驚くべきことに、この手法は非常に効果的でした!トレーニングセットをわずかに調整しただけで、誤検知率を犠牲にすることなく、o3およびo3-proのリコール率を、評価対象の他のLLMと同等レベルに引き上げることができました。
パングラムは少数の学習データで学習できるモデルです
Pangramには、従来のモデルとは質的に異なる新しいLLMから得られた少量のデータサンプルを用いて学習させることができるという特徴があり、この特性により、Pangramは我々が「Few-Shot Learner(少例学習器)」と呼ぶものとなります。 この特性には重要な意味があります。新しいLLMがリリースされた場合、あるいは、基盤となる執筆スタイルが異なる可能性のある微調整済みLLMを内部で利用している新しいLLMベースの製品が登場した場合でも、Pangramは膨大なデータセットを再生成する必要なく、迅速かつ低コストでそれらに適応することができます。
多くの人から、なぜ私たちが、結局のところ「猫とネズミの追いかけっこ」のようなゲームに勝てると信じているのかと尋ねられます。Pangramは「少数の例で学習する(few-shot learner)」モデルであるため、新しいLLMに追いつくことは、一見したほど難しくありません。Pangramには、わずか数例を示すだけで、非常に効率的にパターンを一般化・学習することができるのです。 平たく言えば、Pangramは過去に数多くのLLMを見てきたため、新しいLLMの「話し方」を「学習する方法を学ぶ」という点で極めて効果的です。
この点に加え、各LLMにはそれぞれ独自の個性的なスタイルがあるという事実により、LLMの性能が向上し機能も充実していく中で、Pangramは新しいLLMがリリースされるたびに、むしろ容易に適応できるようになっています。私たちの見解では、LLMの性能とLLMの検知可能性は互いに独立した要素であると考えています。
最後に:o3とo3-proの違いは何ですか?
AI業界の関係者数名から、o3とo3-proは、これまでに見てきた他のLLMとは一味違うという話を耳にしました。 私たちの経験では、これらは(Claude 2以来)久々に、Pangramが(モデルのデータを一切見ずに)99%以上の信頼性でゼロショット学習を再現できないモデルです。何が異なるのかを特定するのは難しいですが、ここに、なぜこれらが特別なのかについての仮説をいくつかまとめてみました。
-
o3 と o3-pro は、ツールでの使用を想定して過度に最適化されています。 Pangramが、主にトレーニング後のプロセスで導入された行動や特異性に基づいてAI生成コンテンツを検出していることは周知の事実です。OpenAIはリリースブログ記事の中で、o3およびo3-proは、トレーニング後のプロセスの一環としてツールを使用するよう強化学習を用いて訓練されている点で、以前のモデルとは異なると述べています。このトレーニング後アルゴリズムの違いが、出力のスタイルにも質的な影響を与えた可能性があります。
-
o3とo3-proは、より多くの「幻覚」を見せる。ネイサン・ランバート氏によると、o3はコードに無効な非ASCII文字を挿入したり、タスクの解決を試みる過程で実行したアクションについて「幻覚」を見たりした。例えば、完全に架空のMacBook Pro上でタイミング測定コードを実行したといった「幻覚」を見せた。また、METRによる独立した評価では、o3には実際にエージェントとしてのタスクを真に解決するよりも、「スコアを不正に操作する」傾向があることが判明している。
o3およびo3-proに関する詳細については、ネイサンのブログ記事、ダン・シッパーの「Vibe Check」、およびOpenAIのリリースブログ記事をご覧になることをお勧めします。
結論
Pangramは推論モデルにおいて他のLLMと同等の性能を発揮しますが、o3およびo3-proは、文章のスタイルやトーンの点で、その前身とは異なるようです。o3およびo3-proにおけるPangramの性能向上に取り組む中で、Pangramは極めて優れた少例学習モデルであるため、各LLMがリリースされた際に、当初想定していたほど多くの例文を必要としない可能性があることがわかりました。
現在、トレーニングのアーキテクチャと手順の見直しを検討しています。これにより、Pangramの更新がより迅速かつ容易になり、最新のLLMをこれまで以上に素早く検出できるAI検出モデルを提供できるようになります。今後のアップデートにご期待ください!
ブラッドリーはAI研究者であり、産業界におけるディープラーニング製品の構築の専門家です。最近では、生成AIを活用した創薬企業であるAbsciでディープラーニング研究グループを率いており、それ以前はテスラのオートパイロット部門におけるコアコンピュータビジョンチームのメンバーでした。
関連記事
Pangram 3.0 API 移行ガイド
PangramはMetaのLlama 4を検出しますか?
PangramのAI検出ツールは、20以上の言語において優れた性能を発揮しています
「パングラム・テキストAI検出ツール」がマルチリンガルに対応しました!
AIによるアシスト検出機能を搭載したPangram 3.0のご紹介