إليك ملخص موجز
من بين 2,215 موجهًا، حقق برنامج Pangram 4.1 دقة بلغت 98.73% في مخرجات GPT-6.1 Sol في مستوى الاستدلال العالي، ودقة بلغت 98.83% في مستوى الاستدلال المتوسط، لتبلغ الدقة الإجمالية 98.78% في كلا الإعدادين.
GPT-6.1 Sol هو نموذج ذكاء اصطناعي أطلقته OpenAI في 29 سبتمبر 2026. وتدعي OpenAI أن GPT-6.1 Sol يوفر «ذكاءً يقترب من مستوى Astra بخمس السعر» في مختلف المهام المتعلقة بالعمل، مثل البرمجة واستخدام الكمبيوتر. وعلى عكس معظم الإصدارات الحديثة التي رأيناها مؤخرًا، لم تدلِ OpenAI بأي تصريحات بشأن قدرة GPT-6.1 Sol على الكتابة أو وضوح نصوصه، فهل يكتب بنفس أسلوب النماذج السابقة، وهل يستطيع Pangram اكتشافه؟
قمنا باختبار أداء Pangram 4.1 على 2,215 مثالاً من المطالبات، ووجدنا أن Pangram 4.1 صنّف 6 من مخرجات GPT-6.1 Sol على أنها من إنتاج بشري، و21 على أنها مختلطة، و2,188 على أنها من إنتاج الذكاء الاصطناعي بالكامل، محققاً دقة بلغت 98.78% على GPT-6.1 Sol.
| نموذج | أمثلة | معدل الكشف |
|---|---|---|
| GPT-6.1 Sol (قدرة عالية على الاستدلال) | 1,105 | 98.73% |
| GPT-6.1 Sol (التفكير المتوسط) | 1,110 | 98.83% |
لإنشاء مجموعة المعايير المرجعية، استخدمنا 1,200 موجه من الجولة الأولى من مجموعة بيانات LMSYS (Zheng et al., 2023). ثم قدمناها إلى GPT-6.1 Sol على مستويي الاستدلال المتوسط والعالي، وقمنا بتشغيل النتائج عبر Pangram 4.1.
النتائج حسب الفئة
بشكل عام، سجل نظام GPT-6.1 Sol معدلًا للنتائج السلبية الخاطئة بلغ 1.27% من أصل 1,105 إجابة في مستوى التفكير العالي، ومعدلًا للنتائج السلبية الخاطئة بلغ 1.17% من أصل 1,110 إجابة في مستوى التفكير المتوسط. وبشكل عام، لم يكن هناك فرق ذو دلالة إحصائية في معدل الكشف بين مستويي التفكير المتوسط والعالي (p=0.85).
التفكير العالي
عندما تم ضبط GPT-6.1 Sol على مستوى عالٍ من الاستدلال، صنّف Pangram 4.1 3 ردود على أنها من صنع الإنسان، و11 ردودًا على أنها مختلطة، و1,091 ردودًا على أنها من صنع الذكاء الاصطناعي بالكامل، محققًا بذلك معدل استرجاع بلغ 98.73%.
| الفئة | أمثلة | الذكاء الاصطناعي | مختلط | البشر |
|---|---|---|---|---|
| الحجج | 64 | 64 | 0 | 0 |
| رسائل البريد الإلكتروني / الرسائل | 53 | 52 | 1 | 0 |
| مقالات / مقالات صحفية | 137 | 136 | 1 | 0 |
| تفسيرات | 481 | 477 | 3 | 1 |
| القصائد وغيرها من الكتابات الإبداعية | 97 | 94 | 2 | 1 |
| قصص | 89 | 89 | 0 | 0 |
| البرمجة والرياضيات | 10 | 10 | 0 | 0 |
| تمثيل الأدوار والألعاب | 42 | 42 | 0 | 0 |
| أخرى | 132 | 127 | 4 | 1 |
| المجموع | 1,105 | 1,091 | 11 | 3 |
التفكير المتوسط
في اختبار «Reasoning» المتوسط، صنّف «Pangram 4.1» 3 ردود على أنها من صنع البشر، و10 ردود على أنها مختلطة، و1,097 رداً على أنها من صنع الذكاء الاصطناعي بالكامل، محققاً معدل استرجاع بلغ 98.83%.
| الفئة | أمثلة | الذكاء الاصطناعي | مختلط | البشر |
|---|---|---|---|---|
| الحجج | 64 | 64 | 0 | 0 |
| رسائل البريد الإلكتروني / الرسائل | 55 | 55 | 0 | 0 |
| مقالات / مقالات صحفية | 138 | 137 | 1 | 0 |
| تفسيرات | 481 | 474 | 5 | 2 |
| القصائد وغيرها من الكتابات الإبداعية | 99 | 96 | 2 | 1 |
| التعليقات | 1 | 1 | 0 | 0 |
| قصص | 85 | 85 | 0 | 0 |
| البرمجة والرياضيات | 10 | 10 | 0 | 0 |
| تمثيل الأدوار والألعاب | 42 | 42 | 0 | 0 |
| أخرى | 135 | 133 | 2 | 0 |
| المجموع | 1,110 | 1,097 | 10 | 3 |
ما رأيك في اسم «سول»؟
يتميز نموذج GPT-6.1 Sol بأسلوبه الفريد في استخدام علامات الترقيم؛ فعلى سبيل المثال، يستخدم الفواصل المنحنية في 74% من إجاباته، ولا يستخدم الفواصل المستقيمة أبدًا تقريبًا، لا سيما بالمقارنة مع النماذج الحديثة الأخرى.
| GPT-6.1 Sol | كلود هايكو 5.5 | جيميني 4 أرجون | |
|---|---|---|---|
| الفاصلة العليا الملتوية ’ | 73.9% | 0.0% | 9.1% |
| علامة الفاصلة العليا المستقيمة ' داخل الكلمة | 0.5% | 75.4% | 48.5% |
| علامات الاقتباس المزدوجة الملتوية “ ” | 39.0% | <0.1% | <0.1% |
كما أنها تفضل استخدام كل من الشرطة الطويلة (em dash) والشرطة القصيرة (en dash)، حيث تستخدم في المتوسط 1.3 شرطة طويلة لكل 1,000 كلمة — وهو عدد يفوق بكثير ما تستخدمه كل من Haiku 5.5 وGemini 4 Argon.
| GPT-6.1 Sol | كلود هايكو 5.5 | جيميني 4 أرجون | |
|---|---|---|---|
| الإجابات التي تحتوي على شرطة طويلة — | 29.7% | 0.1% | 12.1% |
| عدد الشرطات الطويلة لكل 1,000 كلمة | 1.32 | <0.01 | 0.85 |
| الإجابات التي تحتوي على شرطة قصيرة – | 11.4% | 0.4% | 0.4% |
في مجال الكتابة الإبداعية، أظهر GPT-6.1 Sol بعض العادات الثابتة. فقد أظهر تفضيلًا قويًّا لتسمية شخصياته النسائية إما «مارا» أو «مايا» (وقد ظهرت إحداهما على الأقل في 65 ردًّا)، وعادةً ما جعل الأحرف الأولى من اسميهما «M.V.»، مع تفضيله بشكل عام لاسم العائلة «فالي» (Vale) بشكل عام (لكن ظهرت أيضًا «مارا فيليز» و«مارا فين»). أما بالنسبة للأسماء الذكورية، فإن الاسم المفضل لدى GPT-6.1 Sol هو «دانيال»، والذي لم يقترنه باسم عائلة سوى مرتين (مرة مع «فالي» ومرة مع «ميرسر»). ومن بين 418 ردًا في مجال الكتابة الإبداعية، استهل GPT-6.1 Sol 36 مرة بعبارة «الأول...»؛ وهي نسبة أعلى بكثير من «هايكو» و«جيميني»، اللذين استهلا 11 مرة ومرة واحدة على التوالي.
رفضت «سول» الرد على 23 طلبًا، ورفضت جزئيًّا 32 طلبًا إضافيًّا. وفي حالات الرفض الجزئي، استبدلت «سول» ما طُلب بنسخة مخففة أو مختلفة. ويعزى معظم حالات الرفض الجزئي هذه إلى حقيقة أن مجموعة المطالبات التي قدمناها تضمنت بالفعل طلبات كتابة إبداعية ذات طابع موحٍ. وتعاملت «سول» مع هذا الأمر بتجنب كتابة محتوى صريح، واختارت بدلاً من ذلك الانتقال إلى شاشة سوداء.
يكتب «سول» أحيانًا إجابات قصيرة جدًّا، حيث يبلغ عدد الكلمات في 95 إجابة منها أقل من 50 كلمة في المستوى العالي، و90 إجابة في المستوى المتوسط. وبلغ متوسط عدد الكلمات في إجابات «سول» 300 كلمة، وتراوح عدد الكلمات بين 50 و10,513 كلمة.
المعايير المرجعية السابقة
يُظهر «بانغرام» أداءً قويًّا في التعرف على نموذج GPT-6.1 Sol عند استخدام المطالبات باللغة الطبيعية، ويكتشفه بدقة ملاحظة تبلغ 98.73% في مستوى الاستدلال العالي. كما يكتشف نموذج GPT-6.1 Sol في مستوى الاستدلال المتوسط بدقة ملاحظة تبلغ 98.83%، ليبلغ المجموع 2,188 من أصل 2,215 (98.78%) في كلا الإعدادين. يستطيع Pangram التعميم على النماذج الجديدة لأن الإصدارات الجديدة من النماذج تميل إلى وراثة الكثير من أسلوب وصوت سابقاتها، لذا لا يحتاج Pangram إلى إعادة التدريب مع كل إصدار جديد.
فيما يلي مقارنة بين GPT-6.1 Sol ومعاييرنا المرجعية الخاصة بالنماذج الرائدة الأخرى الحديثة:
| نموذج | تم اكتشافه كذكاء اصطناعي | الدقة |
|---|---|---|
| كلود هايكو 5.5 | 1,179/1,183 | 99.66% |
| جيميني 4 أرجون | 1,159/1,174 | 98.72% |
| جيميني 3.8 فلاش | 998/1000 | 99.80% |
| جيميني 3.1 برو | 997/1000 | 99.70% |
| كلود سونيت 5.5 | 1019/1022 | 99.71% |
| كلود أوبوس 5.5 | 997/1000 | 99.70% |
| GPT-6 أسترا | 982/986 | 99.59% |
| الأسطورة 5.1 | 1093/1097 | 99.64% |
| كلود، المقطوعة رقم 5 | 1105/1107 | 99.82% |
| GPT-5.6 | 3408/3423 | 99.56% |
| كلود سونيت 5 | 1145/1147 | 99.83% |
إذا كنت ترغب في التحقق من مستند معين، يمكنك تجربة موقع «بانغرام» هنا.
مقالات ذات صلة
تقييمات البانغرام من قبل أطراف ثالثة
تتوقع Pangram أن 21% من المراجعات في مؤتمر ICLR تم إنشاؤها بواسطة الذكاء الاصطناعي
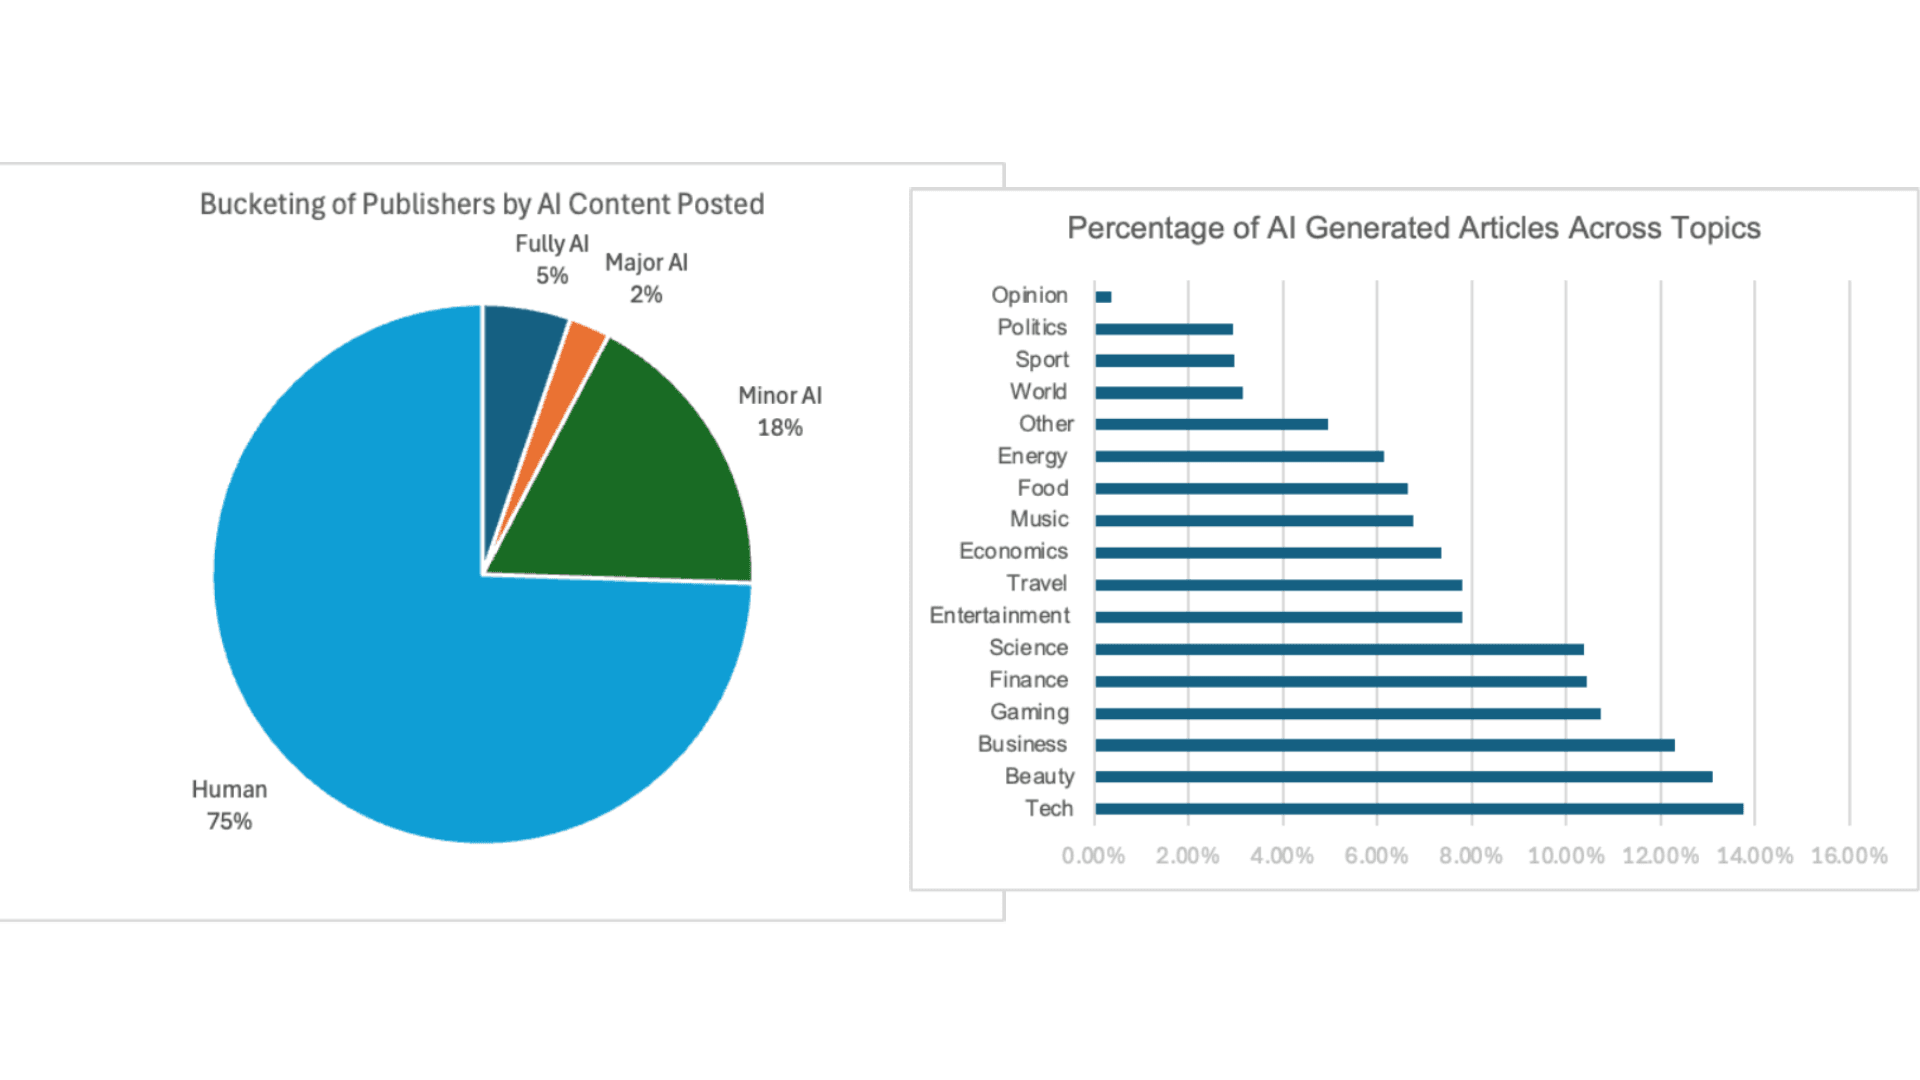
يتم نشر 60 ألف مقال إخباري تم إنشاؤها بواسطة الذكاء الاصطناعي يوميًا
كيف يستخدم Gradpilot برنامج Pangram لمساعدة الطلاب على إيجاد أسلوبهم الخاص
الذكاء الاصطناعي يكتب روايات حائزة على جوائز