هل يستطيع برنامج Pangram اكتشاف Gemini 3.8 Flash و Gemini 3.1 Pro؟
بالإضافة إلى مناقشة اختيار الموجه المعياري، وتوزيع العينة، وأهمية الإحصاء

إليك ملخص موجز
من بين 1000 موجه، حقق Pangram 4 دقة بنسبة 99.80٪ على مخرجات Gemini 3.8 Flash، ودقة بنسبة 99.70٪ على مخرجات Gemini 3.1 Pro، ليصبح إجمالي الدقة 99.75٪ على أحدث إصدار من عائلة Gemini لمجموعة المعايير هذه.
من بين ألف مثال للغة الطبيعية، صنّف برنامج بانغرام 4 مخرجين من برنامج جيميني 3.8 فلاش على أنهما بشريان، و998 مخرجًا على أنها مُولّدة بالكامل بواسطة الذكاء الاصطناعي، محققًا دقة بلغت 99.80% على برنامج جيميني 3.8 فلاش. أما على برنامج جيميني 3.1 برو (الذي صدر في 19 فبراير 2026)، فقد صنّف بانغرام مخرجًا واحدًا على أنه مختلط، ومخرجين على أنهما بشريان بالكامل، و997 مخرجًا على أنها مُولّدة بالكامل بواسطة الذكاء الاصطناعي، محققًا دقة بلغت 99.70% على برنامج جيميني 3.1 برو.
لإنشاء مجموعة البيانات المعيارية، استخدمتُ مجموعة فرعية مُفلترة من مُطالبات المحادثة الأولى في Chatbot Arena من مجموعة بيانات LMSYS (Zheng et al., 2023). وقد استبعدتُ المُطالبات التي تطلب كتابة أكواد، أو مسائل رياضية، أو إجابات قصيرة جدًا أو طويلة جدًا، أو كتابة إبداعية غير مناسبة. ثمّ أدخلتُ هذه المُطالبات إلى برنامجي Gemini 3.8 Flash وGemini 3.1 Pro، وعالجتُ المُخرجات باستخدام برنامج Pangram 4 .
فيما يلي نناقش نتائج الكشف حسب الفئة، والنتائج السلبية الخاطئة، وكيف كان أداء Gemini 3.1 Pro على المعايير السابقة، وبعض أوجه القصور والتحسينات المستقبلية لاختياري السريع لمنشور المدونة.
النتائج حسب الفئة
بحسب فئة الموجه (التي تم تعيينها بواسطة وكلاء هايكو)، إليك كيفية أداء بانغرام 4 على 1000 مخرج فلاش من نوع جيميني 3.8:
| الفئة | أمثلة | الذكاء الاصطناعي | مختلط | البشر |
|---|---|---|---|---|
| الحجج | 18 | 18 | 0 | 0 |
| رسائل البريد الإلكتروني / الرسائل | 54 | 53 | 0 | 1 |
| مقالات / مقالات صحفية | 33 | 33 | 0 | 0 |
| تفسيرات | 563 | 563 | 0 | 0 |
| قصائد | 108 | 107 | 0 | 1 |
| أعمال أخرى في مجال الكتابة الإبداعية | 75 | 75 | 0 | 0 |
| التعليقات | 7 | 7 | 0 | 0 |
| قصص | 142 | 142 | 0 | 0 |
| المجموع | 1,000 | 998 | 0 | 2 |
وفيما يلي نتائج تصنيف برنامج Gemini 3.1 Pro:
| الفئة | أمثلة | الذكاء الاصطناعي | مختلط | البشر |
|---|---|---|---|---|
| الحجج | 18 | 18 | 0 | 0 |
| رسائل البريد الإلكتروني / الرسائل | 55 | 55 | 0 | 0 |
| مقالات / مقالات صحفية | 33 | 33 | 0 | 0 |
| تفسيرات | 559 | 559 | 0 | 0 |
| القصائد وغيرها من الكتابات الإبداعية | 182 | 179 | 1 | 2 |
| التعليقات | 7 | 7 | 0 | 0 |
| قصص | 146 | 146 | 0 | 0 |
| المجموع | 1,000 | 997 | 1 | 2 |
كان أحد الأخطاء السلبية الخاطئة لبرنامج Gemini 3.8 Flash هو مطالبة النموذج بإضفاء طابع بشري على المخرجات ، مما أدى إلى إضافة أخطاء إملائية وكتابية:
اكتب رسالة مليئة بالأخطاء الإملائية والنحوية إلى عشيرة (في لعبة Raid Shadow Legends، أنا لاعب جديد في المستوى 10) تُدعى HelpWanted. اجعلها رسالة قصيرة ومقنعة للغاية.
أغفل برنامج Pangram 4 كلا نسختي Penguinmandias من النموذجين، تمامًا كما حدث عند إنشائه بواسطة Opus 5.5 . الموجه هو:
اكتب لي قصيدة عن نادي البطريق على غرار أوزيماندياس
بالنسبة لبرنامج Gemini 3.1 Pro، تشترك 71% من كلمات قصيدة Penguinmandias مع قصيدة شيلي الأصلية، لذا أعتقد أن هذه نتيجة سلبية خاطئة لا تستدعي القلق. كما أنتج برنامج Gemini 3.1 Pro خطأين آخرين، وكلاهما قصيدتان.
ما الذي يجعل النتيجة معيارية؟
في تقريرنا الفني حول بانغرام 4، أجرينا اختبارًا للنتائج السلبية الخاطئة على 520,000 مخرجات ذكاء اصطناعي من 26 نموذجًا مختلفًا، أي 20,000 استجابة لكل نموذج. وكان من بين النماذج المختبرة في التقرير نموذج جيميني 3.1 برو، الذي اختبرناه هنا أيضًا. مع ذلك، وكما ستلاحظون عند مراجعة التقرير الفني، وجدنا معدلًا مختلفًا وأعلى للنتائج السلبية الخاطئة في تلك المجموعة من المخرجات مقارنةً بهذه المجموعة. ما السبب؟
أحد التفسيرات هو أنهما ليسا مختلفين إحصائيًا. فنسبة الأخطاء الثلاثة من بين كل ألف استجابة التي وجدناها هنا تُترجم إلى معدل خطأ سلبي مُلاحظ قدره 0.3%، ويتراوح هذا المعدل ضمن نطاق 95% من 0.06% إلى 0.87%. أما معدل الخطأ السلبي المذكور في التقرير الفني فهو 111 خطأ من بين 20 ألف استجابة، أي ما يعادل 0.555%، وهو ضمن هذا النطاق.
لكن ماذا أعني عندما أقول إن هذه الأرقام ليست مختلفة إحصائيًا؟ لنفترض أن لديّ مجموعة كبيرة من 400 حالة اختبار أعرف مسبقًا أنها إيجابية، وأريد اختبار ما إذا كان جهاز الكشف يصنفها بشكل صحيح على أنها إيجابية أم يصنف بعضها خطأً على أنها سلبية. في المجموعة (أ)، أختبر جميع الأمثلة الـ 400 وأجد أن 5 منها مصنفة خطأً على أنها سلبية (ممثلة أدناه بنقاط حمراء)، وهو ما يُترجم إلى معدل سلبي خاطئ بنسبة 1.25% لجهاز الكشف الخاص بي على المجموعة بأكملها. ممتاز!
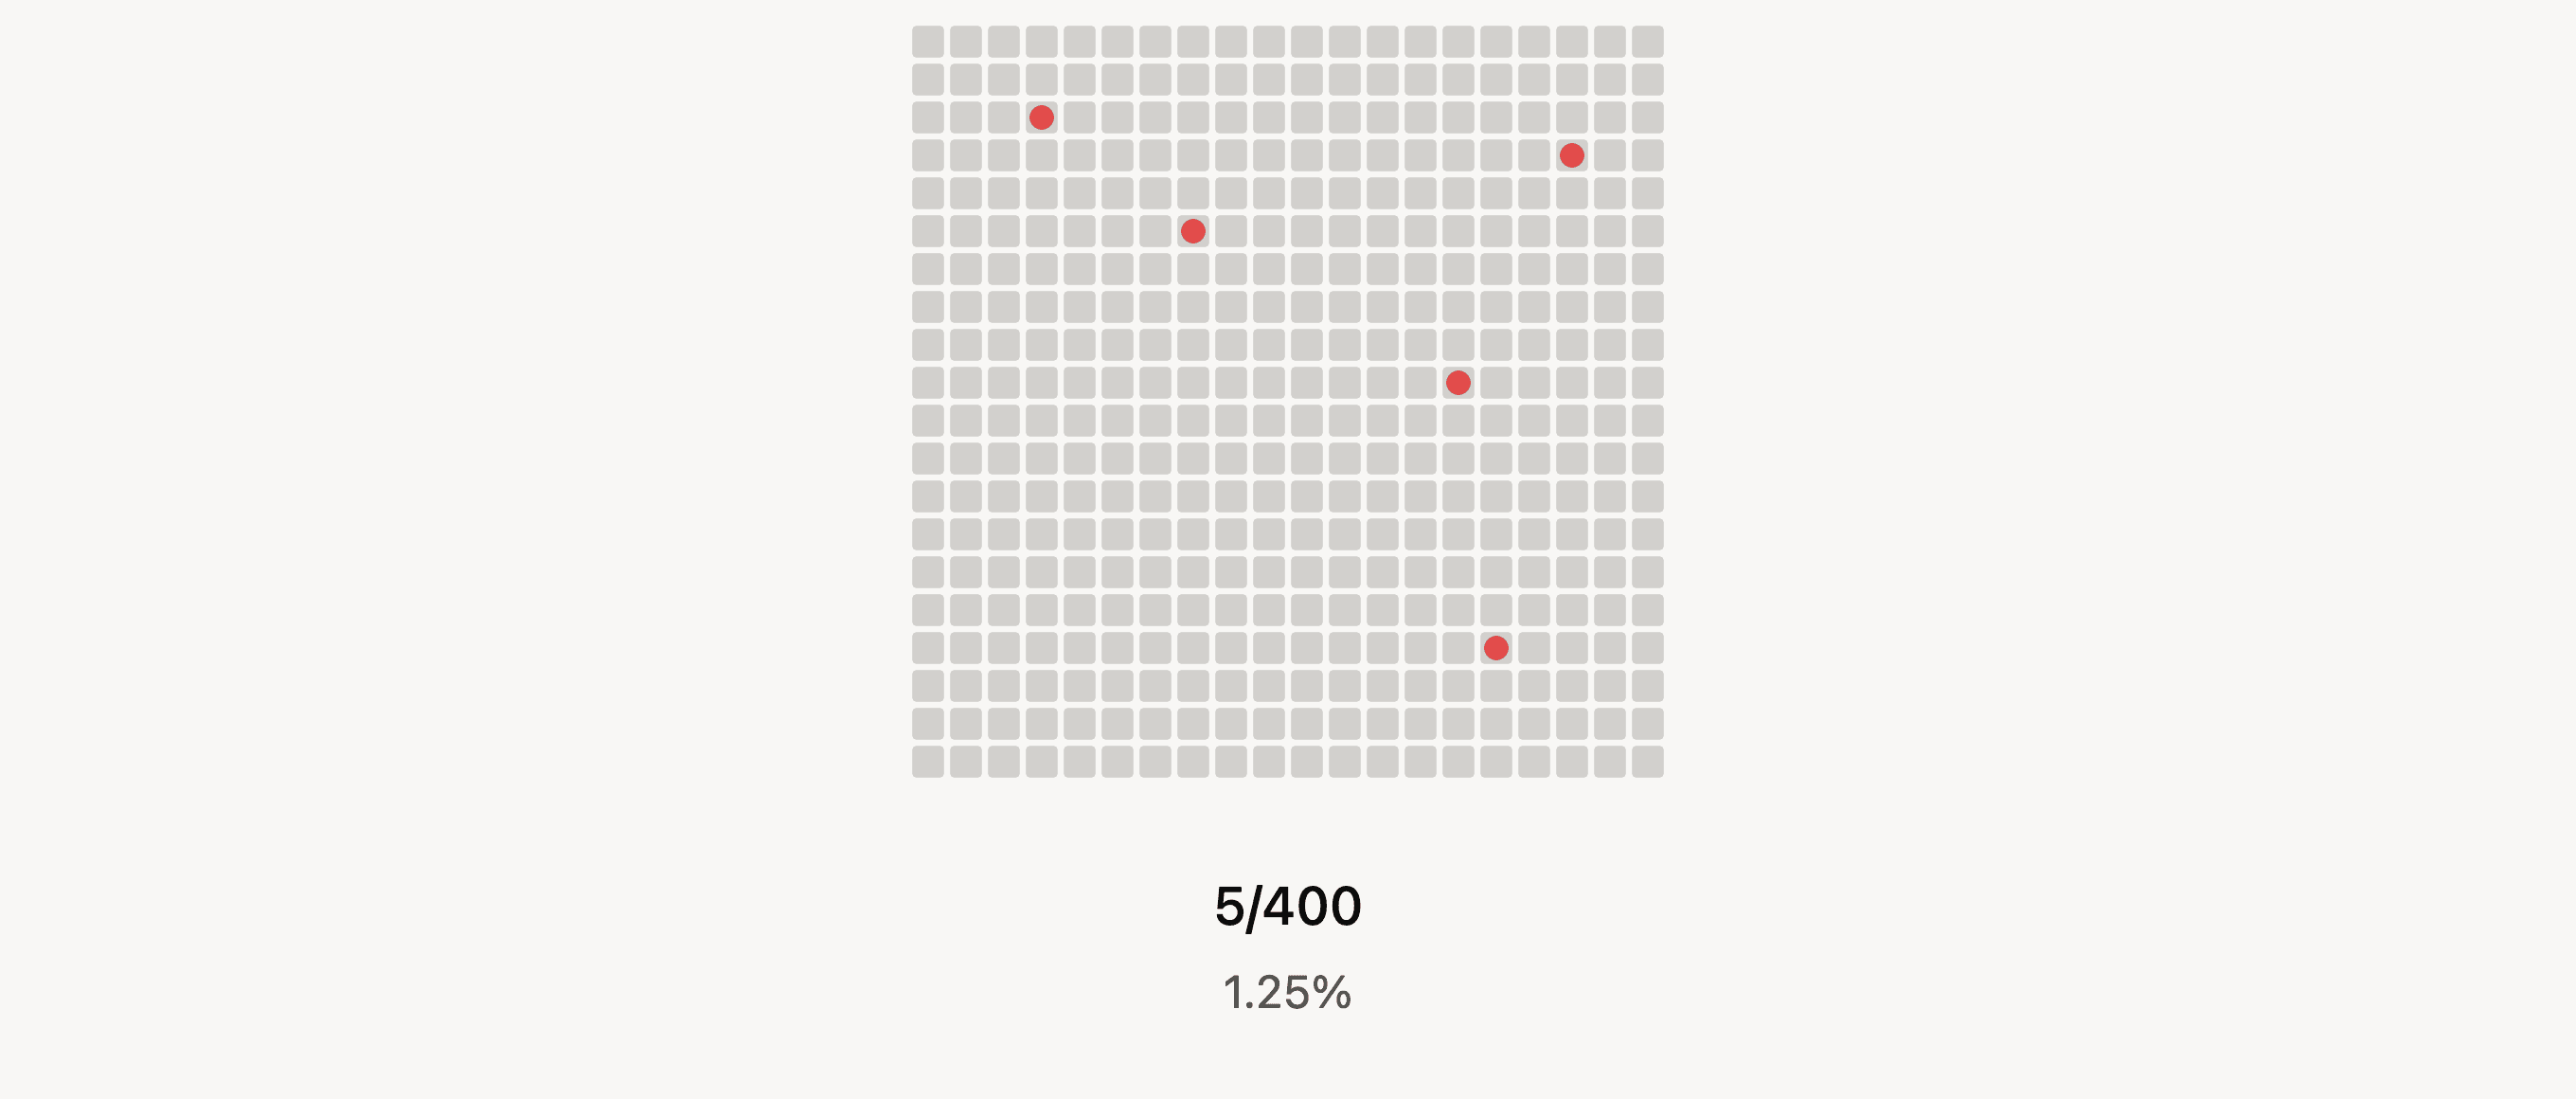
أما في المجموعة "ب"، فلسبب أو لآخر، أعاني من محدودية الموارد. لا أستطيع اختبار سوى جزء صغير من الأمثلة الـ 400. هذا يعني أنه عليّ اختيار عينة، ويفضل أن تكون عشوائية، وإجراء الاختبار عليها. لنفترض أنني أستطيع اختبار 40 مثالًا، أي 10% من مجموعتي. فيما يلي ثلاث طرق مختلفة لاختيار هذه المجموعة، كل منها ينتج عنه معدل مختلف للنتائج السلبية الخاطئة.
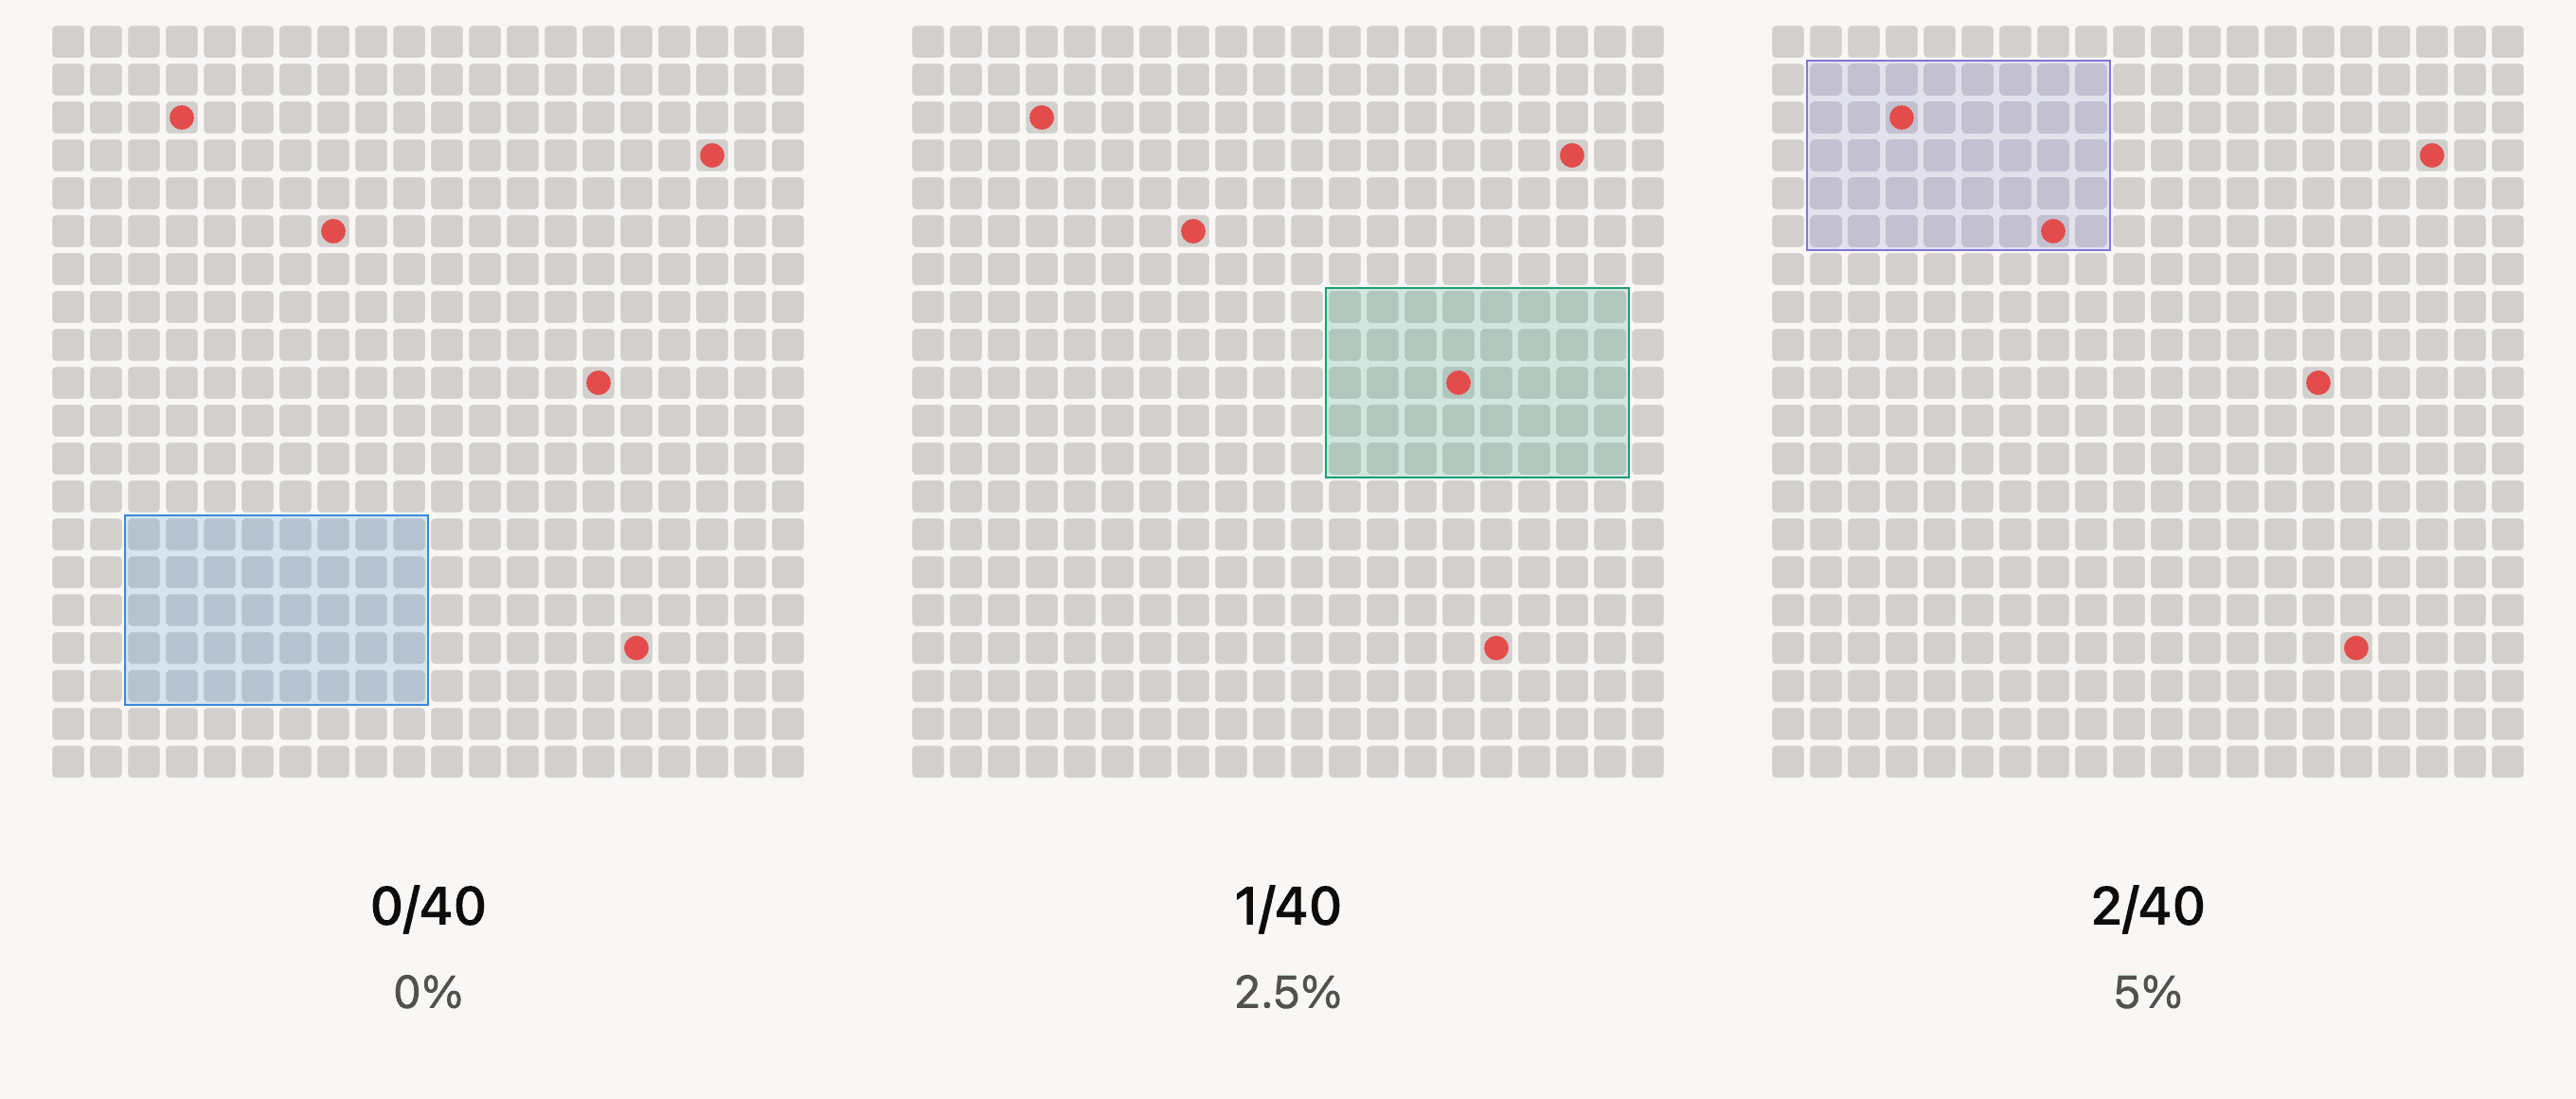
تُظهر كل عينة من هذه العينات معدلًا مختلفًا للنتائج السلبية الخاطئة، ولا يتوافق أي منها مع معدل النتائج السلبية الخاطئة "الحقيقي" للكاشف البالغ 1.25% والذي كان متاحًا لنا في المجموعة (أ). من المتوقع أن تلتقط عينة عشوائية من 40 مربعًا في هذه الشبكة نصف نقطة حمراء، ولكن اعتمادًا على طريقة أخذ العينات، قد لا تلتقط أي نقاط حمراء، كما في العينة الزرقاء، أو نقطة حمراء واحدة، أو نقطتين حمراوين، كما في العينة البنفسجية. قد تلتقط عينة سيئة الحظ جميع النقاط الحمراء، وفي هذه الحالة سيكون معدل النتائج السلبية الخاطئة المُلاحظ 5/40، أو 12.5%.
مع ذلك، من غير المرجح حدوث عينة سيئة الحظ كهذه. فعينة عشوائية بنسبة 10% من المجموعة ستُظهر ما بين صفر ونقطتين في 99% من الحالات - وهذا النطاق ناتج عما يُسمى بتوزيع المعاينة. عمليًا، هذا يعني أن حجم عينة المجموعة "ب" البالغ 40 حالة من أصل 400 حالة محتملة لا يُمكنه التمييز بين معدل سلبي خاطئ أساسي بنسبة 0% ومعدل سلبي خاطئ أساسي بنسبة 5%. كلما كبرت العينة، ضاق هذا النطاق: فلو أخذنا عينة، على سبيل المثال، من 125 نقطة من أصل 400 نقطة، لوجدنا ما بين صفر وأربع نقاط في 99% من الحالات، أو معدل سلبي خاطئ مُلاحظ يتراوح بين 0 و3.2%.
ينطبق المنطق نفسه على معايير Gemini 3.1 Pro، ولا يوجد تعارض بين نتيجتي الخطأ السلبي المختلفتين. مع ذلك، قد يثير هذا الاختلاف تساؤلاً حول أيّهما أثق به أكثر. عمومًا، يعتمد القرار على حجم العينة: فكلما زاد حجم العينة، زادت دقة النتائج وقلّت احتمالية الخطأ. بناءً على ذلك، يُنصح بالوثوق بمعيار التقرير الفني أكثر، واعتبار هذا المعيار مجرد مؤشر.
هناك طرق أخرى قد تختلف بها نتائج اختبارين معياريين. على عكس مثال الشبكة، فإن مجموعة الاختبار المعياري التي استخدمتها ليست مجموعة فرعية دقيقة من 20,000 سؤال من أسئلة Chatbot Arena المستخدمة في التقرير الفني: في المجمل، اشترك اختبارا Gemini 3.1 Pro المعياريان في 286 سؤالًا متطابقًا. هذا يترك احتمال أن 714 سؤالًا من أسئلة الاختبار المعياري التي استخدمتها ربما كانت أكثر ملاءمة لإنتاج مخرجات ذكاء اصطناعي قابلة للكشف من تلك المستخدمة في التقرير الفني لـ Pangram 4.
لا يبدو أن هذا هو الحال. تستبعد كلتا المجموعتين اللغات الأخرى والرياضيات ومخرجات البرمجة. مع ذلك، توجد اختلافات: كان متوسط عدد الكلمات لكل استجابة في برنامج Gemini 3.1 Pro أعلى في مجموعتي مقارنةً بمجموعة التقارير الفنية، ومن المعروف أن النصوص الأطول أسهل في التقييم. لكن أيّ المجموعتين تُعدّ اختبارًا أكثر عدلًا للنموذج؟ إذا تحكّمنا في طول المخرجات وحجم العينة، فأي مجموعة من المطالبات تُمثّل المجتمع (أ) بشكل أفضل؟
الإجابة الحقيقية هي أنني لا أعرف ولا أستطيع الجزم. من الصعب، بل يكاد يكون مستحيلاً، إنشاء مجموعة بيانات تمثل العالم الحقيقي تمثيلاً دقيقاً وكاملاً. هذا هو القيد الأساسي للإحصاء. في الواقع، كل معيار هو مربع صغير ضمن مجموعة من العينات التي تقارب الواقع الكامن في الكون (أ)، أو العالم "الخارجي". من وجهة نظر معينة، يمكن تفسير هذه الحقيقة على أنها تعني أن جميع نتائج المعايير خاطئة، وهذا ليس خطأً، لكنه لا يعني أنها غير مفيدة. من خلال تجميع العديد من النتائج المختلفة على أنواع مختلفة من مجموعات البيانات، يمكننا الاقتراب من تقريب جيد للواقع الكامن الحقيقي. لهذا السبب نجري أنواعاً عديدة من المعايير، بما في ذلك تلك الخاصة بالنموذج واللغة والمحتوى والمُحسِّن البشري .
لتحسين دقة النتائج، لديّ بعض التحسينات التي أودّ إدخالها على عملية توليد مجموعة المعايير. سأعتمد في المستقبل على اختيار عشوائي لمطالبات Chatbot Arena من مجموعة أكبر، بدلاً من استخدام نفس المطالبات لكل إصدار جديد. كما سأخفف معايير التصفية قليلاً للسماح بمطالبات أكثر تنوعاً، مثل الأسئلة التقنية، وسأضيف بعض المطالبات الإضافية إلى المجموعة لتنويع أنواع الاستجابات التي نتلقاها.
تعتبر منشورات المدونة هذه ذات أهمية منخفضة مقارنة بالتقرير الفني، لكن هذا لا يعني أنه لا ينبغي لنا أن نسعى إلى الدقة، حتى في الكون "ب".
الخلاصة
يتميز بانجرام بمقاومته العالية لتقنية Gemini 3.8 Flash عند استخدام عبارات اللغة الطبيعية، حيث يكتشفها بدقة ملحوظة تبلغ 99.80%. كما يكتشف تقنية Gemini 3.1 Pro بدقة ملحوظة تبلغ 99.70%، ليبلغ إجمالي دقة الكشف 99.75% (1995 من أصل 2000) في كلا النموذجين. يتميز بانجرام بقدرته على التعميم على النماذج الجديدة، لأن الإصدارات الجديدة تميل إلى استلهام الكثير من أسلوب وصوت الإصدارات السابقة ، لذا لا يحتاج بانجرام إلى إعادة تدريب مع كل إصدار جديد.
إليكم مقارنة بين جهازي Gemini 3.8 Flash و Gemini 3.1 Pro مع معاييرنا الخاصة بنماذج أخرى حديثة من الأجهزة الرائدة:
| نموذج | تم اكتشافه كذكاء اصطناعي | الدقة |
|---|---|---|
| جيميني 3.8 فلاش | 998/1000 | 99.80% |
| جيميني 3.1 برو | 997/1000 | 99.70% |
| كلود أوبوس 5.5 | 997/1000 | 99.70% |
| الأسطورة 5.1 | 1093/1097 | 99.64% |
| كلود، المقطوعة رقم 5 | 1105/1107 | 99.82% |
| GPT-5.6 | 3408/3423 | 99.56% |
| كلود سونيت 5 | 1145/1147 | 99.83% |
| جيميني 3 | 28/28 | 100% |
إذا كنت ترغب في التحقق من مستند معين، يمكنك تجربة موقع «بانغرام» هنا.
مقالات ذات صلة
أصبحت 3% من التعليقات التي تظهر على الصفحة الرئيسية لموقع أمازون من إنتاج الذكاء الاصطناعي
أظهرت أداة «بانغرام» عدم وجود أي نتائج إيجابية خاطئة في مجموعة متنوعة من مقالات الطلاب
تحليل متعمق لتعليقات يلب

أداء بانجرام على سرب من الوكلاء المتواطئين
الذكاء الاصطناعي يساعد في كتابة ما يقرب من 50% من البيانات الصحفية
تقييمات البانغرام من قبل أطراف ثالثة

