Ecco un breve riassunto
Su 2.215 prompt, Pangram 4.1 raggiunge un’accuratezza del 98,73% sui risultati di GPT-6.1 Sol con livello di ragionamento elevato e un’accuratezza del 98,83% con livello di ragionamento medio, per un’accuratezza complessiva del 98,78% in entrambe le impostazioni.
GPT-6.1 Sol è un modello di intelligenza artificiale rilasciato da OpenAI il 29 settembre 2026. OpenAI sostiene che GPT-6.1 Sol offra “un’intelligenza simile a quella di Astra a un quinto del prezzo” in varie attività lavorative, come la programmazione e l’uso del computer. A differenza delle versioni più recenti che abbiamo visto ultimamente, OpenAI non fa alcuna affermazione riguardo alle capacità di scrittura o alla chiarezza di GPT-6.1 Sol; quindi, scrive allo stesso modo dei modelli precedenti e Pangram è in grado di riconoscerlo?
Abbiamo testato le prestazioni di Pangram 4.1 su 2.215 prompt di esempio e abbiamo riscontrato che Pangram 4.1 ha classificato 6 output di GPT-6.1 Sol come "umani", 21 come "misti" e 2.188 come "generati interamente dall'IA", raggiungendo un'accuratezza del 98,78% su GPT-6.1 Sol.
| Modello | Esempi | Tasso di rilevamento |
|---|---|---|
| GPT-6.1 Sol (elevata capacità di ragionamento) | 1,105 | 98.73% |
| GPT-6.1 Sol (ragionamento medio) | 1,110 | 98.83% |
Per generare il set di riferimento, abbiamo utilizzato 1.200 prompt di primo turno tratti dal dataset LMSYS (Zheng et al., 2023). Successivamente, li abbiamo sottoposti a GPT-6.1 Sol con livelli di ragionamento medio e alto e abbiamo elaborato l'output tramite Pangram 4.1.
Risultati per categoria
Nel complesso, GPT-6.1 Sol ha registrato un tasso di falsi negativi dell'1,27% su 1.105 risposte relative al ragionamento di livello elevato e un tasso di falsi negativi dell'1,17% su 1.110 risposte relative al ragionamento di livello medio. Nel complesso, non è stata riscontrata una differenza significativa nel tasso di rilevamento tra il ragionamento di livello medio e quello di livello elevato (p=0,85).
Ragionamento di alto livello
Quando GPT-6.1 Sol è stato impostato sulla modalità di ragionamento avanzato, Pangram 4.1 ha classificato 3 risposte come umane, 11 come miste e 1.091 come interamente generate dall’IA, raggiungendo un tasso di richiamo del 98,73%.
| Categoria | Esempi | IA | Misto | Umano |
|---|---|---|---|---|
| Argomenti | 64 | 64 | 0 | 0 |
| E-mail / lettere | 53 | 52 | 1 | 0 |
| Saggi / articoli | 137 | 136 | 1 | 0 |
| Spiegazioni | 481 | 477 | 3 | 1 |
| Poesie e altri scritti creativi | 97 | 94 | 2 | 1 |
| Racconti | 89 | 89 | 0 | 0 |
| Programma e matematica | 10 | 10 | 0 | 0 |
| Giochi di ruolo e giochi | 42 | 42 | 0 | 0 |
| Altro | 132 | 127 | 4 | 1 |
| Totale | 1,105 | 1,091 | 11 | 3 |
Ragionamento di livello medio
Con un livello di ragionamento medio, il Pangram 4.1 ha classificato 3 risposte come umane, 10 come miste e 1.097 come interamente generate dall’IA, raggiungendo un tasso di richiamo del 98,83%.
| Categoria | Esempi | IA | Misto | Umano |
|---|---|---|---|---|
| Argomenti | 64 | 64 | 0 | 0 |
| E-mail / lettere | 55 | 55 | 0 | 0 |
| Saggi / articoli | 138 | 137 | 1 | 0 |
| Spiegazioni | 481 | 474 | 5 | 2 |
| Poesie e altri scritti creativi | 99 | 96 | 2 | 1 |
| Recensioni | 1 | 1 | 0 | 0 |
| Racconti | 85 | 85 | 0 | 0 |
| Programma e matematica | 10 | 10 | 0 | 0 |
| Giochi di ruolo e giochi | 42 | 42 | 0 | 0 |
| Altro | 135 | 133 | 2 | 0 |
| Totale | 1,110 | 1,097 | 10 | 3 |
Che ne pensi di Sol?
GPT-6.1 Sol presenta uno stile di punteggiatura caratteristico; ad esempio, utilizza l'apostrofo ricurvo nel 74% delle sue risposte e non ricorre quasi mai all'apostrofo dritto, soprattutto se confrontato con altri modelli recenti.
| GPT-6.1 Sol | Claude Haiku 5.5 | Gemini 4 Argon | |
|---|---|---|---|
| Apostrofo riccio ’ | 73.9% | 0.0% | 9.1% |
| Apostrofo dritto ' all'interno di una parola | 0.5% | 75.4% | 48.5% |
| Virgolette doppie ricurve “ ” | 39.0% | <0.1% | <0.1% |
Inoltre, predilige sia i trattini lunghi che quelli corti, utilizzando in media 1,3 trattini lunghi ogni 1.000 parole — molto più di Haiku 5.5 o Gemini 4 Argon.
| GPT-6.1 Sol | Claude Haiku 5.5 | Gemini 4 Argon | |
|---|---|---|---|
| Risposte con un trattino lungo — | 29.7% | 0.1% | 12.1% |
| Trattini lunghi ogni 1.000 parole | 1.32 | <0.01 | 0.85 |
| Risposte con il trattino corto – | 11.4% | 0.4% | 0.4% |
Nella scrittura creativa, GPT-6.1 Sol ha mostrato alcune peculiarità. Ha mostrato una forte preferenza nel chiamare i propri personaggi femminili Mara o Maya (almeno uno dei quali è apparso in 65 risposte) e, in generale, ha utilizzato le iniziali M.V., prediligendo soprattutto il cognome Vale (ma sono apparse anche Mara Velez e Mara Venn). Per quanto riguarda i nomi maschili, il preferito di GPT-6.1 Sol è Daniel, che ha abbinato a un cognome solo due volte (una volta con Vale e una volta con Mercer). Delle 418 risposte di scrittura creativa, GPT-6.1 Sol ha esordito con «Il primo...» 36 volte; una frequenza molto più alta rispetto a Haiku e Gemini, che lo hanno fatto rispettivamente 11 volte e 1 volta.
Sol ha rifiutato di rispondere a 23 richieste e ne ha parzialmente rifiutate altre 32. Nei casi di rifiuto parziale, Sol ha sostituito la richiesta con una versione edulcorata o diversa da quella originale. La maggior parte di questi rifiuti parziali è dovuta al fatto che la nostra serie di prompt includeva effettivamente richieste di scrittura creativa dal carattere allusivo. Sol ha gestito la situazione evitando di scrivere contenuti espliciti, scegliendo invece di “sfumare nel nero”.
A volte Sol scrive risposte molto brevi: 95 di meno di 50 parole al massimo, 90 a livello medio. La risposta mediana di Sol era di 300 parole, con un intervallo compreso tra 50 e 10.513 parole.
Test prestazionali precedenti
Pangram è resistente a GPT-6.1 Sol nei prompt in linguaggio naturale e lo rileva con un'accuratezza osservata del 98,73% nel ragionamento avanzato. Rileva GPT-6.1 Sol nel ragionamento medio con un'accuratezza osservata del 98,83%, per un totale combinato di 2.188 su 2.215 (98,78%) in entrambe le impostazioni. Pangram è in grado di generalizzare a nuovi modelli poiché le nuove versioni tendono a ereditare gran parte dello stile e della voce dei modelli precedenti; pertanto, Pangram non necessita di essere riaddestrato per ogni nuova versione.
Ecco come si posiziona GPT-6.1 Sol rispetto ai nostri benchmark relativi ad altri modelli all’avanguardia recenti:
| Modello | Rilevato come IA | Precisione |
|---|---|---|
| Claude Haiku 5.5 | 1.179/1.183 | 99.66% |
| Gemini 4 Argon | 1.159/1.174 | 98.72% |
| Gemini 3.8 Flash | 998/1.000 | 99.80% |
| Gemini 3.1 Pro | 997/1.000 | 99.70% |
| Claude Sonetto 5.5 | 1.019/1.022 | 99.71% |
| Claude Opus 5.5 | 997/1.000 | 99.70% |
| GPT-6 Astra | 982/986 | 99.59% |
| Favola 5.1 | 1.093/1.097 | 99.64% |
| Claude Opus 5 | 1.105/1.107 | 99.82% |
| GPT-5.6 | 3.408/3.423 | 99.56% |
| Claude Sonetto 5 | 1.145/1.147 | 99.83% |
Se vuoi verificare un documento specifico, puoi provare Pangram qui.
Annamieka è una redattrice tecnica presso Pangram.
Altre letture
Valutazioni di pangrammi effettuate da terzi
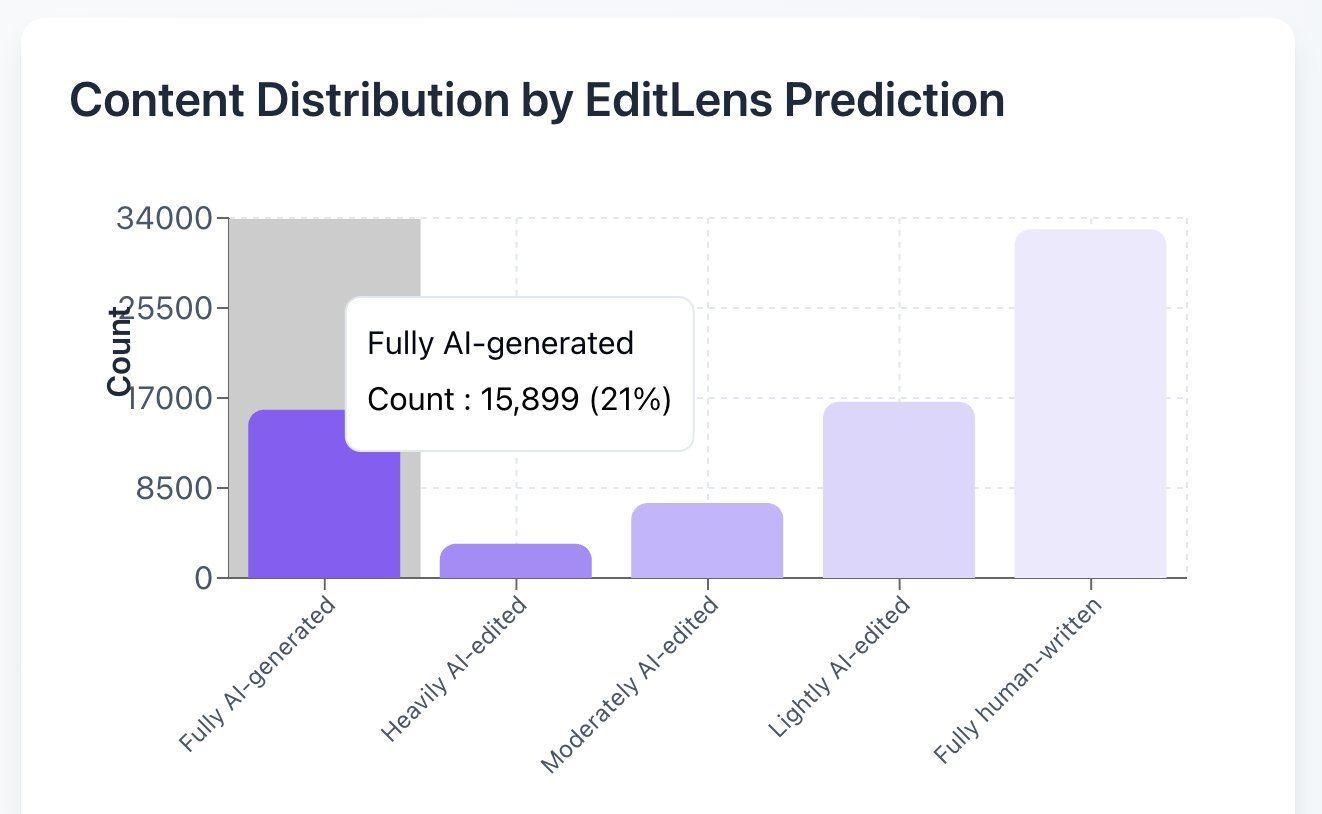
Pangram prevede che il 21% delle recensioni dell'ICLR sia generato dall'intelligenza artificiale
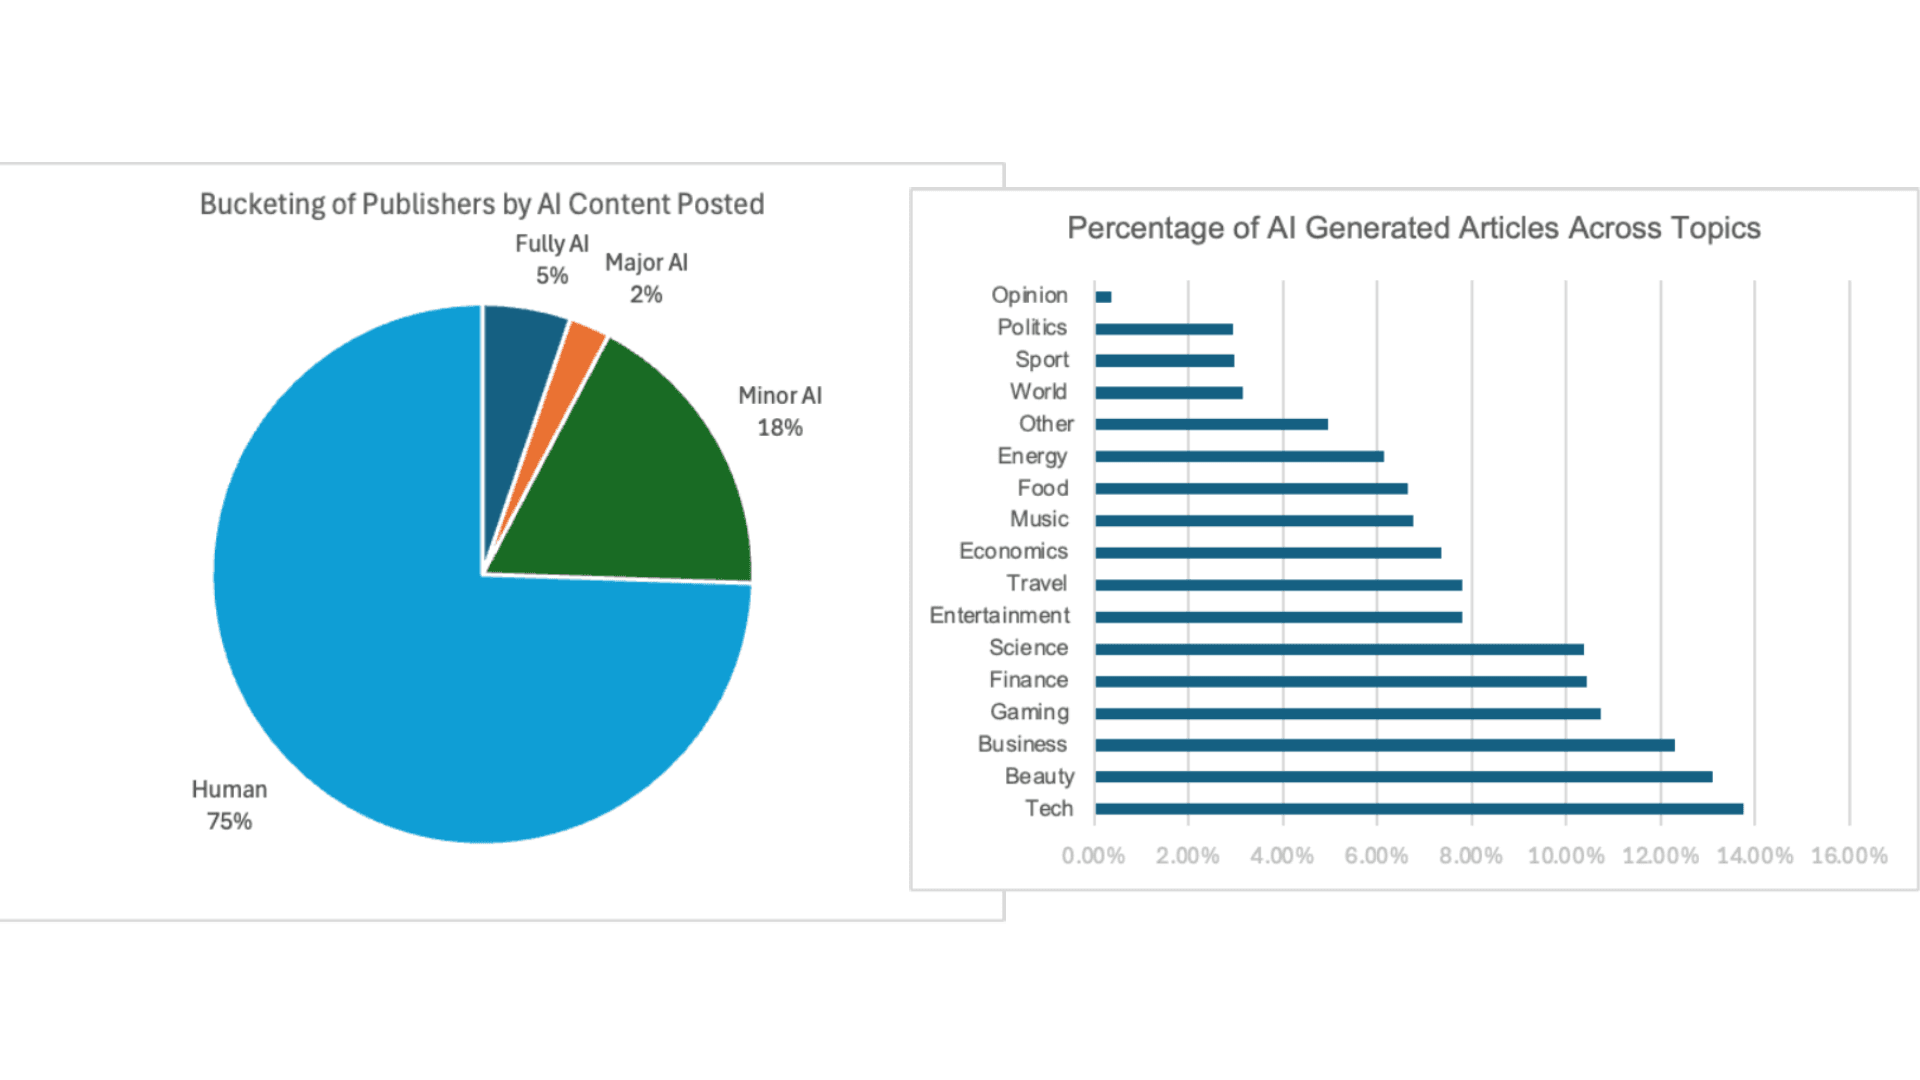
Ogni giorno vengono pubblicati 60.000 articoli di cronaca generati dall'intelligenza artificiale
In che modo Gradpilot utilizza Pangram per aiutare gli studenti a trovare la propria voce
L'intelligenza artificiale sta scrivendo romanzi premiati