Pangram è in grado di rilevare Gemini 3.8 Flash e Gemini 3.1 Pro?
Inoltre, una discussione sulla selezione dei parametri di riferimento, sulla distribuzione del campione e sul punto delle statistiche

Ecco un breve riassunto
Su 1.000 prompt, Pangram 4 raggiunge un'accuratezza del 99,80% sugli output di Gemini 3.8 Flash e un'accuratezza del 99,70% sugli output di Gemini 3.1 Pro, per un'accuratezza totale del 99,75% sull'ultima versione della famiglia Gemini per questo set di benchmark.
Su 1.000 esempi di linguaggio naturale, Pangram 4 ha classificato due output di Gemini 3.8 Flash come umani e 998 come completamente generati dall'IA, raggiungendo un'accuratezza del 99,80% su Gemini 3.8 Flash. Su Gemini 3.1 Pro (rilasciato il 19 febbraio 2026) Pangram ha classificato un output come misto, due come completamente umani e 997 come completamente generati dall'IA, raggiungendo un'accuratezza del 99,70% su Gemini 3.1 Pro.
Per generare il set di riferimento, ho utilizzato un sottoinsieme filtrato di prompt del primo turno di Chatbot Arena dal dataset LMSYS (Zheng et al., 2023). Ho filtrato i prompt che richiedevano codice, matematica, risposte molto brevi o molto lunghe o scrittura creativa inappropriata. Quindi li ho forniti a Gemini 3.8 Flash e Gemini 3.1 Pro e ho elaborato l'output con Pangram 4 .
Di seguito analizziamo i risultati del rilevamento per categoria, i falsi negativi, le prestazioni di Gemini 3.1 Pro nei benchmark precedenti e alcune lacune e possibili miglioramenti futuri della mia selezione di prompt per questo articolo.
Risultati per categoria
Ecco le prestazioni di Pangram 4 su 1.000 output di Gemini 3.8 Flash, suddivise per categoria di prompt (assegnato dagli agenti Haiku):
| Categoria | Esempi | IA | Misto | Umano |
|---|---|---|---|---|
| Argomenti | 18 | 18 | 0 | 0 |
| E-mail / lettere | 54 | 53 | 0 | 1 |
| Saggi / articoli | 33 | 33 | 0 | 0 |
| Spiegazioni | 563 | 563 | 0 | 0 |
| Poesie | 108 | 107 | 0 | 1 |
| Altri scritti creativi | 75 | 75 | 0 | 0 |
| Recensioni | 7 | 7 | 0 | 0 |
| Racconti | 142 | 142 | 0 | 0 |
| Totale | 1,000 | 998 | 0 | 2 |
Ecco i risultati per categoria per Gemini 3.1 Pro:
| Categoria | Esempi | IA | Misto | Umano |
|---|---|---|---|---|
| Argomenti | 18 | 18 | 0 | 0 |
| E-mail / lettere | 55 | 55 | 0 | 0 |
| Saggi / articoli | 33 | 33 | 0 | 0 |
| Spiegazioni | 559 | 559 | 0 | 0 |
| Poesie e altri scritti creativi | 182 | 179 | 1 | 2 |
| Recensioni | 7 | 7 | 0 | 0 |
| Racconti | 146 | 146 | 0 | 0 |
| Totale | 1,000 | 997 | 1 | 2 |
Uno dei falsi negativi di Gemini 3.8 Flash si è verificato in una richiesta al modello di umanizzare gli output , aggiungendo errori di ortografia e refusi:
Scrivi una lettera con errori di battitura e di ortografia a un clan di raid shadow legends (sono un nuovo giocatore di livello 10) chiamato HelpWanted. Deve essere una lettera breve e molto persuasiva.
Pangram 4 ha mancato entrambe le versioni di Penguinmandias dei modelli, proprio come quando è stato generato da Opus 5.5 . Il prompt è:
Scrivimi una poesia su Club Penguin nello stile di Ozymandias.
Per Gemini 3.1 Pro, il 71% delle parole di Penguinmandias sono in comune con la poesia originale di Shelley, quindi penso che si tratti di un falso negativo di scarsa rilevanza. Gemini 3.1 Pro ha prodotto anche altri due errori, entrambi relativi a poesie.
Cosa rende un risultato di riferimento?
Nel nostro rapporto tecnico su Pangram 4, abbiamo eseguito un test sui falsi negativi su 520.000 output di IA provenienti da 26 modelli diversi, ovvero 20.000 risposte per modello. Uno dei modelli testati nel rapporto era Gemini 3.1 Pro, che abbiamo testato anche qui. Tuttavia, come potrete constatare consultando il rapporto tecnico, abbiamo riscontrato un tasso di falsi negativi diverso e più elevato su quel set di output rispetto a questo. Perché?
Una possibile risposta è che, statisticamente, non presentano differenze significative. I 3 errori su 1.000 risposte che abbiamo riscontrato si traducono in un FNR osservato dello 0,3%, con un intervallo di confidenza al 95% compreso tra lo 0,06% e lo 0,87%. L'FNR riportato nel rapporto tecnico è di 111 errori su 20.000 richieste, ovvero un FNR dello 0,555%, che rientra in tale intervallo.
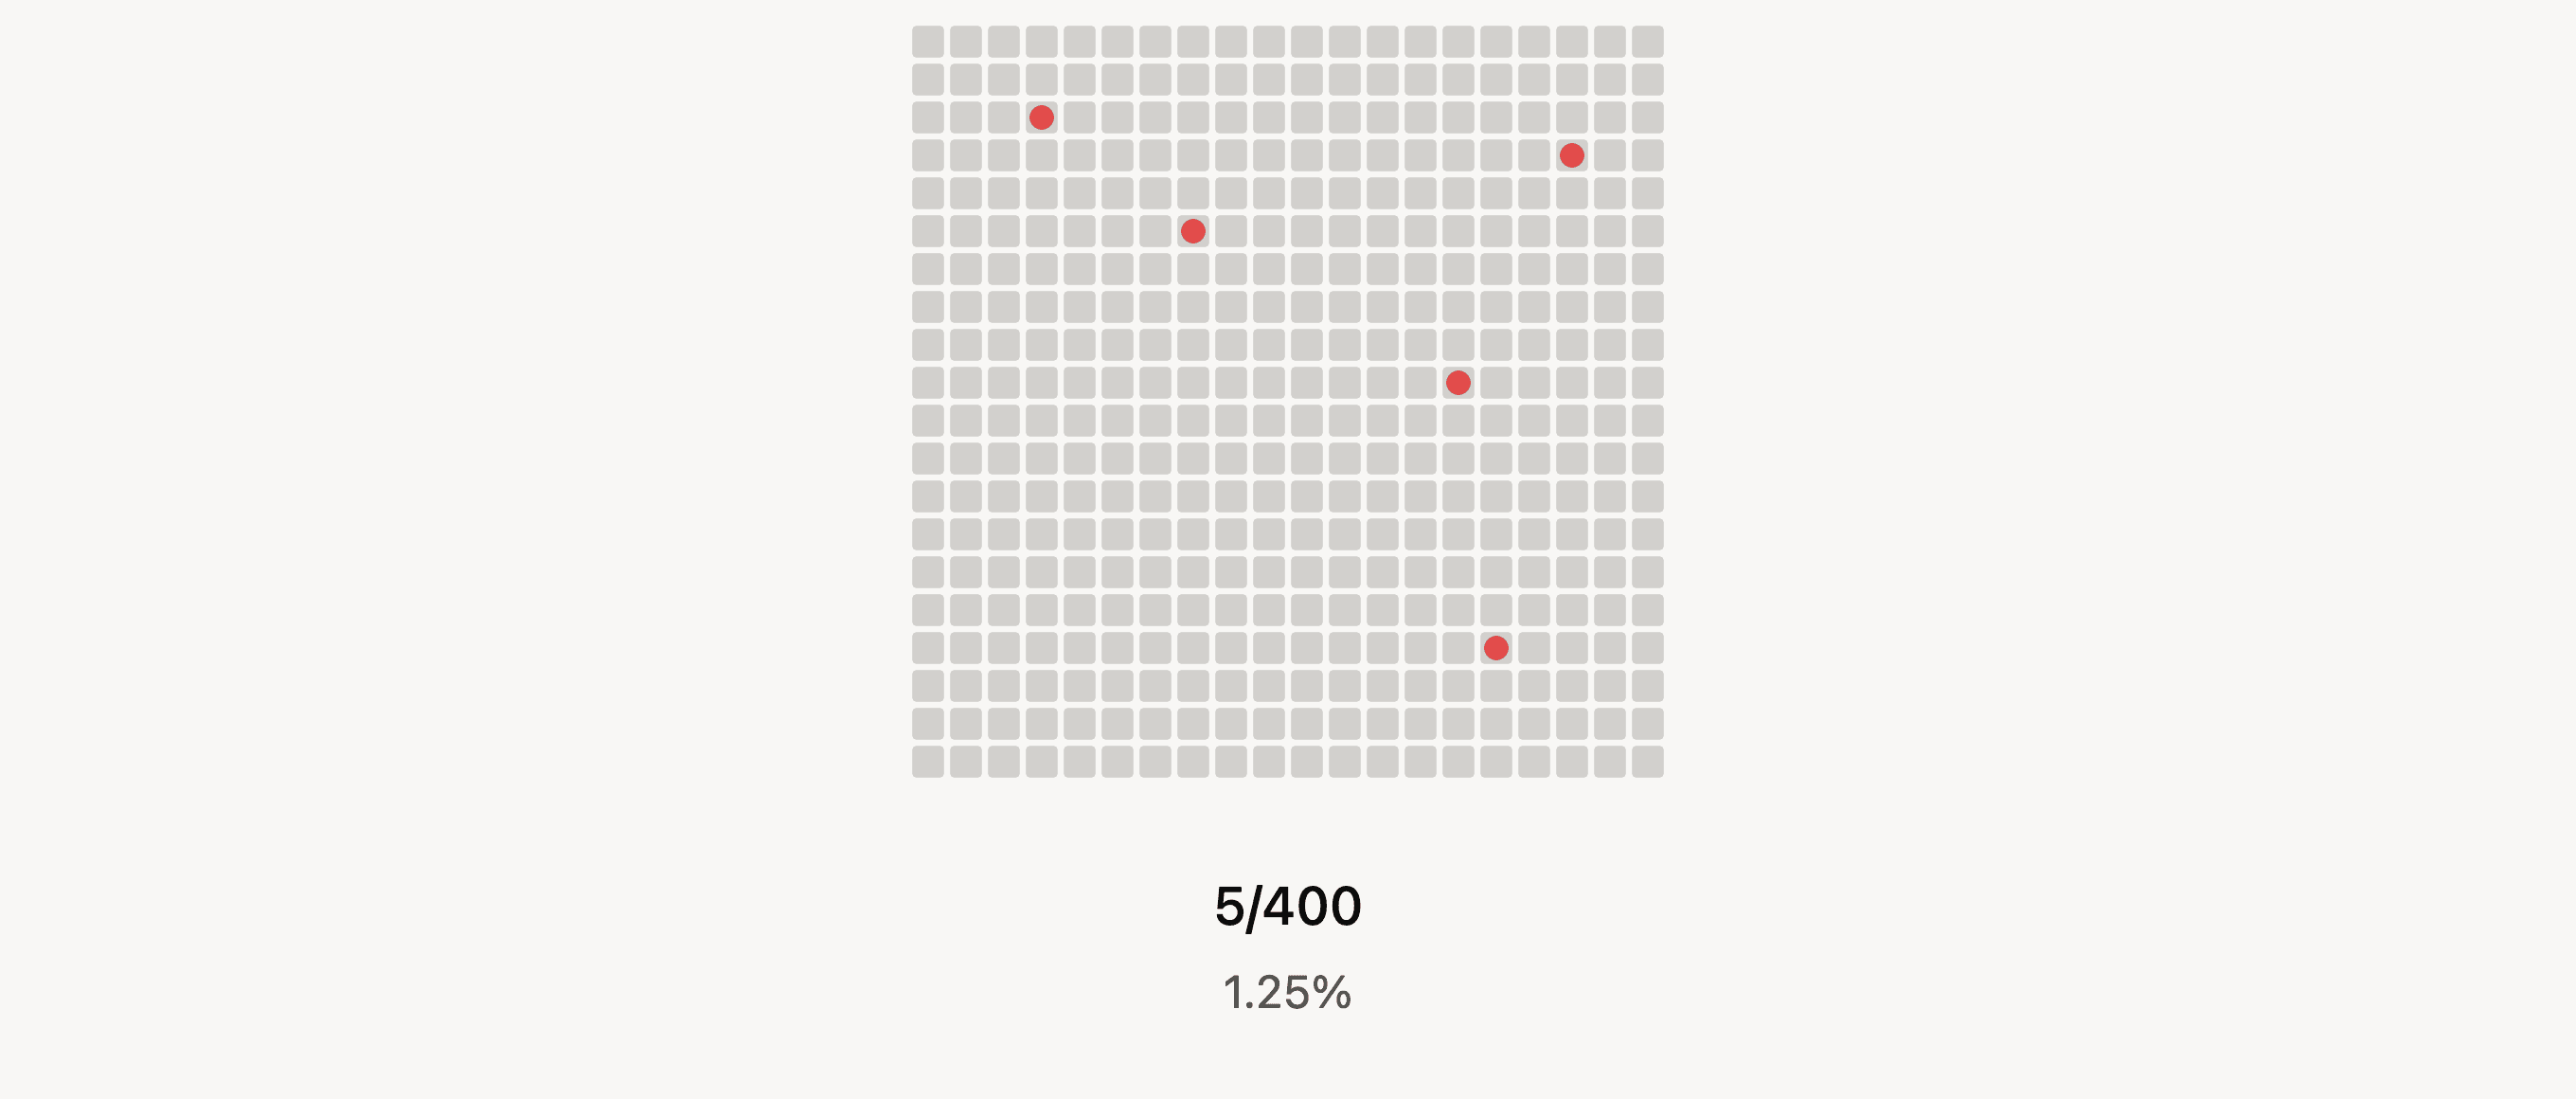
Ma cosa intendo quando dico che questi numeri non sono statisticamente diversi? Supponiamo di avere un ampio set di 400 casi di test che so a priori essere positivi, e di voler verificare se un rilevatore li etichetta correttamente come positivi o se ne etichetta erroneamente alcuni come negativi. Nell'universo A, testo tutti i 400 esempi e scopro che 5 sono etichettati erroneamente come negativi (rappresentati qui sotto da punti rossi), il che si traduce in un tasso di falsi negativi dell'1,25% per il mio rilevatore sull'intero set. Ottimo!
Nell'universo B, invece, per un motivo o per l'altro ho risorse limitate. Posso permettermi di testare solo una piccola parte dei 400 esempi. Ciò significa che devo prendere un campione, idealmente casuale, ed eseguire i test su quello. Supponiamo di poter testare 40 esempi, ovvero il 10% del mio set totale. Di seguito sono riportati tre diversi modi in cui potrei selezionare tale set, ognuno dei quali produce un diverso tasso di falsi negativi.
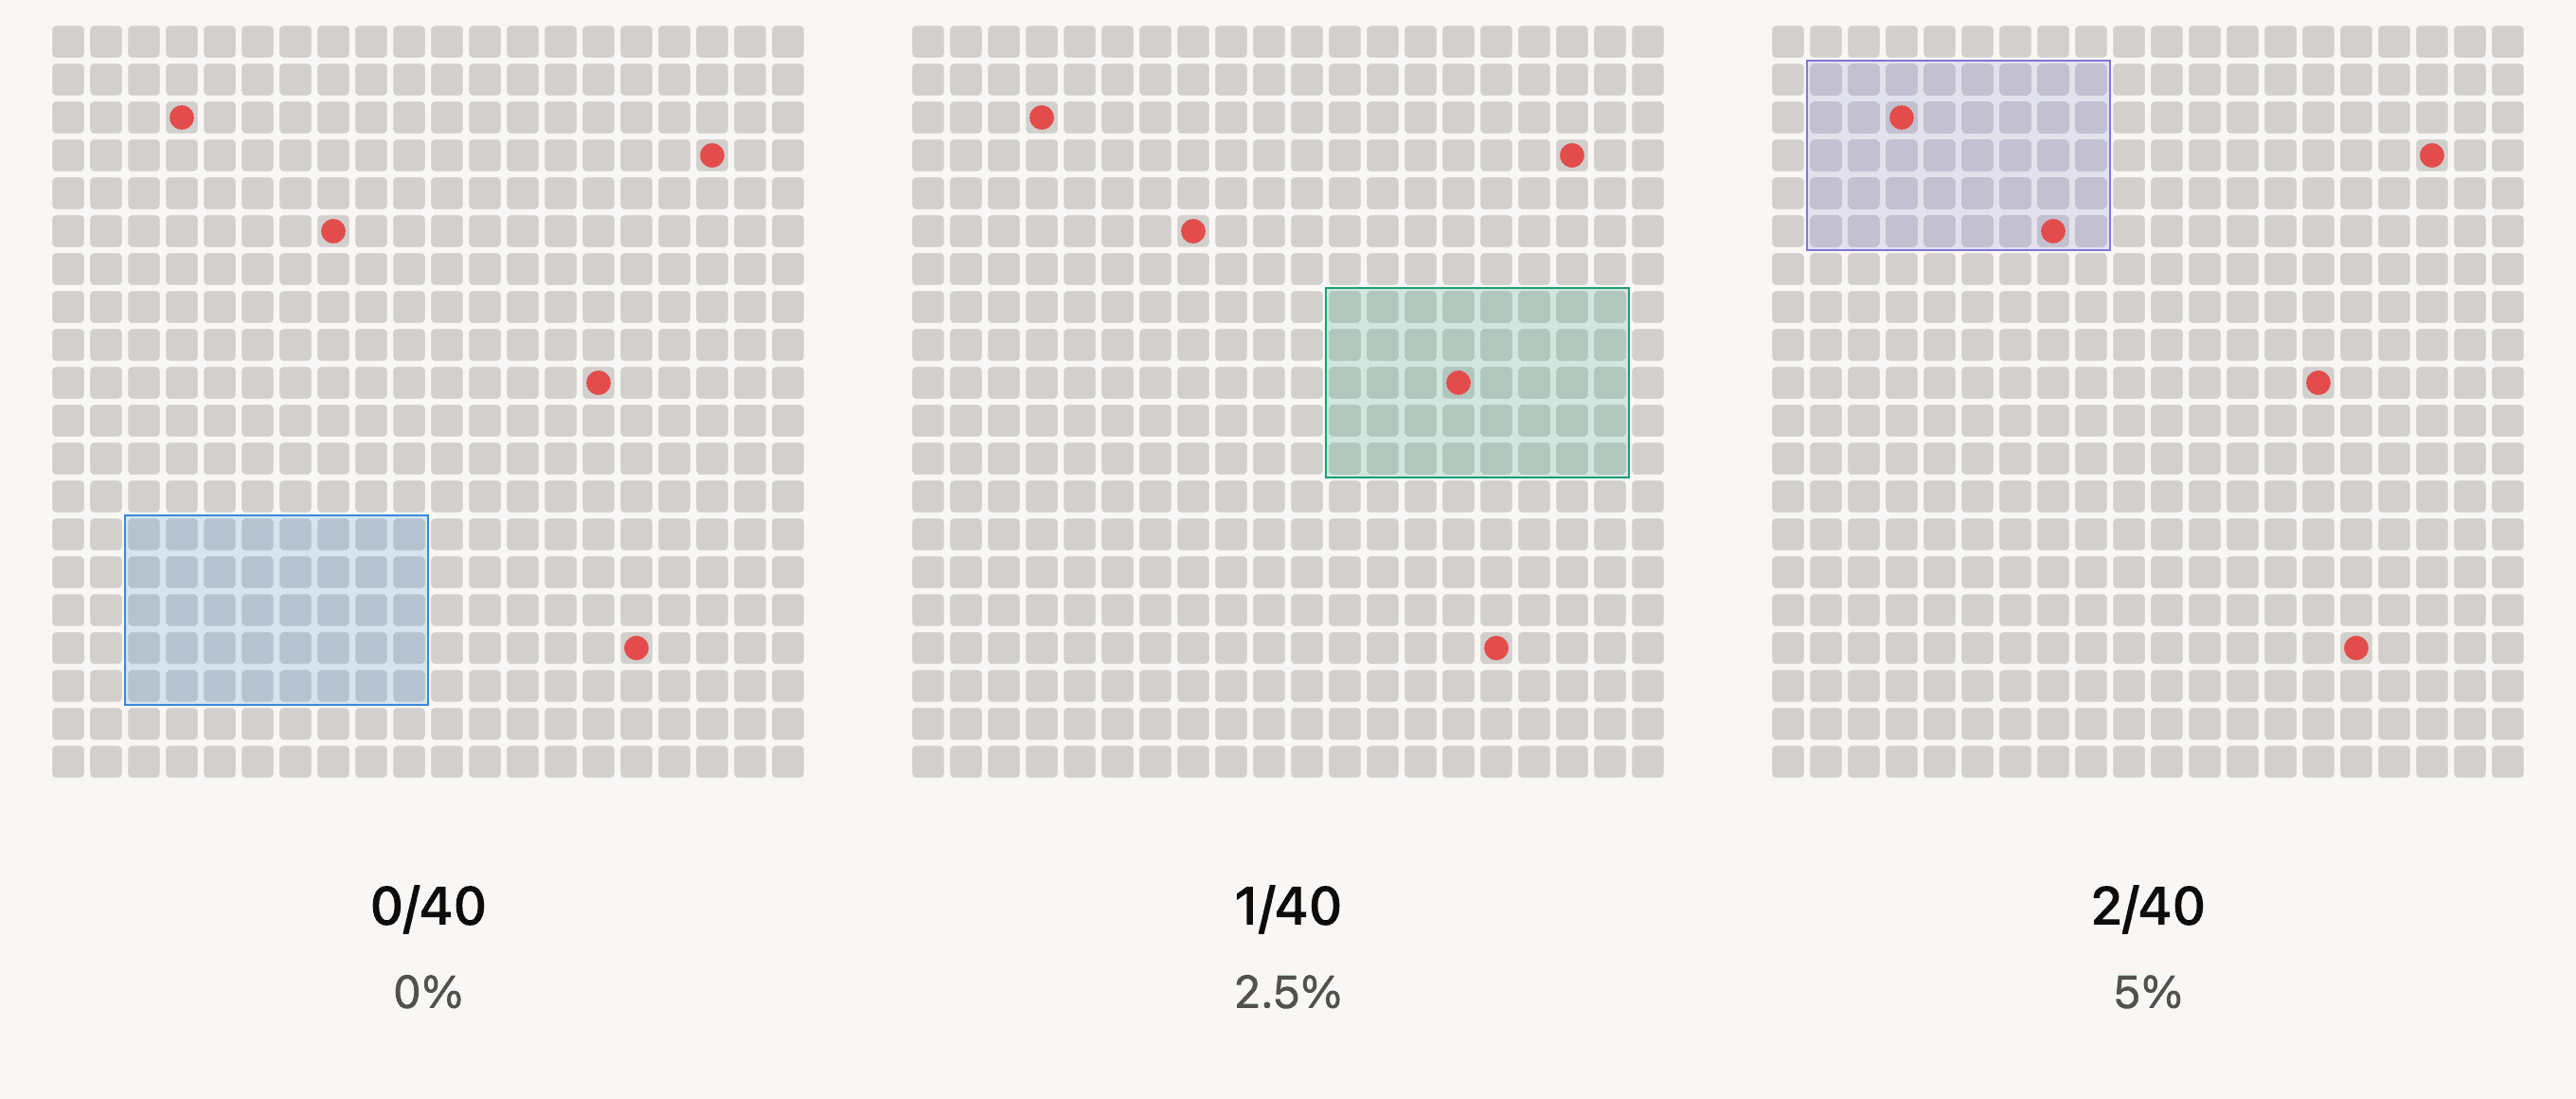
Ciascuno di questi campioni riporta un diverso tasso di falsi negativi, e nessuno di essi si allinea con il tasso di falsi negativi "reale" del rilevatore, pari all'1,25%, a cui avevamo accesso nell'universo A. In teoria, un campione casuale di 40 quadrati in questa griglia dovrebbe catturare mezzo punto rosso, ma a seconda del campionamento, potrebbe non catturare alcun punto rosso, come nel campione blu, un punto rosso o due punti rossi, come in quello viola. Un campione particolarmente sfortunato potrebbe catturare tutti i punti rossi, e in quel caso il tasso di falsi negativi osservato sarebbe pari a 5/40, ovvero il 12,5%.
Un campione così sfortunato è comunque molto improbabile. Un campione casuale del 10% dell'insieme troverà tra 0 e 2 punti nel 99% dei casi: questo intervallo deriva da quella che viene chiamata distribuzione campionaria. In pratica, ciò significa che la dimensione del campione dell'universo B, pari a 40 casi su un totale di 400, non è in grado di distinguere tra un tasso di falsi negativi dello 0% e un tasso di falsi negativi del 5%. Più grande è il campione, più piccolo è questo intervallo: se invece campionassimo, ad esempio, 125 punti su un totale di 400, troveremmo tra 0 e 4 punti nel 99% dei casi, ovvero un tasso di falsi negativi osservato compreso tra lo 0% e il 3,2%.
La stessa logica può essere applicata ai nostri benchmark Gemini 3.1 Pro, e i due diversi risultati falsi negativi non sono in contraddizione. Tuttavia, la differenza potrebbe comunque farvi chiedere a quale dei due dare maggiore fiducia. In genere, il criterio guida per decidere è la dimensione del campione: un campione più ampio significa un quadro più rappresentativo e una gamma più ristretta di possibili errori. Quindi, seguendo questa logica, dovreste fidarvi maggiormente del benchmark del report tecnico e considerare questo risultato solo come un'indicazione.
Esistono altri modi in cui due risultati di benchmark potrebbero differire. A differenza dell'esempio della griglia, il set di benchmark che ho utilizzato non è un sottoinsieme rigoroso dei 20.000 prompt di Chatbot Arena utilizzati nel rapporto tecnico: in totale, i due benchmark di Gemini 3.1 Pro condividevano 286 prompt identici. Ciò lascia aperta la possibilità che 714 delle domande di benchmark che ho utilizzato potessero essere più favorevoli alla produzione di output di IA rilevabili rispetto a quelle utilizzate nel rapporto tecnico di Pangram 4.
Non sembra essere questo il caso. Entrambi i set escludono altre lingue, matematica e output di programmazione. Tuttavia, ci sono delle differenze: il numero mediano di parole per risposta Gemini 3.1 Pro era più alto nel mio set rispetto al set di report tecnici, e i testi più lunghi sono più facili da valutare, come sappiamo . Ma quale dei due rappresenta un test più equo del modello? Se controllassimo la lunghezza dell'output e la dimensione del campione, quale set di prompt rappresenterebbe meglio l'universo A?
La vera risposta è che non lo so e non posso dirlo. È difficile, quasi impossibile, creare un insieme che sia perfettamente e esattamente rappresentativo del mondo reale. Questo è il limite fondamentale della statistica. In realtà, ogni benchmark è un minuscolo quadratino in un mosaico di campioni che approssimano la realtà sottostante dell'universo A, ovvero il mondo "là fuori". In un certo senso, questo fatto potrebbe essere interpretato nel senso che tutti i risultati dei benchmark sono sbagliati, il che non è falso, ma ciò non significa che non siano utili. Mettendo insieme molti risultati diversi su molti tipi diversi di insiemi, possiamo avvicinarci a una buona approssimazione della vera realtà sottostante. Ecco perché eseguiamo molti tipi diversi di benchmark, inclusi quelli specifici per modello, lingua , contenuto e umanizzatore .
Per ottenere un'approssimazione migliore, ho in mente alcuni miglioramenti da apportare al mio processo di generazione del set di riferimento. In futuro, randomizzerò la selezione dei prompt di Chatbot Arena da un set più ampio, anziché utilizzare gli stessi prompt per ogni rilascio del modello. Inoltre, allenterò leggermente i filtri per consentire prompt più vari, come domande tecniche, e aggiungerò alcuni prompt extra al pool per diversificare il tipo di risposta che otteniamo.
Questi post del blog hanno una posta in gioco inferiore rispetto al rapporto tecnico, ma ciò non significa che non dovremmo puntare al rigore, anche nell'universo B.
Conclusione
Pangram è robusto con Gemini 3.8 Flash per i prompt in linguaggio naturale e lo rileva con un'accuratezza osservata del 99,80%. Rileva Gemini 3.1 Pro con un'accuratezza osservata del 99,70%, per un totale combinato di 1.995 su 2.000 (99,75%) su entrambi i modelli. Pangram è in grado di generalizzare ai nuovi modelli perché le nuove versioni tendono a ereditare gran parte dello stile e della voce dei loro predecessori , quindi Pangram non ha bisogno di essere riaddestrato per ogni nuova versione.
Ecco un confronto tra Gemini 3.8 Flash e Gemini 3.1 Pro e i nostri benchmark di altri modelli di punta recenti:
| Modello | Rilevato come IA | Precisione |
|---|---|---|
| Gemini 3.8 Flash | 998/1.000 | 99.80% |
| Gemini 3.1 Pro | 997/1.000 | 99.70% |
| Claude Opus 5.5 | 997/1.000 | 99.70% |
| Favola 5.1 | 1.093/1.097 | 99.64% |
| Claude Opus 5 | 1.105/1.107 | 99.82% |
| GPT-5.6 | 3.408/3.423 | 99.56% |
| Claude Sonetto 5 | 1.145/1.147 | 99.83% |
| Gemini 3 | 28/28 | 100% |
Se vuoi verificare un documento specifico, puoi provare Pangram qui.
Annamieka è una redattrice tecnica presso Pangram.
Altre letture
Il 3% delle recensioni in prima pagina su Amazon è ora generato dall'intelligenza artificiale
Pangram non rileva alcun falso positivo in una serie di saggi scritti da studenti con background diversi
Analisi approfondita delle recensioni su Yelp

Prestazioni di Pangram su uno sciame di agenti collusi
L'intelligenza artificiale contribuisce alla stesura di quasi il 50% dei comunicati stampa
Valutazioni di pangrammi effettuate da terzi

