Eis um breve resumo
De um total de 2 215 prompts, o Pangram 4.1 atinge uma precisão de 98,73% nas respostas do GPT-6.1 Sol no nível de raciocínio elevado e uma precisão de 98,83% no nível de raciocínio médio, o que resulta numa precisão total de 98,78% em ambas as configurações.
O GPT-6.1 Sol é um modelo de IA lançado pela OpenAI a 29 de setembro de 2026. A OpenAI afirma que o GPT-6.1 Sol oferece «inteligência quase ao nível do Astra por um quinto do preço» em várias tarefas relacionadas com o trabalho, como programação e utilização de computadores. Ao contrário dos lançamentos mais recentes a que temos assistido ultimamente, a OpenAI não faz quaisquer afirmações sobre a capacidade de escrita ou a clareza do GPT-6.1 Sol; assim, será que escreve da mesma forma que os modelos anteriores e será que o Pangram consegue detetá-lo?
Testámos o desempenho do Pangram 4.1 em 2 215 exemplos de prompts e constatámos que o Pangram 4.1 classificou 6 respostas do GPT-6.1 Sol como sendo de autoria humana, 21 como mistas e 2 188 como totalmente geradas por IA, alcançando uma precisão de 98,78% no GPT-6.1 Sol.
| Modelo | Exemplos | Taxa de deteção |
|---|---|---|
| GPT-6.1 Sol (alto nível de raciocínio) | 1,105 | 98.73% |
| GPT-6.1 Sol (raciocínio médio) | 1,110 | 98.83% |
Para gerar o conjunto de referência, utilizámos 1 200 prompts de primeira resposta do conjunto de dados LMSYS (Zheng et al., 2023). Em seguida, submetemos esses prompts ao GPT-6.1 Sol, com os níveis de raciocínio médio e elevado, e processámos os resultados através do Pangram 4.1.
Resultados por categoria
No geral, o GPT-6.1 Sol apresentou uma taxa de falsos negativos de 1,27 % em 1 105 respostas no nível de raciocínio elevado e uma taxa de falsos negativos de 1,17 % em 1 110 respostas no nível de raciocínio médio. No geral, não se verificou uma diferença significativa na taxa de deteção entre os níveis de raciocínio médio e elevado (p = 0,85).
Raciocínio avançado
Quando o GPT-6.1 Sol foi configurado para um nível elevado de raciocínio, o Pangram 4.1 classificou 3 respostas como humanas, 11 como mistas e 1 091 como totalmente geradas por IA, atingindo uma taxa de recuperação de 98,73%.
| Categoria | Exemplos | IA | Misto | Humano |
|---|---|---|---|---|
| Argumentos | 64 | 64 | 0 | 0 |
| E-mails / cartas | 53 | 52 | 1 | 0 |
| Ensaios / artigos | 137 | 136 | 1 | 0 |
| Explicações | 481 | 477 | 3 | 1 |
| Poemas e outros textos criativos | 97 | 94 | 2 | 1 |
| Histórias | 89 | 89 | 0 | 0 |
| Programação e matemática | 10 | 10 | 0 | 0 |
| Dramatizações e jogos | 42 | 42 | 0 | 0 |
| Outros | 132 | 127 | 4 | 1 |
| Total | 1,105 | 1,091 | 11 | 3 |
Raciocínio médio
No raciocínio de nível médio, o Pangram 4.1 classificou 3 respostas como humanas, 10 como mistas e 1 097 como totalmente geradas por IA, alcançando uma taxa de recuperação de 98,83%.
| Categoria | Exemplos | IA | Misto | Humano |
|---|---|---|---|---|
| Argumentos | 64 | 64 | 0 | 0 |
| E-mails / cartas | 55 | 55 | 0 | 0 |
| Ensaios / artigos | 138 | 137 | 1 | 0 |
| Explicações | 481 | 474 | 5 | 2 |
| Poemas e outros textos criativos | 99 | 96 | 2 | 1 |
| Críticas | 1 | 1 | 0 | 0 |
| Histórias | 85 | 85 | 0 | 0 |
| Programação e matemática | 10 | 10 | 0 | 0 |
| Dramatizações e jogos | 42 | 42 | 0 | 0 |
| Outros | 135 | 133 | 2 | 0 |
| Total | 1,110 | 1,097 | 10 | 3 |
O que achas do nome Sol?
O GPT-6.1 Sol tem um estilo de pontuação característico; por exemplo, utiliza apóstrofos curvos em 74% das suas respostas e quase nunca utiliza apóstrofos retos, especialmente quando comparado com outros modelos recentes.
| GPT-6.1 Sol | Claude Haiku 5.5 | Gemini 4 Argon | |
|---|---|---|---|
| Apostrofo curvo ’ | 73.9% | 0.0% | 9.1% |
| Apostrofo reto ' no meio de uma palavra | 0.5% | 75.4% | 48.5% |
| Aspas duplas curvas “ ” | 39.0% | <0.1% | <0.1% |
Além disso, gosta muito tanto de travessões longos como de travessões curtos, utilizando, em média, 1,3 travessões longos por cada 1 000 palavras — muito mais do que o Haiku 5.5 ou o Gemini 4 Argon.
| GPT-6.1 Sol | Claude Haiku 5.5 | Gemini 4 Argon | |
|---|---|---|---|
| Respostas com um travessão — | 29.7% | 0.1% | 12.1% |
| Traços por cada 1 000 palavras | 1.32 | <0.01 | 0.85 |
| Respostas com um traço curto – | 11.4% | 0.4% | 0.4% |
Na escrita criativa, o GPT-6.1 Sol revelou alguns hábitos recorrentes. Mostrou uma forte preferência por dar aos seus personagens femininos os nomes Mara ou Maya (pelo menos um dos quais apareceu em 65 respostas) e, geralmente, atribuía-lhes as iniciais M.V., preferindo sobretudo o apelido Vale (embora também tenham surgido Mara Velez e Mara Venn). Quanto aos nomes próprios masculinos, o favorito do GPT-6.1 Sol é Daniel, que apenas duas vezes associou a um apelido (uma vez com Vale e outra com Mercer). Das 418 respostas de escrita criativa, o GPT-6.1 Sol iniciou com «O primeiro...» 36 vezes; uma frequência muito superior à do Haiku e do Gemini, que o fizeram 11 e 1 vezes, respetivamente.
O Sol recusou-se a responder a 23 pedidos e recusou parcialmente outros 32. No caso das recusas parciais, o Sol substituiu o pedido por uma versão mais moderada ou diferente do que tinha sido solicitado. A maioria destas recusas parciais deve-se ao facto de o nosso conjunto de prompts incluir, por acaso, pedidos de escrita criativa de caráter sugestivo. O Sol lidou com esta situação evitando escrever conteúdo explícito, optando, em vez disso, por um «fade to black».
O Sol escreve, por vezes, respostas muito curtas: 95 com menos de 50 palavras no nível elevado e 90 no nível médio. A mediana das respostas do Sol foi de 300 palavras, variando entre 50 e 10 513 palavras.
Testes de desempenho anteriores
O Pangram demonstra robustez face ao GPT-6.1 Sol em prompts de linguagem natural e deteta-o com uma precisão observada de 98,73% no nível de raciocínio elevado. Deteta o GPT-6.1 Sol no nível de raciocínio médio com uma precisão observada de 98,83%, totalizando 2 188 em 2 215 (98,78%) em ambas as configurações. O Pangram é capaz de generalizar para novos modelos porque os novos lançamentos tendem a herdar grande parte do estilo e da voz dos seus antecessores, pelo que o Pangram não precisa de ser retreinado para cada novo lançamento.
Eis uma comparação entre o GPT-6.1 Sol e os nossos testes de desempenho de outros modelos de vanguarda recentes:
| Modelo | Detetado como IA | Precisão |
|---|---|---|
| Claude Haiku 5.5 | 1 179/1 183 | 99.66% |
| Gemini 4 Argon | 1 159/1 174 | 98.72% |
| Gemini 3.8 Flash | 998/1.000 | 99.80% |
| Gemini 3.1 Pro | 997/1.000 | 99.70% |
| Soneto 5.5 de Claude | 1.019/1.022 | 99.71% |
| Claude Opus 5.5 | 997/1.000 | 99.70% |
| GPT-6 Astra | 982/986 | 99.59% |
| Fábula 5.1 | 1.093/1.097 | 99.64% |
| Claude Opus 5 | 1.105/1.107 | 99.82% |
| GPT-5.6 | 3.408/3.423 | 99.56% |
| Claude Soneto 5 | 1.145/1.147 | 99.83% |
Se quiseres consultar um documento específico, podes experimentar o Pangram aqui.
Leitura relacionada
Avaliações de pangramas realizadas por terceiros
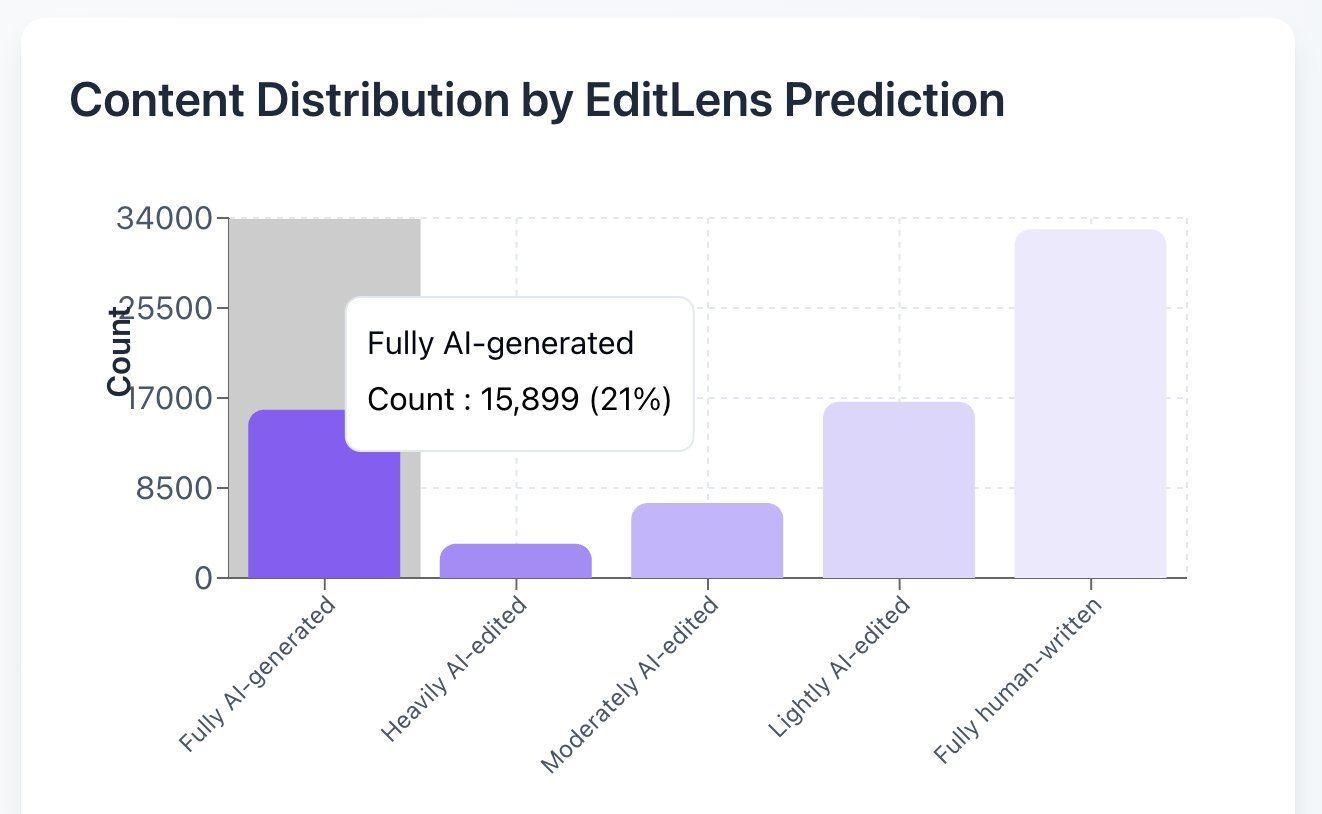
A Pangram prevê que 21% das revisões da ICLR são geradas por IA
Todos os dias são publicados 60 000 artigos noticiosos gerados por IA
Como o Gradpilot utiliza o Pangram para ajudar os alunos a encontrar a sua voz
A IA está a escrever obras de ficção premiadas