O Pangram consegue detectar o Gemini 3.8 Flash e o Gemini 3.1 Pro?
Além disso, haverá uma discussão sobre a seleção dos parâmetros de referência, distribuição da amostra e a importância da estatística.

Eis um breve resumo
Em 1.000 tentativas, o Pangram 4 alcançou uma precisão de 99,80% nas saídas do Gemini 3.8 Flash e uma precisão de 99,70% nas saídas do Gemini 3.1 Pro, totalizando uma precisão de 99,75% na versão mais recente da família Gemini para este conjunto de testes de desempenho.
De 1.000 exemplos de linguagem natural, o Pangram 4 classificou duas saídas do Gemini 3.8 Flash como humanas e 998 como totalmente geradas por IA, atingindo uma precisão de 99,80% no Gemini 3.8 Flash. No Gemini 3.1 Pro (lançado a 19 de fevereiro de 2026), o Pangram classificou uma saída como mista, duas como totalmente humanas e 997 como totalmente geradas por IA, atingindo uma precisão de 99,70% no Gemini 3.1 Pro.
Para gerar o conjunto de benchmarks, utilizei um subconjunto filtrado de prompts da primeira ronda do Chatbot Arena, provenientes do conjunto de dados LMSYS (Zheng et al., 2023). Filtrei os avisos que solicitavam código, matemática, respostas demasiado curtas ou demasiado longas, ou escrita criativa inadequada. De seguida, utilizei estes prompts no Gemini 3.8 Flash e no Gemini 3.1 Pro e processei os resultados através do Pangram 4 .
A seguir, discutimos os resultados da deteção por categoria, os falsos negativos, o desempenho do Gemini 3.1 Pro em benchmarks anteriores e algumas deficiências e melhorias futuras da minha sugestão para o post do blogue.
Resultados por categoria
De acordo com a categoria de pedido (atribuída pelos agentes da Haiku), veja como se comportou o Pangram 4 em 1.000 saídas Flash do Gemini 3.8:
| Categoria | Exemplos | IA | Misto | Humano |
|---|---|---|---|---|
| Argumentos | 18 | 18 | 0 | 0 |
| E-mails / cartas | 54 | 53 | 0 | 1 |
| Ensaios / artigos | 33 | 33 | 0 | 0 |
| Explicações | 563 | 563 | 0 | 0 |
| Poemas | 108 | 107 | 0 | 1 |
| Outros textos de criação literária | 75 | 75 | 0 | 0 |
| Críticas | 7 | 7 | 0 | 0 |
| Histórias | 142 | 142 | 0 | 0 |
| Total | 1,000 | 998 | 0 | 2 |
E aqui estão os resultados por categoria para o Gemini 3.1 Pro:
| Categoria | Exemplos | IA | Misto | Humano |
|---|---|---|---|---|
| Argumentos | 18 | 18 | 0 | 0 |
| E-mails / cartas | 55 | 55 | 0 | 0 |
| Ensaios / artigos | 33 | 33 | 0 | 0 |
| Explicações | 559 | 559 | 0 | 0 |
| Poemas e outros textos criativos | 182 | 179 | 1 | 2 |
| Críticas | 7 | 7 | 0 | 0 |
| Histórias | 146 | 146 | 0 | 0 |
| Total | 1,000 | 997 | 1 | 2 |
Um dos falsos negativos do Gemini 3.8 Flash ocorreu num pedido que pedia ao modelo para humanizar as respostas , acrescentando erros ortográficos e de digitação:
Escreve uma carta com gralhas e erros ortográficos para um clã de Raid Shadow Legends (sou um jogador novo, nível 10) chamado HelpWanted. Faça uma carta curta e muito persuasiva.
O pangrama 4 não identificou as duas versões do Penguinmandias geradas pelos modelos, tal como quando foi gerado pelo Opus 5.5 . O prompt é:
Escreve-me um poema do Club Penguin ao estilo de Ozymandias.
Para o Gemini 3.1 Pro, 71% das palavras em "Penguinmandias" são partilhadas com o poema original de Shelley, pelo que penso que este é um falso negativo de baixa preocupação. O Gemini 3.1 Pro apresentou ainda outros dois falsos negativos, ambos poemas.
O que caracteriza um resultado de referência?
No nosso relatório técnico sobre o Pangram 4, realizámos um teste de falsos negativos em 520.000 saídas de IA de 26 modelos diferentes, ou 20.000 respostas por modelo. Um desses modelos testados no relatório foi o Gemini 3.1 Pro, que também testámos aqui. No entanto, como verá ao consultar o relatório técnico, encontrámos uma taxa de falsos negativos diferente e mais elevada neste conjunto de saídas do que neste conjunto. Por quê?
Uma resposta possível é que, estatisticamente, não há diferença. Os 3 erros em 1000 respostas que aqui encontrámos correspondem a uma taxa de falsos negativos (FNR) observada de 0,3%, com um intervalo de confiança de 95% entre 0,06% e 0,87%. A FNR que consta no relatório técnico é de 111 erros em 20.000 pedidos, ou uma FNR de 0,555%, que se encontra dentro deste intervalo.
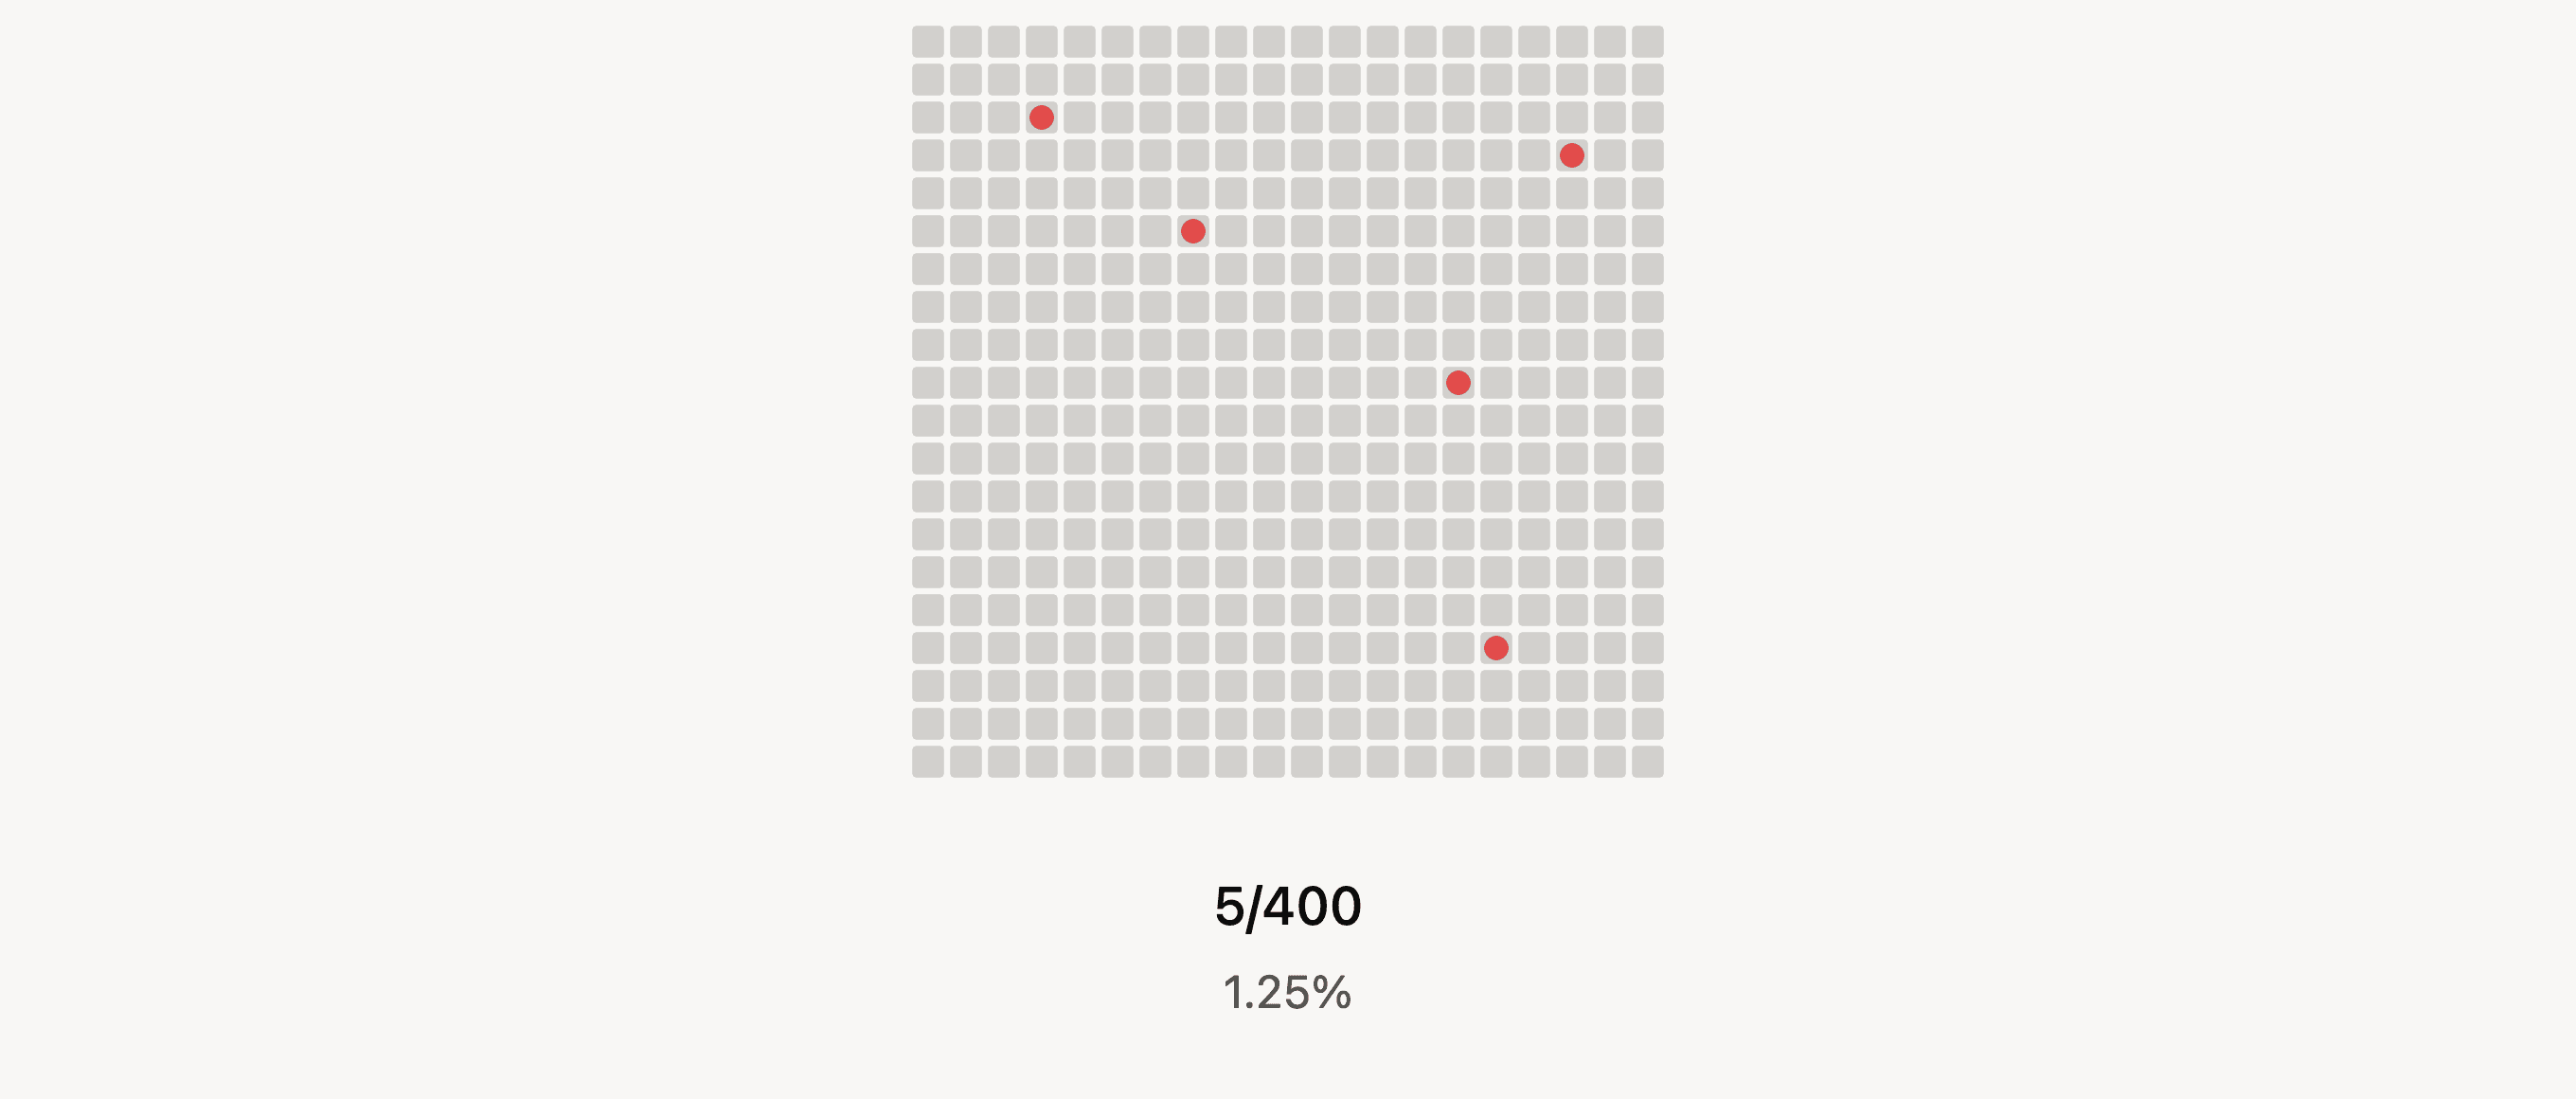
Mas o que quero dizer quando afirmo que estes números não são estatisticamente diferentes? Digamos que tenho um grande conjunto de 400 casos de teste que sei a priori serem positivos, e quero testar se algum detetor os classifica corretamente como positivos ou se classifica alguns erradamente como negativos. No universo A, testo todos os 400 exemplos e verifico que 5 foram classificados erradamente como negativos (representados abaixo por pontos vermelhos), o que se traduz numa taxa de falsos negativos de 1,25% para o meu detetor em todo o conjunto. Ótimo!
No universo B, por outro lado, por uma razão ou por outra, os meus recursos são limitados. Só posso testar uma pequena parte dos 400 exemplos. Isto significa que preciso de selecionar uma amostra, idealmente aleatória, e testá-la. Digamos que consigo testar 40 exemplos, ou 10% do meu conjunto total. Abaixo estão três formas diferentes de selecionar este conjunto, cada uma resultando numa taxa de falsos negativos diferente.
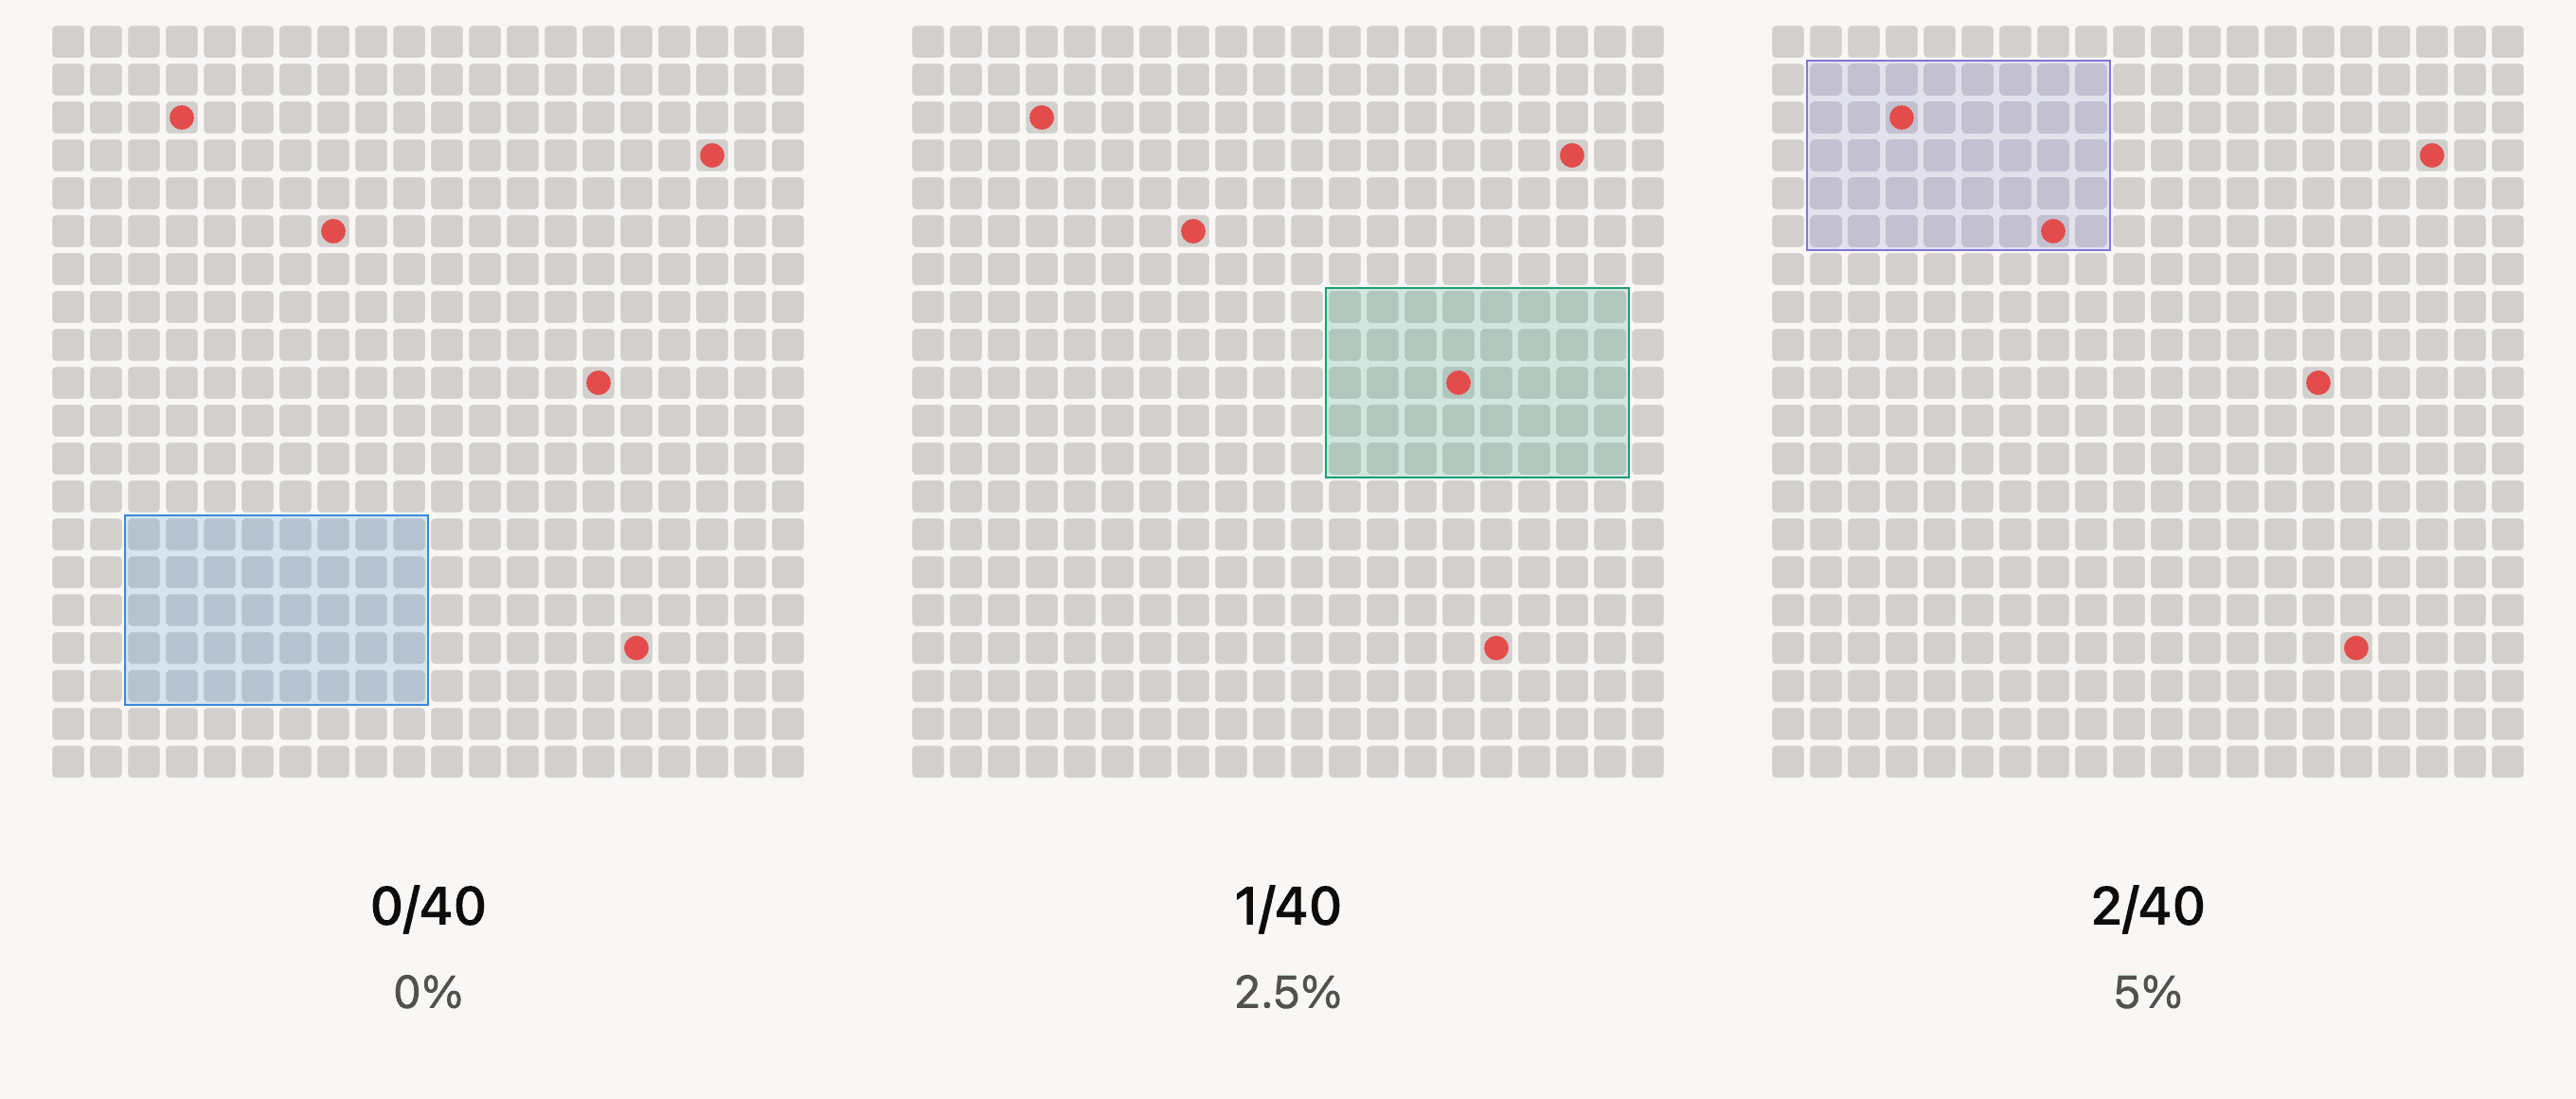
Cada uma destas amostras apresenta uma taxa de falsos negativos diferente, e nenhuma delas está alinhada com a taxa de falsos negativos "verdadeira" de 1,25% do detetor, a que tínhamos acesso no universo A. Em média, uma amostra aleatória de 40 quadrados nesta grelha detetaria meio ponto vermelho, mas, dependendo da amostragem, poderia não detetar qualquer ponto vermelho, como na amostra azul, um ponto vermelho ou dois pontos vermelhos, como na amostra roxa. Uma amostra muito azarada poderia detectar todos os pontos vermelhos, sendo que nesta amostra a taxa de falsos negativos observada seria de 5/40, ou 12,5%.
Uma amostra tão desfavorável é muito improvável. Uma amostra aleatória de 10% do conjunto encontrará entre 0 e 2 pontos em 99% das vezes — este intervalo decorre do que chamamos distribuição amostral. Na prática, isto significa que o tamanho da amostra do universo B, de 40 casos num total possível de 400, não consegue realmente distinguir entre uma taxa de falsos negativos de 0% e uma taxa de falsos negativos de 5%. Quanto maior for a amostra, menor será este intervalo: se, em vez disso, amostrássemos, digamos, 125 pontos de um total de 400, encontraríamos entre 0 e 4 pontos em 99% das vezes, ou uma taxa de falsos negativos observada de 0 a 3,2%.
A mesma lógica pode ser aplicada aos nossos benchmarks Gemini 3.1 Pro, e os dois resultados diferentes de falsos negativos não são conflituosos. Mas a diferença pode ainda fazer-te questionar em qual deles deves confiar mais. Geralmente, o fator determinante para esta decisão é o tamanho da amostra: uma amostra maior significa uma representação mais precisa e uma menor margem de erro. Portanto, seguindo esta lógica, deve confiar mais no benchmark do relatório técnico e considerar este apenas como uma indicação.
Existem outras formas pelas quais dois resultados de benchmark podem diferir. Ao contrário do exemplo da grelha, o conjunto de benchmarks que utilizei não é um subconjunto estrito das 20.000 perguntas do Chatbot Arena utilizadas no relatório técnico: no total, os dois benchmarks do Gemini 3.1 Pro partilharam 286 perguntas exatas. Isto deixa em aberto a possibilidade de que 714 das questões de referência que utilizei poderiam ter sido mais favoráveis para produzir resultados de IA detetáveis do que as utilizadas no relatório técnico do Pangram 4.
Não parece ser esse o caso. Ambos os conjuntos excluem outras linguagens, a matemática e as saídas de código. No entanto, existem diferenças: a mediana do número de palavras por resposta do Gemini 3.1 Pro foi maior no meu conjunto em comparação com o conjunto de relatórios técnicos, e textos mais longos são mais fáceis de pontuar, como sabemos . Mas qual deles representa um teste mais justo para o modelo? Se controlássemos o comprimento da saída e o tamanho da amostra, que conjunto de prompts representaria melhor o universo A?
A verdadeira resposta é que não sei nem posso afirmar. É difícil, quase impossível, criar um conjunto que seja perfeita e exatamente representativo do mundo real. Esta é a principal limitação da estatística. Na realidade, cada benchmark é um pequeno quadrado num mosaico de amostras que se aproximam da realidade subjacente do universo A, ou do mundo "lá fora". De certa forma, este facto poderia ser interpretado como se todos os resultados dos benchmarks estivessem errados, o que não é mentira, mas isso não significa que sejam inúteis. Ao combinar muitos resultados diferentes em muitos tipos diferentes de conjuntos, podemos aproximar-nos de uma boa aproximação da verdadeira realidade subjacente. É por isso que executamos muitos tipos diferentes de benchmarks, incluindo aqueles específicos para o modelo, idioma , conteúdo e humanizador .
Com o objetivo de criar uma melhor aproximação, tenho algumas melhorias em mente para o meu processo de geração de conjuntos de referência. Daqui para a frente, irei aleatorizar o processo de seleção de prompts para o Chatbot Arena a partir de um conjunto maior, em vez de utilizar os mesmos prompts para cada versão do modelo. Também irei flexibilizar um pouco os meus filtros para permitir prompts mais variados, como perguntas técnicas, e adicionarei alguns prompts extra ao conjunto para diversificar o tipo de resposta que obtemos.
Estes posts de blog têm um risco baixo em comparação com o relatório técnico, mas isso não significa que não devamos procurar o rigor, mesmo no universo B.
Conclusão
O Pangram é robusto ao Gemini 3.8 Flash em comandos de linguagem natural e detecta-o com uma precisão observada de 99,80%. Deteta o Gemini 3.1 Pro com uma precisão observada de 99,70%, para um total combinado de 1.995 em 2.000 (99,75%) em ambos os modelos. O Pangram consegue generalizar para novos modelos porque as novas versões tendem a herdar grande parte do estilo e da voz dos seus antecessores , pelo que o Pangram não necessita de ser retreinado para cada nova versão.
Veja como o Gemini 3.8 Flash e o Gemini 3.1 Pro se comparam com os nossos benchmarks de outros modelos topo de gama recentes:
| Modelo | Detetado como IA | Precisão |
|---|---|---|
| Gemini 3.8 Flash | 998/1.000 | 99.80% |
| Gemini 3.1 Pro | 997/1.000 | 99.70% |
| Claude Opus 5.5 | 997/1.000 | 99.70% |
| Fábula 5.1 | 1.093/1.097 | 99.64% |
| Claude Opus 5 | 1.105/1.107 | 99.82% |
| GPT-5.6 | 3.408/3.423 | 99.56% |
| Claude Soneto 5 | 1.145/1.147 | 99.83% |
| Gémeos 3 | 28/28 | 100% |
Se quiseres consultar um documento específico, podes experimentar o Pangram aqui.
Leitura relacionada
Três por cento das críticas na primeira página da Amazon são agora geradas por IA
O Pangram não deteta nenhum falso positivo em ensaios de alunos de diversas origens
Análise aprofundada das avaliações no Yelp

Desempenho do Pangram num enxame de agentes em conluio
A IA ajuda a redigir quase 50 % dos comunicados de imprensa
Avaliações de pangramas realizadas por terceiros

