Pangram, Claude Opus 5.5’i tespit edebilir mi?
Peki, şu anda yazma konusunda iyi mi?

İşte kısa bir özet
1000 komut arasından Pangram 4, Claude Opus 5.5’in çıktılarında %99,70’lik bir doğruluk oranına ulaşmaktadır.
Chatbot Arena'dan alınan 1.000 komut arasından Pangram 4, Claude Opus 5.5'in ürettiği iki çıktıyı “karışık”, birini “tamamen insan tarafından yazılmış” ve 997'sini “tamamen yapay zeka tarafından üretilmiş” olarak sınıflandırdı; böylece Claude Opus 5.5 üzerinde %99,70'lik bir doğruluk oranına ulaştı.
Aşağıda, yanlış negatif sonuçları kategorilere göre ele alıyoruz. Ayrıca, bu modelin önceki Claude modellerinden farklı (daha iyi?) bir yazar olmasını sağlayan unsurları da inceliyoruz.
Karşılaştırma setini oluşturmak için, her zamanki gibi, LMSYS veri setindeki (Zheng ve ark., 2023) Chatbot Arena ilk tur komutlarının filtrelenmiş bir alt kümesini kullandım. Kod, matematik, çok kısa veya çok uzun cevaplar ya da uygunsuz yaratıcı yazım gerektiren komutları filtreleyerek eledim. Ardından bunları Opus 5.5’e girdim ve çıktıyı Pangram 4 üzerinden işledim.
Kategorilere göre sonuçlar
İki karışık sonuçlu yanlış negatif de edebi nitelikteydi: Birinde Jane Austen’ın bir kitabındaki bir bölümün açıklanması isteniyordu (AI tarafından işaretlenen: %75,83, insan: %24,17) diğeri ise Opus 5.5’ten, Atinalıların beyaz ve altın rengi bir elbisenin aslında mavi ve siyah olduğuna inandıklarını suçlayan bir Korintli diplomatın konuşmasını, Thukydides’in Peloponnesos Savaşı Tarihi tarzında yazmasını istiyordu (AI: %77,10, insan: %22,90).
| Kategori | Örnekler | Yapay Zeka | Karışık | İnsan |
|---|---|---|---|---|
| Gerekçeler | 16 | 16 | 0 | 0 |
| E-postalar / mektuplar | 60 | 60 | 0 | 0 |
| Denemeler / makaleler | 30 | 30 | 0 | 0 |
| Açıklamalar | 551 | 550 | 1 | 0 |
| Şiirler | 115 | 114 | 0 | 1 |
| Diğer yaratıcı yazılar | 81 | 80 | 1 | 0 |
| Yorumlar | 8 | 8 | 0 | 0 |
| Hikâyeler | 139 | 139 | 0 | 0 |
| Toplam | 1,000 | 997 | 2 | 1 |
1.000 örnekten oluşan kümedeki tek tam anlamıyla insana ait yanlış negatif sonuç bir şiirdi. Chatbot Arena’dan gelen komut şuydu: “Bana Ozymandias tarzında bir Club Penguin şiiri yaz.” Buna yanıt olarak Claude, tesadüfen Percy Shelley’nin en sevdiğim şiirlerinden birinin parodisini yazdı (ayrıca Horace Smith’in versiyonunun da hayranıyım):
Penguinmandias
Ölü bir sunucudan bir oyuncuyla karşılaştım,
Şöyle dedi: "İki devasa ve sallanarak yürüyen buz ayağı
Rıhtımın yanında duruyor. Onların yanında, yarı batmış halde, bir kafa
Karda paramparça yatıyor; kısık gözleri,
Beta şapkası ve soğuk bir emrin alaycı gülümsemesi,
Bunun kodlayıcısının o tutkuları iyi okuduğunu gösteriyor
Hâlâ hayatta olan, bu pikselli şeylerin üzerine damgalanmış olanlar,
Onları yasaklayan modlar ve besleyen paralar;
Ve kaide üzerinde şu sözler belirir:
'Adım Snowflake7, Üyeler'in Üyesi:
Ey Üye Olmayanlar, igluma bakın ve umutsuzluğa kapılın!'
Yanında başka hiçbir şey kalmaz. O devasa gecikmenin çürümesinin etrafında
Sınırsız ve çıplak,
Yalnız ve düz karlar uzağa doğru uzanır."
Buna bayılıyorum! Club Penguin’i hiç oynamadım ama sanırım buradaki göndermeler yerinde.
Opus 5.5 daha iyi yazıyor mu?
Anthropic, bu en yeni Opus sürümünün yazma konusunda daha iyi olduğunu ve daha net bir şekilde iletişim kurduğunu iddia ediyor.
Bunu belirli örnekler üzerinde test edebiliriz, ancak Opus 5.5’in çıktısı genel olarak nasıl görünüyor? Önceki modellerle aynı favori kelimeleri ve ifadeleri paylaşıyor mu? Karşılaştırma yapmak için Opus 5 ve Sonnet 5 üzerinde karşılaştırma testi yaptığımız aynı 1.000 komutu çalıştırdım. Anthropic de bunu yapmış olabilir, ancak blog yazısını henüz okumadım çünkü geçmiş deneyimlerime göre Anthropic ’in blog yazıları bence çok uzun oluyor.
Toplamda, Opus 5.5, Opus 5 ve Sonnet 5’ten gelen ve her biri aynı 1.000 komuta yanıt veren 3.000 yanıt üzerinden 1.618.289 kelimelik bir örneklem elde ettim. Bu (nispeten küçük) örneklemden yola çıkarak, Opus 5.5’in Claude ailesindeki önceki modellerden farklı bir yazım tarzına sahip olduğunu ve belki de bu modellerin en rahatsız edici bazı alışkanlıklarını ortadan kaldırdığını söylemek doğru olur.
Opus 5.5, klasik yoğunlaştırıcılarla en büyük değişikliği gösterdi. Opus 5’e kıyasla “gerçekten” %83 daha az, Sonnet 5’e kıyasla ise kelime başına %54 daha az kullanmıştır (ancak Sonnet 5 yanıtları, ortalama olarak Opus 5 ve 5.5 yanıtlarının yaklaşık yarısı kadar uzunluktaydı: 334 kelimeye karşı 641 kelime), “muazzam” bir şekilde %65 daha az ve “anlamlı” bir şekilde %46 daha az kullanmıştır.
 Opus 5.5 yanıtlarında Sonnet 5 ve Opus 5 kullanıcılarının en sevdiği kelimeler: Sonnet 5 ve Opus 5 verilerinin birleştirilmesiyle oluşturulan referans değerine göre yüzde değişimler.
Seçilen kelimeler arasında, Sonnet 5 ile Opus 5’in birleştirilmiş verilerinde en sık geçenler “genuinely”, “honest”, “genuine”, “patterns” ve “marcus” (?) idi; bunların hepsinin sıklığı Opus 5.5 yanıtlarında azalmıştı.
En sinir bozucu Claudeizmlerin çoğu, Opus 5.5 karşılaştırma yanıtlarında hiç yer almadı; buna yine Claude’un “genuinely” kelimesini kullandığı çeşitli ifadeler de dahildi. Opus 5.5'in kelime dağarcığında göze çarpan diğer azalmalar: “matters enormously” ifadesi Opus 5'e kıyasla %82'lik bir düşüş gösterdi; hem “the honest answer” hem de “the honest answer is that” ifadeleri ise Opus 5.5'in metninde hiç yer almadı. Hem Opus 5.5 hem de önceki sürüm, 1.000 komut metni boyunca “the core idea” ifadesini tam olarak 25 kez kullandı.
 Opus 5.5 yanıtlarında Sonnet 5 ve Opus 5’in en sevilen ifadeleri: yüzde değişimleri; önceki favoriler mavi, mevcut favoriler ise kehribar renginde gösterilmiştir.
Yeni özet ve yönlendirici ifadeler de dahil olmak üzere bazı kelime ve ifadelerin sayısı arttı. Şaşırtıcı bir şekilde, “sessizce dedi”, “uzun bir an” ve “bir şey hissetti” gibi bazı kurgu ifadeleri, Opus 5.5 yanıtlarında çok daha sık ortaya çıktı. Karşılaştırma grubunun yaklaşık üçte biri yaratıcı yazma konuları olduğundan, bu artışın, diğer Claude modellerine kıyasla kurgu yazarken daha kalıplaşmış veya sınırlı bir repertuara işaret ediyor olabileceğini düşünüyorum.
Bunu hızlıca test etmek için, Haiku 4.5’i kullanarak Opus 5 ve Opus 5.5’ten gelen 333 yaratıcı yazma çiftini, kör bir değerlendirmeyle özgünlük, sürpriz ve tematik gelişim açısından 5 puanlık bir ölçekte derecelendirdim. Haiku, Opus 5.5 öykülerini her kategoride ortalama 0,75 puan daha düşük derecelendirdi. Haiku değerlendirme sisteminin etiket atamasına göre, Opus 5.5, Opus 5’e kıyasla umut, dayanıklılık, aile ve dostluk temaları hakkında yazma eğilimindeyken, ölüm, zaman, güç, kontrol, özgürlük, adalet, intikam, hafıza, keder veya kayıp gibi temalar hakkında yazma eğilimi daha azdı. Dolayısıyla burada bir tür ödünleşme söz konusu olabilir gibi görünüyor.
 Yaratıcı yazma temaları: Opus 5 ile Opus 5.5 karşılaştırması: 333 çift konuya ilişkin haiku olarak belirlenen ana tema dağılımı.
Bu Claude nasıl bir ses çıkarıyor?
Opus 5.5, 1.000 yanıtta “kısacası” ifadesini 100 kez kullandı — bu, Opus 5’teki 9 kullanım sayısına kıyasla %1016’lık bir artışa tekabül ediyor — oysa Opus 5.5 yanıtları, Opus 5’e kıyasla ortalama olarak sadece 2,9 kelime daha kısaydı (640,5’e karşı 643,4 kelime).
| İfade | Opus 5'in geçtiği yerler | Opus 5.5'te geçen yerler | Değişiklik |
|---|---|---|---|
| kısacası | 9 | 100 | 11.16× |
| örneğin | 22 | 116 | 5.30× |
| başladı | 22 | 74 | 3.38× |
| başlangıçta | 14 | 43 | 3.09× |
| uzun bir süre boyunca | 19 | 42 | 2.22× |
Oldukça küçük bir örneklem büyüklüğüne bakılırsa, Opus 5.5 pratik ve gerçekçi bir dil kullanmayı seviyor gibi görünüyor. Bunun yanıtların özünde de geçerli olup olmayacağı ya da Opus 5.5’in sadece sözde açık ve doğrudan davranmaya çalıştığı henüz belli değil. İki örnek arasında kelime sayısı açısından bir fark olmaması, RLHF’nin bizi bu noktaya getirirken kullandığı yöntemin etkinliği konusunda bende biraz şüphe uyandırıyor.
Opus 5.5 de örnek vermekten çok hoşlanıyor; zira 1.000 yanıtta “örnek” kelimesini 325 kez kullanmış — genel olarak, Opus 5.5 yanıtlarının %20’sinde bu kelime yer alırken, Opus 5 yanıtlarında bu oran %9’dur. “Özet” ve “esas olarak” kelimeleri de benzer şekilde orantısız bir şekilde sıkça kullanılmış. Ve bu Claude, kullanıcıya ipuçları vermekten gerçekten hoşlanıyor!
| Word | Opus 5'in geçtiği yerler | Opus 5.5'te geçen yerler | Değişiklik |
|---|---|---|---|
| duraklatıldı | 9 | 35 | 3.91× |
| ipuçları | 18 | 58 | 3.24× |
| esas olarak | 24 | 75 | 3.14× |
| bakakaldı | 22 | 62 | 2.83× |
| örnek | 121 | 325 | 2.70× |
| özet | 60 | 157 | 2.63× |
Bu model, önceki Claude Opus modelinden farklı bir yazım tarzına sahip olsa da; madde işaretli listeleri ve kısa, kesik kesik cümleleri yoğun olarak kullanan diğer eski modellere benzer bir yazım tarzı sergiliyor gibi görünüyor: Opus 5.5’in ortalama cümle uzunluğu daha kısa ve cümlelerinin uzunlukları Opus 5’e kıyasla daha tekdüze.
| Ölçü | Opus 5 | Opus 5.5 | Değişiklik |
|---|---|---|---|
| Özetleme işaretçileri | 0.016 | 0.171 | +942.3% |
| Numaralı liste öğeleri | 0.95 | 2.01 | +111.4% |
| Sırasız madde işaretli maddeler | 7.36 | 13.63 | +85.1% |
| Uyarı/belirsizlik göstergeleri | 5.48 | 6.74 | +23.0% |
| Zarflar | 64.26 | 62.66 | -2.5% |
| Cümle uzunluğundaki değişkenlik (CV) | 0.534 | 0.475 | -11.0% |
| Ortalama cümle uzunluğu | 14.53 | 12.50 | -14.0% |
| Olumsuzluklar | 10.52 | 7.53 | -28.4% |
| (Yukarıdaki tablodaki oranlar, 1.000 kelime başına düşen sıklıkları göstermektedir) |
Opus 5.5 özetlemeyi çok sever; bu, her turda tekrarlanırsa can sıkıcı olabilir, ancak bu veri setinin yalnızca ilk turdaki soru-cevap çiftlerini içerdiğini unutmayın. Ne yazık ki, Claude’un en can sıkıcı alışkanlıklarından biri bu modelde biraz daha kötüleşti: Opus 5.5, Opus 5’e kıyasla kelime başına daha fazla uyarı eklemeyi seviyor. Her iki model de yanıtların %82’sinde en az bir belirsizlik göstergesi içerse de (817/1.000’e karşı 818/1.000), Opus 5.5, 1.000 kelime başına %23,0 daha sık uyarı kelimeleri kullandı. Ancak “caveat” kelimesinin kendisi artık kullanımdan kalkmak üzere: Opus 5.5, bu kelimeyi yanıtların sadece 4/1.000’inde kullanırken, Opus 5’te bu sayı 22’ydi.
Ancak bunların hiçbiri, Opus 5.5.’in mutlaka kötü bir yazar olacağı anlamına gelmez. Onunla geçirdiğim sınırlı süre içinde, oldukça iyi olduğunu gördüm! Kullanılabilirlik açısından, Claudes’un etkili bir şekilde iletişim kurabilmesi önemlidir ve bu konudaki çaba için minnettarım. Ayrıca, Claude’u daha iyi bir yazar haline getirmenin, Pangram’ın yapay zeka metinlerini tespit etme çabasıyla hiç de çelişmediğini belirtmek gerekir — iyi yazarların bile kendilerine özgü ipuçları vardır!
Annamieka, Pangram’da teknik yazar olarak çalışmaktadır.
İlgili makaleler
Pangram GPT-6 Astra'yı Tespit Edebilir mi?
Basın bültenlerinin yaklaşık %50’sinin yazılmasında yapay zeka yardımcı oluyor
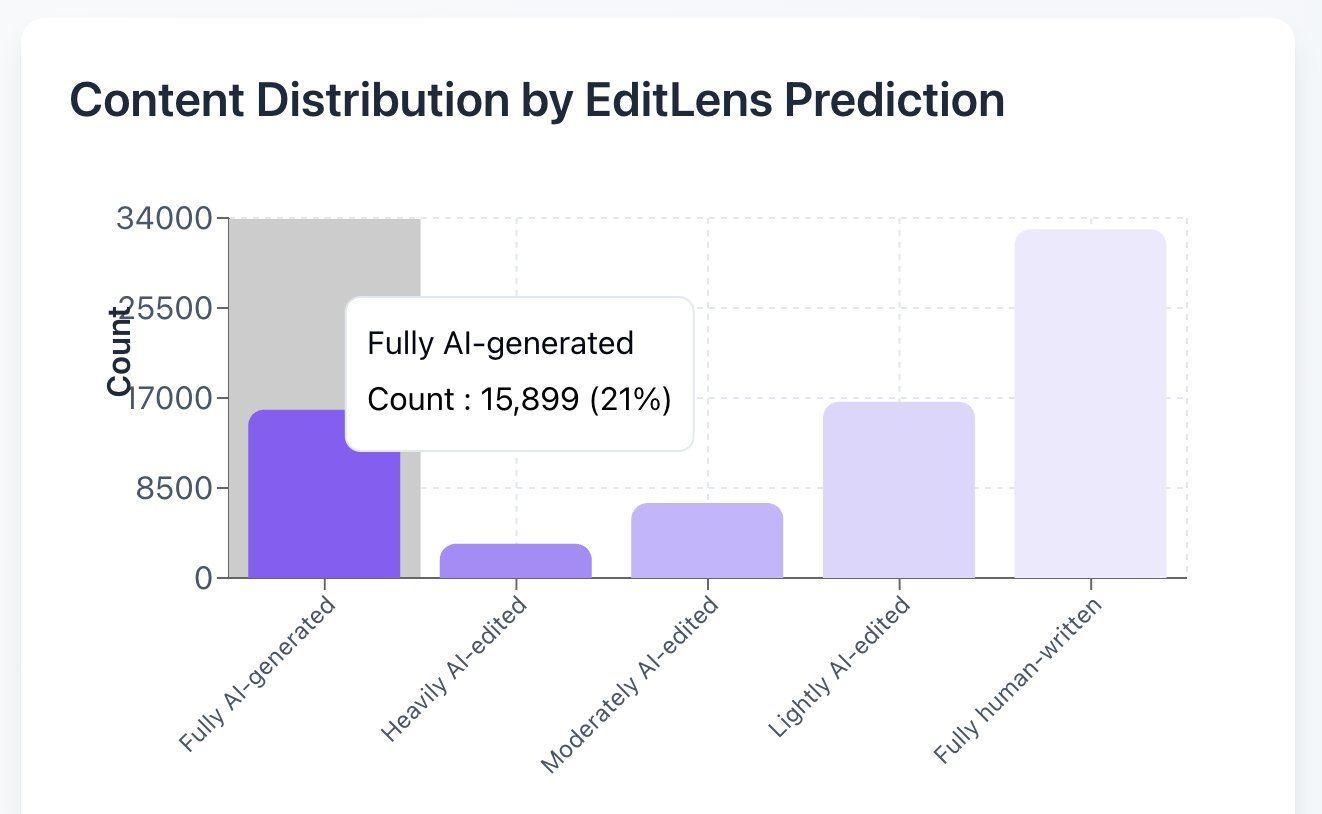
Pangram, ICLR makalelerinin %21’inin yapay zeka tarafından yazıldığını öngörüyor
Üçüncü Taraf Pangram Değerlendirmeleri

Pangram’ın İşbirliği Yapan Ajan Sürüsündeki Performansı