
Hier eine kurze Zusammenfassung
Von 1.022 Eingabeaufforderungen erreicht Pangram 4 eine Genauigkeit von 99,71 % bei den Ausgaben von Claude Sonnet 5.5.
Von 1.022 aus Chatbot Arena stammenden Eingabeaufforderungen klassifizierte Pangram 4 zwei Ausgaben von Claude Sonnet 5.5 als gemischt, eine als vollständig menschlich und 1.019 als vollständig KI-generiert, was einer Genauigkeit von 99,71 % bei Claude Sonnet 5.5 entspricht.
Im Folgenden werden die falsch negativen Ergebnisse nach Kategorien aufgeschlüsselt.
Der für die Benchmarks verwendete Datensatz wurde aus einer gefilterten Teilmenge der ersten Chatbot-Arena-Aufforderungen des LMSYS- Datensatzes (Zheng et al., 2023) generiert. Ich habe Aufforderungen herausgefiltert, die nach Code, Mathematik, sehr kurzen oder sehr langen Antworten oder unpassendem kreativen Schreiben fragten. Anschließend habe ich diese Aufforderungen an Claude Sonnet 5.5 übergeben und die Ausgabe mit Pangram 4 analysiert.
Ergebnisse nach Kategorie
| Kategorie | Beispiele | KI | Gemischt | Mensch |
|---|---|---|---|---|
| Argumente | 16 | 16 | 0 | 0 |
| E-Mails / Briefe | 61 | 60 | 1 | 0 |
| Aufsätze / Artikel | 32 | 32 | 0 | 0 |
| Erläuterungen | 563 | 562 | 1 | 0 |
| Gedichte und andere kreative Texte | 198 | 197 | 0 | 1 |
| Rezensionen | 8 | 8 | 0 | 0 |
| Geschichten | 144 | 144 | 0 | 0 |
| Gesamt | 1,022 | 1,019 | 2 | 1 |
Ein versäumter Versuch war die Bitte um die Erklärung eines Rätsels aus Jane Austens Roman „Emma“ , das auch von Opus 5.5 übersehen wurde:
Erklären Sie die Scharade, die Herr Elton Harriet und Emma vorgespielt hat.
Der einzige vollständig menschliche Fehlschlag betraf ein Gedicht. Die Aufgabe lautete: „Nennen Sie mir ein Gedicht von Hafis.“ Sonett 5.5 enthielt die Übersetzung eines bekannten persischen Gedichts . Soweit ich das beurteilen kann, entspricht diese Übersetzung keiner existierenden menschlichen Übersetzung exakt, orientiert sich aber recht stark an vielen. Wie auch bei Penguinmandias in anderen Benchmarks beunruhigen mich diese nahezu identischen Kopien bestehender Gedichte nicht weiter.
Fazit
Pangram ist gegenüber Claude Sonnet 5.5 bei natürlichsprachlichen Eingabeaufforderungen robust und erkennt es mit einer Genauigkeit von 99,71 %. Da neue Modellversionen in der Regel viel vom Stil und der Ausdrucksweise ihrer Vorgänger übernehmen , kann Pangram auf neue Modelle generalisieren und muss daher nicht für jede neue Version neu trainiert werden.
Hier sehen Sie, wie Claude Sonnet 5.5 im Vergleich zu unseren Benchmarks anderer aktueller Spitzenmodelle abschneidet:
| Modell | Als KI erkannt | Genauigkeit |
|---|---|---|
| Gemini 3.8 Blitz | 998/1.000 | 99.80% |
| Gemini 3.1 Pro | 997/1.000 | 99.70% |
| Claude Opus 5.5 | 997/1.000 | 99.70% |
| Fabel 5.1 | 1.093/1.097 | 99.64% |
| Claude Opus 5 | 1.105/1.107 | 99.82% |
| GPT-5.6 | 3.408/3.423 | 99.56% |
| Claude Sonett 5 | 1.145/1.147 | 99.83% |
| Gemini 3 | 28/28 | 100% |
Wenn Sie ein bestimmtes Dokument überprüfen möchten, können Sie es hier mit Pangram versuchen.
Weiterführende Literatur
67 % der Menschen, die Online-Inhalte konsumieren, erkennen irreführende Informationen, die von KI stammen
Pangram zeigt bei verschiedenen Schüleraufsätzen 0 Fehlalarme an
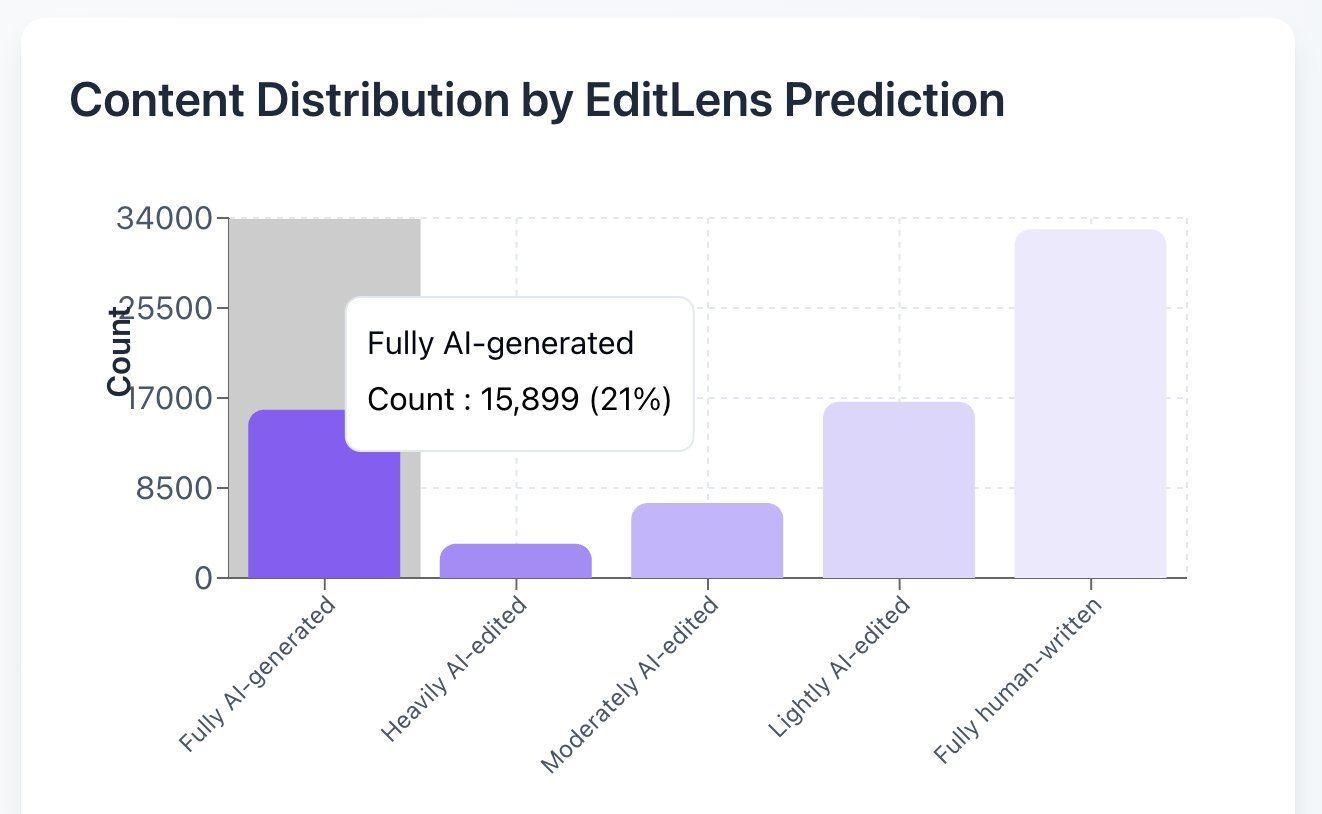
Pangram schätzt, dass 21 % der ICLR-Rezensionen von KI generiert sind
Drei Prozent der Rezensionen auf der Startseite von Amazon werden mittlerweile von KI generiert
Welcher KI-Detektor ist am genauesten? 30 Tools im Test (2026)
Journalisten hassen KI-generierte PR genauso wie wir alle

