Kann Pangram Gemini 3.8 Flash und Gemini 3.1 Pro erkennen?
Außerdem werden die Auswahl von Benchmark-Prompts, die Stichprobenverteilung und der Sinn von Statistiken erörtert.

Hier eine kurze Zusammenfassung
Bei 1.000 Eingabeaufforderungen erreicht Pangram 4 eine Genauigkeit von 99,80 % auf Gemini 3.8 Flash-Ausgaben und eine Genauigkeit von 99,70 % auf Gemini 3.1 Pro-Ausgaben, was eine Gesamtgenauigkeit von 99,75 % auf der neuesten Version der Gemini-Familie für diesen Benchmark-Satz ergibt.
Von 1.000 Beispielen natürlicher Sprache klassifizierte Pangram 4 zwei Ausgaben von Gemini 3.8 Flash als menschlich und 998 als vollständig KI-generiert, was einer Genauigkeit von 99,80 % entspricht. Auf Gemini 3.1 Pro (veröffentlicht am 19. Februar 2026) klassifizierte Pangram eine Ausgabe als gemischt, zwei als vollständig menschlich und 997 als vollständig KI-generiert, was einer Genauigkeit von 99,70 % entspricht.
Zur Erstellung des Benchmark-Sets verwendete ich eine gefilterte Teilmenge der ersten Chatbot-Arena-Aufforderungen aus dem LMSYS- Datensatz (Zheng et al., 2023). Ich filterte Aufforderungen heraus, die nach Code, Mathematik, sehr kurzen oder sehr langen Antworten oder unpassendem kreativen Schreiben fragten. Anschließend übergab ich diese an Gemini 3.8 Flash und Gemini 3.1 Pro und analysierte die Ausgabe mit Pangram 4 .
Im Folgenden werden die Erkennungsergebnisse nach Kategorien, falsch negative Ergebnisse, die Leistung von Gemini 3.1 Pro bei früheren Benchmarks sowie einige Schwächen und zukünftige Verbesserungen meiner Prompt-Auswahl für den Blogbeitrag besprochen.
Ergebnisse nach Kategorie
Nach Aufgabenkategorien (zugewiesen von Haiku-Agenten) schnitt Pangram 4 auf 1.000 Gemini 3.8 Flash-Ausgaben wie folgt ab:
| Kategorie | Beispiele | KI | Gemischt | Mensch |
|---|---|---|---|---|
| Argumente | 18 | 18 | 0 | 0 |
| E-Mails / Briefe | 54 | 53 | 0 | 1 |
| Aufsätze / Artikel | 33 | 33 | 0 | 0 |
| Erläuterungen | 563 | 563 | 0 | 0 |
| Gedichte | 108 | 107 | 0 | 1 |
| Sonstige literarische Texte | 75 | 75 | 0 | 0 |
| Rezensionen | 7 | 7 | 0 | 0 |
| Geschichten | 142 | 142 | 0 | 0 |
| Gesamt | 1,000 | 998 | 0 | 2 |
Und hier die Ergebnisse nach Kategorien für Gemini 3.1 Pro:
| Kategorie | Beispiele | KI | Gemischt | Mensch |
|---|---|---|---|---|
| Argumente | 18 | 18 | 0 | 0 |
| E-Mails / Briefe | 55 | 55 | 0 | 0 |
| Aufsätze / Artikel | 33 | 33 | 0 | 0 |
| Erläuterungen | 559 | 559 | 0 | 0 |
| Gedichte und andere kreative Texte | 182 | 179 | 1 | 2 |
| Rezensionen | 7 | 7 | 0 | 0 |
| Geschichten | 146 | 146 | 0 | 0 |
| Gesamt | 1,000 | 997 | 1 | 2 |
Eines der falsch negativen Ergebnisse für Gemini 3.8 Flash trat bei einer Aufforderung auf, die Ausgaben zu vermenschlichen , indem Rechtschreibfehler und Tippfehler hinzugefügt wurden:
Schreibe einen Brief mit Tipp- und Rechtschreibfehlern an den Clan „HelpWanted“ (Raid Shadow Legends, ich bin Level 10, ein neuer Spieler). Der Brief sollte kurz und sehr überzeugend sein.
Pangram 4 hat beide Versionen von Penguinmandias in beiden Modellen nicht erkannt, genau wie bei der Generierung mit Opus 5.5 . Die Eingabeaufforderung lautet:
Schreibe mir ein Club Penguin-Gedicht im Stil von Ozymandias.
Bei Gemini 3.1 Pro stimmen 71 % der Wörter in „Penguinmandias“ mit Shelleys Originalgedicht überein, daher halte ich das Ergebnis für einen eher unbedenklichen Fehlalarm. Gemini 3.1 Pro hat außerdem zwei weitere Gedichte nicht erkannt.
Was macht ein Benchmark-Ergebnis aus?
In unserem technischen Bericht zu Pangram 4 führten wir einen Test auf falsch-negative Ergebnisse mit 520.000 KI-Ausgaben von 26 verschiedenen Modellen durch, was 20.000 Antworten pro Modell entspricht. Eines dieser getesteten Modelle war Gemini 3.1 Pro, das wir auch hier getestet haben. Wie Sie im technischen Bericht sehen werden, stellten wir jedoch bei diesem Datensatz eine höhere Rate falsch-negativer Ergebnisse fest als bei unserem. Warum?
Eine Antwort lautet: Statistisch gesehen gibt es keinen Unterschied. Die hier festgestellten 3 Fehlalarme bei 1.000 Antworten entsprechen einer beobachteten Falsch-Negativ-Rate (FNR) von 0,3 % mit einem 95%-Konfidenzintervall von 0,06 % bis 0,87 %. Die im technischen Bericht angegebene FNR beträgt 111 Fehlalarme bei 20.000 Eingabeaufforderungen, was einer FNR von 0,555 % entspricht und somit innerhalb dieses Bereichs liegt.
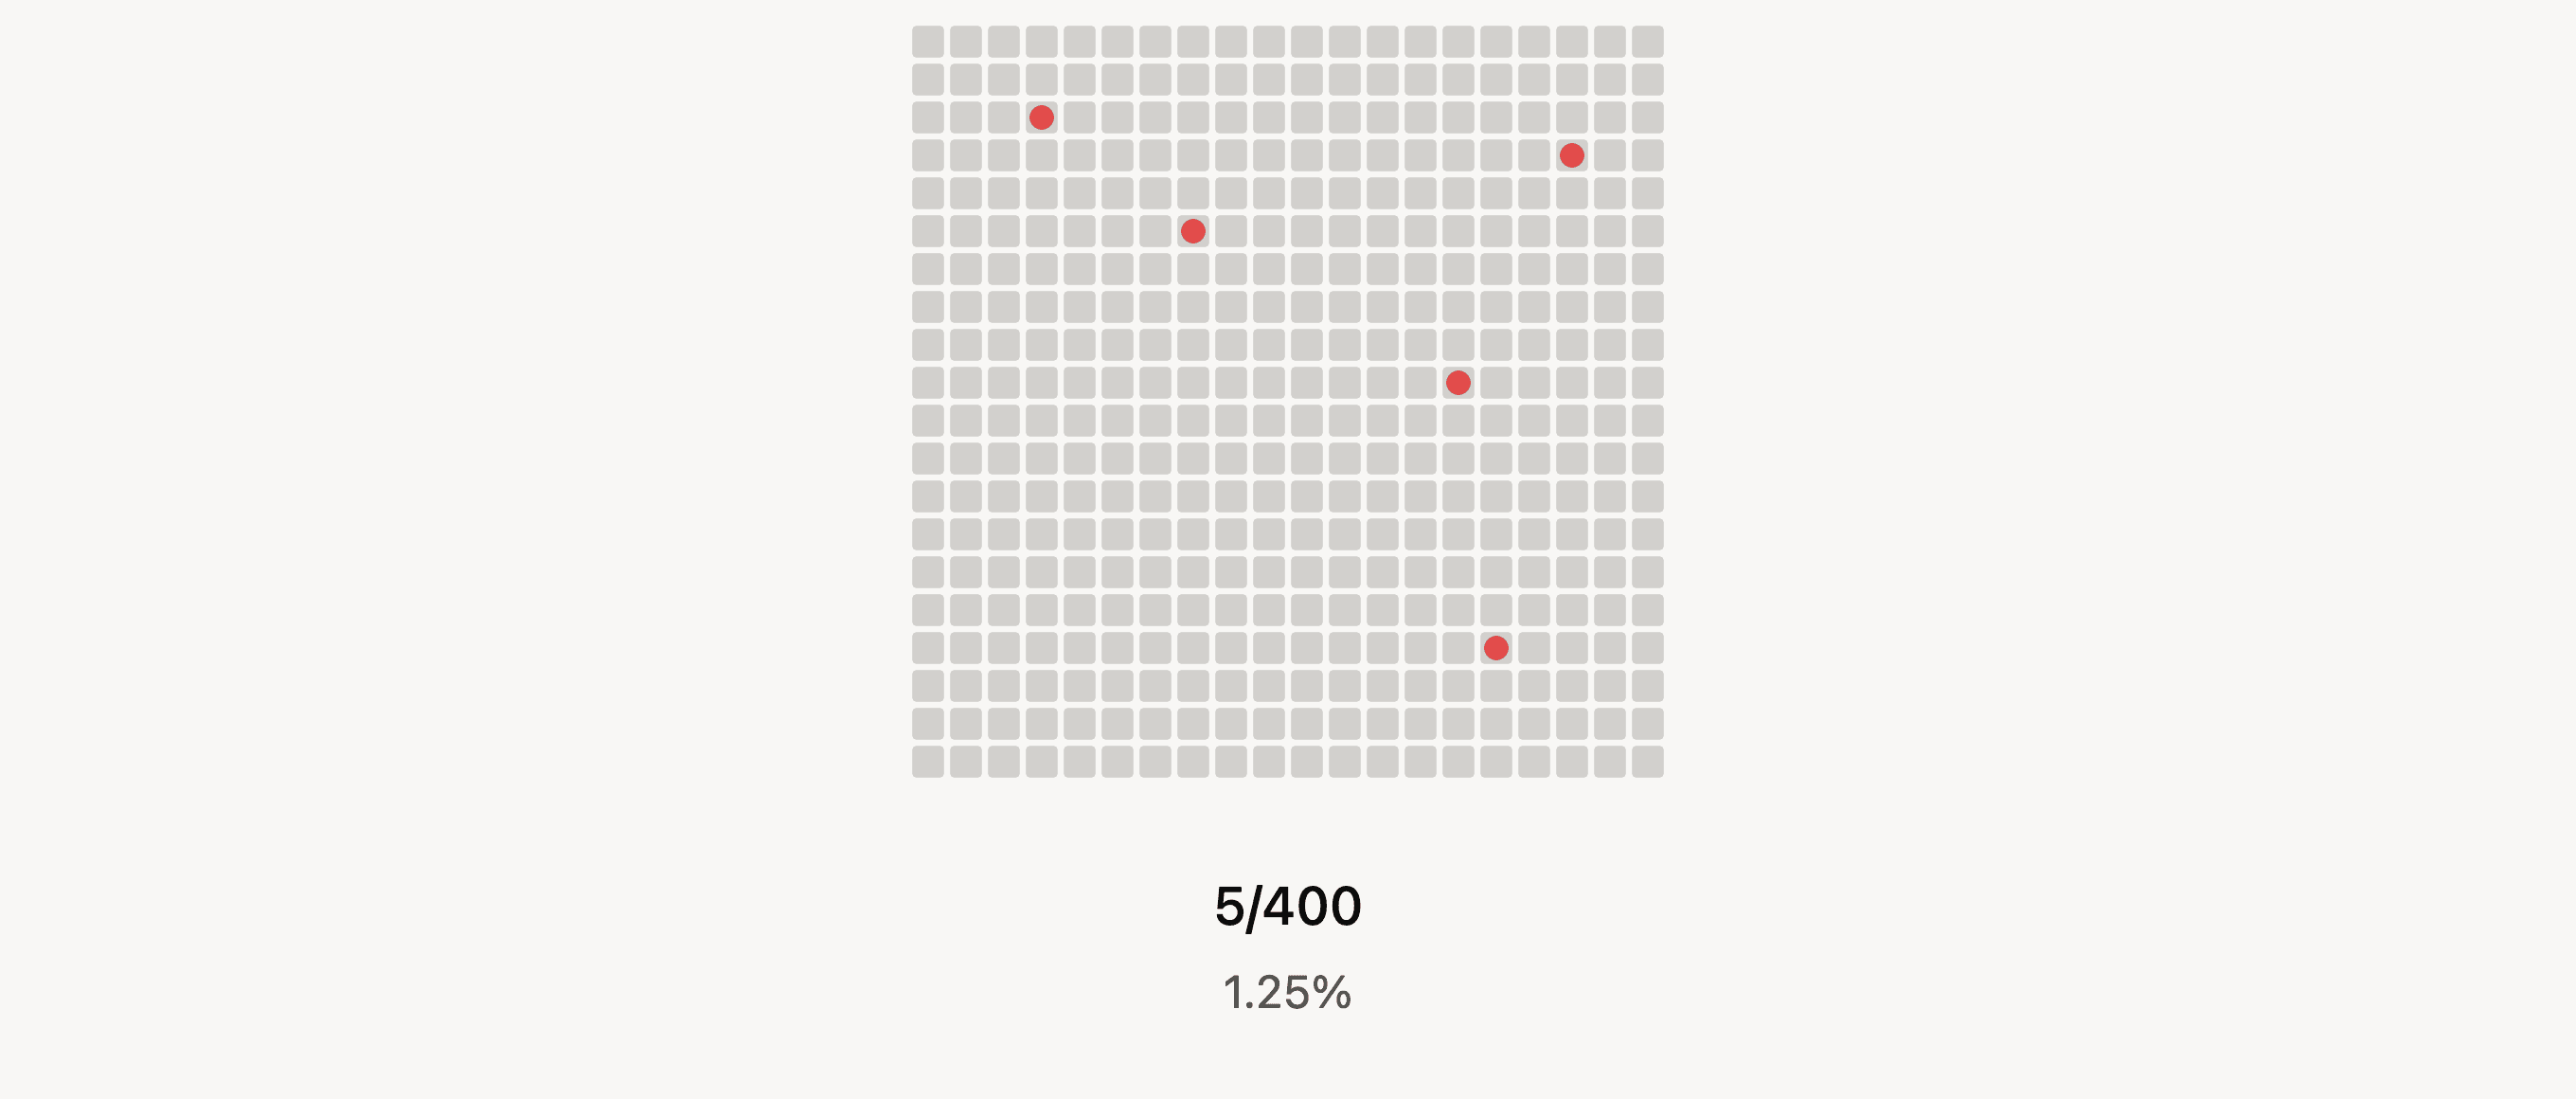
Was meine ich aber, wenn ich sage, dass diese Zahlen statistisch nicht signifikant unterschiedlich sind? Nehmen wir an, ich habe einen großen Datensatz von 400 Testfällen, von denen ich a priori weiß, dass sie positiv sind, und ich möchte testen, ob ein Detektor sie korrekt als positiv kennzeichnet oder einige fälschlicherweise als negativ. In Universum A teste ich alle 400 Beispiele und stelle fest, dass 5 fälschlicherweise als negativ gekennzeichnet sind (unten als rote Punkte dargestellt). Das entspricht einer Falsch-Negativ-Rate von 1,25 % für meinen Detektor im gesamten Datensatz. Hervorragend!
In Universum B hingegen bin ich aus irgendeinem Grund ressourcenbeschränkt. Ich kann nur einen kleinen Teil der 400 Beispiele testen. Daher muss ich eine Stichprobe, idealerweise eine zufällige, ziehen und diese testen. Nehmen wir an, ich kann 40 Beispiele testen, also 10 % meines Gesamtdatensatzes. Im Folgenden werden drei verschiedene Möglichkeiten zur Auswahl dieser Stichprobe beschrieben, die jeweils zu einer unterschiedlichen Rate falsch negativer Ergebnisse führen.
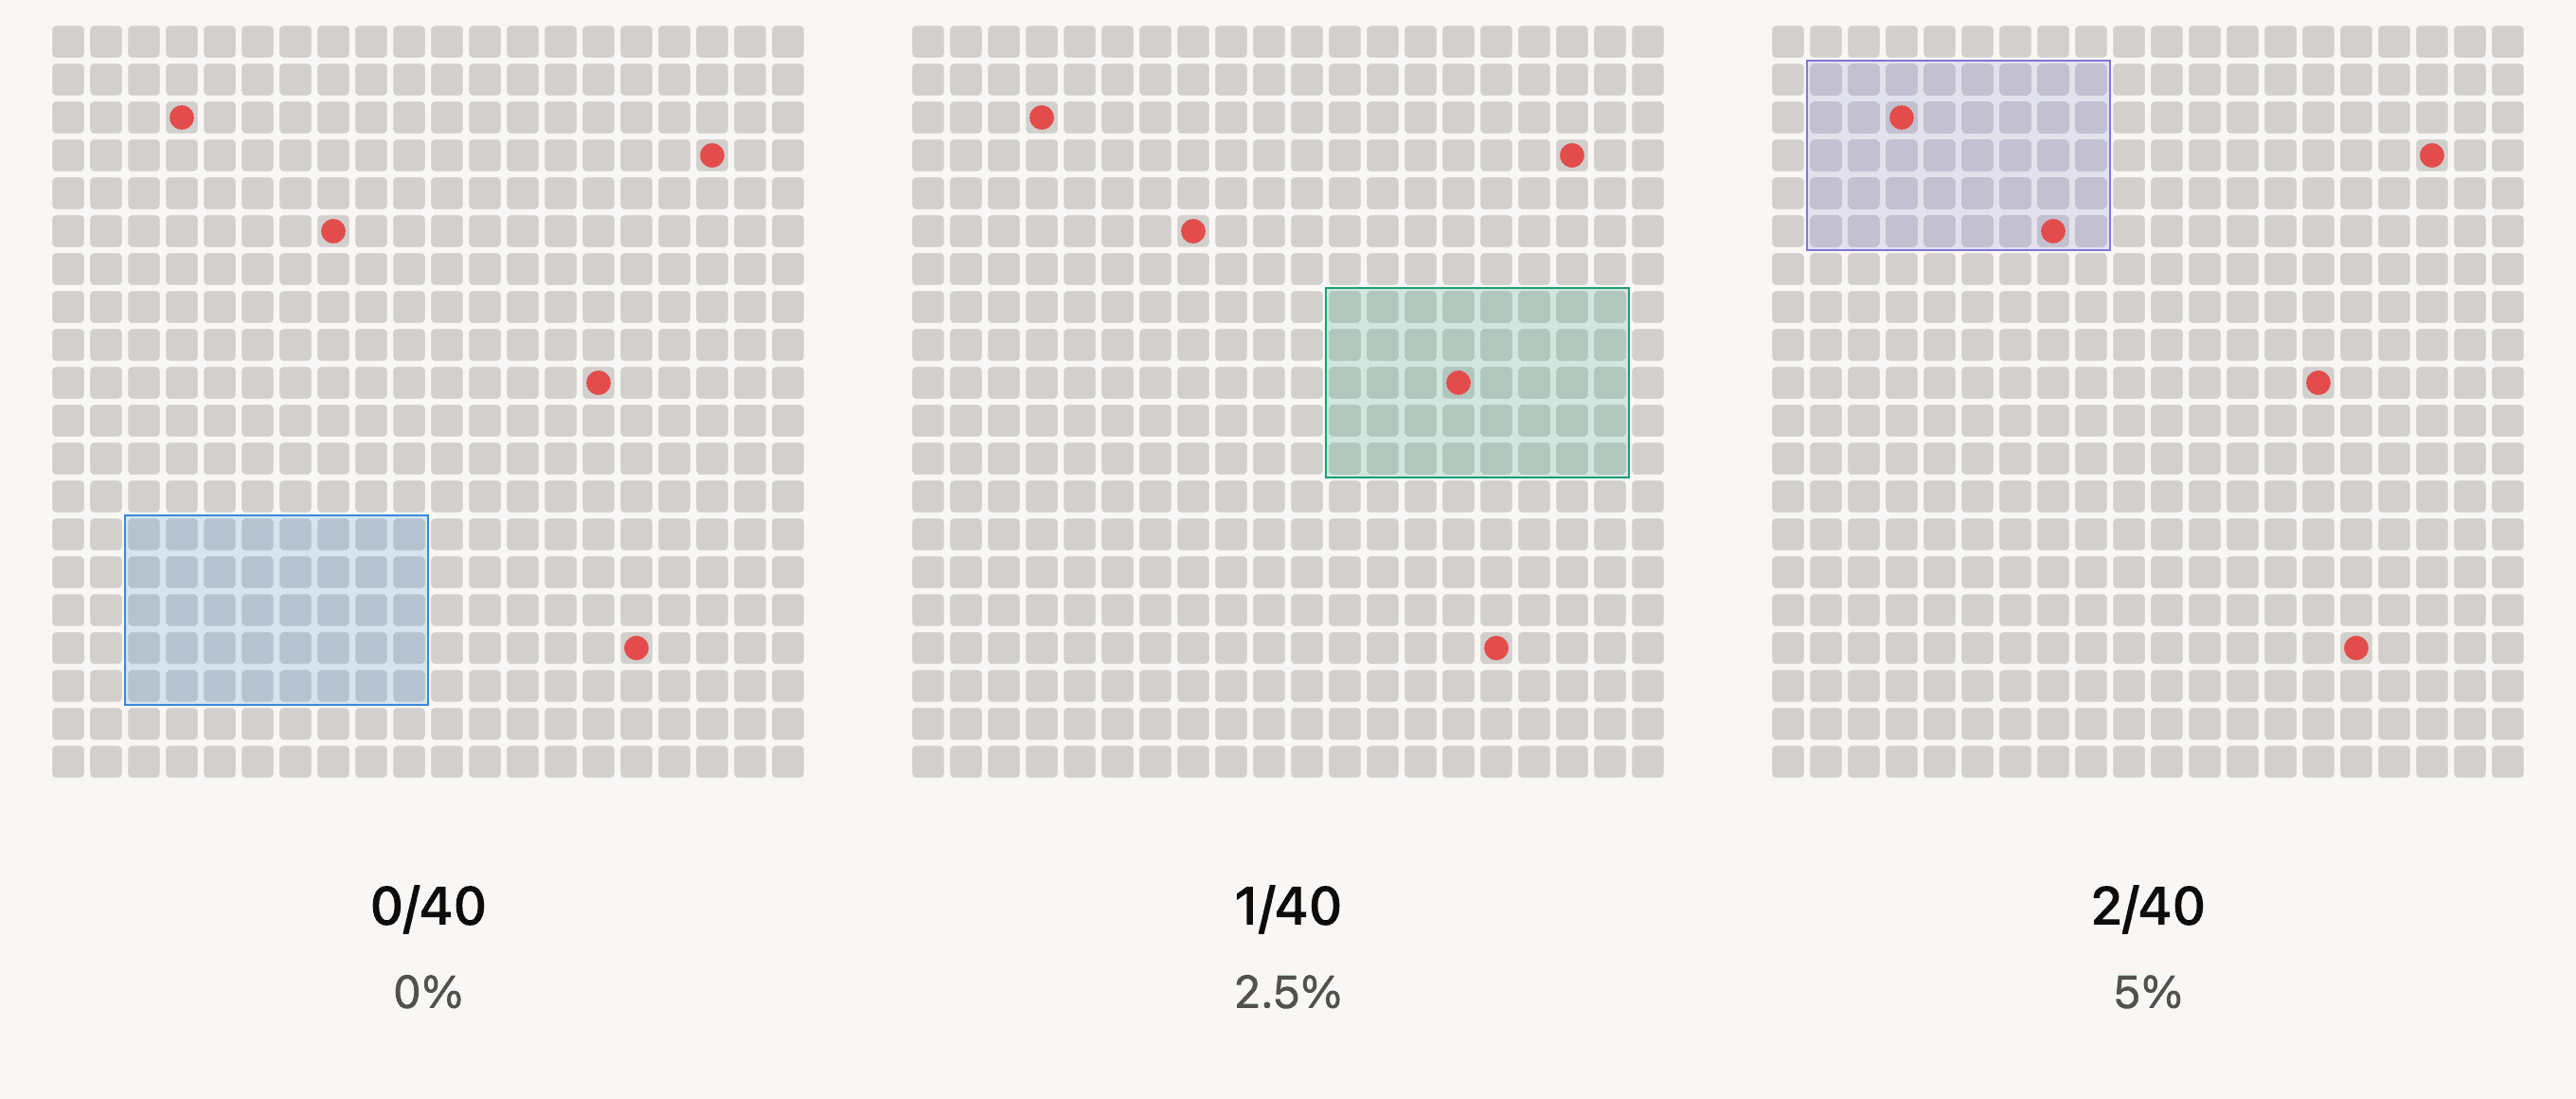
Jede dieser Stichproben weist eine andere Falsch-Negativ-Rate auf, und keine stimmt mit der „wahren“ Falsch-Negativ-Rate des Detektors von 1,25 % überein, die uns in Universum A zur Verfügung stand. Erwartungsgemäß würde eine Zufallsstichprobe von 40 Quadraten in diesem Raster einen halben roten Punkt erfassen. Abhängig von der Stichprobenziehung könnten jedoch auch keine roten Punkte erfasst werden (wie in der blauen Stichprobe), ein roter Punkt oder zwei rote Punkte (wie in der violetten Stichprobe). In einem besonders ungünstigen Fall könnten alle roten Punkte erfasst werden; in diesem Fall läge die beobachtete Falsch-Negativ-Rate bei 5/40 bzw. 12,5 %.
Ein solch unglücklicher Stichprobenfehler ist jedoch sehr unwahrscheinlich. Eine zufällige Stichprobe von 10 % der Daten liefert in 99 % der Fälle zwischen 0 und 2 Punkte – diese Spanne ergibt sich aus der sogenannten Stichprobenverteilung. Praktisch bedeutet das, dass die Stichprobengröße von 40 Fällen aus insgesamt 400 Fällen in Universum B den Unterschied zwischen einer zugrunde liegenden Falsch-Negativ-Rate von 0 % und einer von 5 % nicht wirklich aufzeigen kann. Je größer die Stichprobe, desto kleiner diese Spanne: Würden wir beispielsweise 125 Punkte aus insgesamt 400 auswählen, fänden wir in 99 % der Fälle zwischen 0 und 4 Punkte, was einer beobachteten Falsch-Negativ-Rate von 0–3,2 % entspräche.
Dieselbe Logik lässt sich auf unsere Gemini 3.1 Pro-Benchmarks anwenden, und die beiden unterschiedlichen falsch-negativen Ergebnisse widersprechen sich nicht. Der Unterschied mag Sie jedoch verunsichern, welchem Ergebnis Sie mehr vertrauen sollten. Generell ist die Stichprobengröße ausschlaggebend: Eine größere Stichprobe liefert ein repräsentativeres Bild und verringert die Fehlerwahrscheinlichkeit. Daher sollten Sie dem Benchmark im technischen Bericht mehr Vertrauen schenken und dieses Ergebnis lediglich als Anhaltspunkt betrachten.
Es gibt weitere Möglichkeiten, wie sich zwei Benchmark-Ergebnisse unterscheiden könnten. Anders als beim Beispiel mit dem Raster ist der von mir verwendete Benchmark-Datensatz keine exakte Teilmenge der 20.000 Chatbot Arena-Prompts aus dem technischen Bericht: Insgesamt wiesen die beiden Gemini 3.1 Pro-Benchmarks 286 identische Prompts auf. Daher besteht die Möglichkeit, dass 714 der von mir verwendeten Benchmark-Fragen besser geeignet waren , erkennbare KI-Ausgaben zu generieren, als die im technischen Bericht zu Pangram 4 verwendeten.
Das scheint nicht der Fall zu sein. Beide Datensätze schließen andere Sprachen, mathematische Aufgaben und Programmieraufgaben aus. Es gibt jedoch Unterschiede: Die mittlere Wortanzahl pro Antwort in Gemini 3.1 Pro war in meinem Datensatz höher als im Datensatz der technischen Berichte, und längere Texte lassen sich bekanntlich leichter bewerten. Doch welcher Datensatz ist ein fairer Test für das Modell? Wenn wir die Aufgabenlänge und die Stichprobengröße berücksichtigen, welcher Fragensatz würde Universum A besser repräsentieren?
Die ehrliche Antwort lautet: Ich weiß es nicht und kann es auch nicht sagen. Es ist schwierig, nahezu unmöglich, einen Datensatz zu erstellen, der die Realität perfekt und exakt abbildet. Das ist die zentrale Einschränkung der Statistik. Tatsächlich ist jeder Benchmark nur ein winziges Quadrat in einem Flickenteppich aus Stichproben, die die zugrundeliegende Realität des Universums A, also der Welt „da draußen“, annähern. Man könnte dies in gewisser Weise so interpretieren, dass alle Benchmark-Ergebnisse falsch sind, was zwar nicht falsch ist, aber nicht bedeutet, dass sie nutzlos sind. Indem wir viele verschiedene Ergebnisse auf vielen verschiedenen Datensätzen zusammenfügen, können wir uns einer guten Annäherung an die wahre, zugrundeliegende Realität annähern. Deshalb führen wir viele verschiedene Arten von Benchmarks durch, darunter solche, die modell-, sprach- , inhalts- und humanisierungsspezifisch sind.
Um eine bessere Annäherung zu erreichen, plane ich einige Verbesserungen an meinem Benchmark-Set-Generierungsprozess. Künftig werde ich die Auswahl der Chatbot-Arena-Prompts aus einem größeren Set randomisieren, anstatt für jede Modellversion dieselben Prompts zu verwenden. Außerdem werde ich meine Filter etwas lockern, um vielfältigere Prompts, wie z. B. technische Fragen, zu ermöglichen, und dem Pool zusätzliche Prompts hinzufügen, um die Art der Antworten zu diversifizieren.
Diese Blogbeiträge haben im Vergleich zum technischen Bericht eine geringere Bedeutung, aber das heißt nicht, dass wir nicht auch im Universum B nach Strenge streben sollten.
Fazit
Pangram ist robust gegenüber Gemini 3.8 Flash bei natürlichsprachlichen Eingabeaufforderungen und erkennt es mit einer Genauigkeit von 99,80 %. Gemini 3.1 Pro wird mit einer Genauigkeit von 99,70 % erkannt, was insgesamt 1.995 von 2.000 (99,75 %) über beide Modelle hinweg ergibt. Pangram kann auf neue Modelle generalisieren, da neue Modellversionen in der Regel viel vom Stil und der Sprachausgabe ihrer Vorgänger übernehmen . Daher muss Pangram nicht für jede neue Version neu trainiert werden.
Hier sehen Sie, wie Gemini 3.8 Flash und Gemini 3.1 Pro im Vergleich zu unseren Benchmarks anderer aktueller Frontier-Modelle abschneiden:
| Modell | Als KI erkannt | Genauigkeit |
|---|---|---|
| Gemini 3.8 Blitz | 998/1.000 | 99.80% |
| Gemini 3.1 Pro | 997/1.000 | 99.70% |
| Claude Opus 5.5 | 997/1.000 | 99.70% |
| Fabel 5.1 | 1.093/1.097 | 99.64% |
| Claude Opus 5 | 1.105/1.107 | 99.82% |
| GPT-5.6 | 3.408/3.423 | 99.56% |
| Claude Sonett 5 | 1.145/1.147 | 99.83% |
| Gemini 3 | 28/28 | 100% |
Wenn Sie ein bestimmtes Dokument überprüfen möchten, können Sie es hier mit Pangram versuchen.
Weiterführende Literatur
Drei Prozent der Rezensionen auf der Startseite von Amazon werden mittlerweile von KI generiert
Pangram zeigt bei verschiedenen Schüleraufsätzen 0 Fehlalarme an
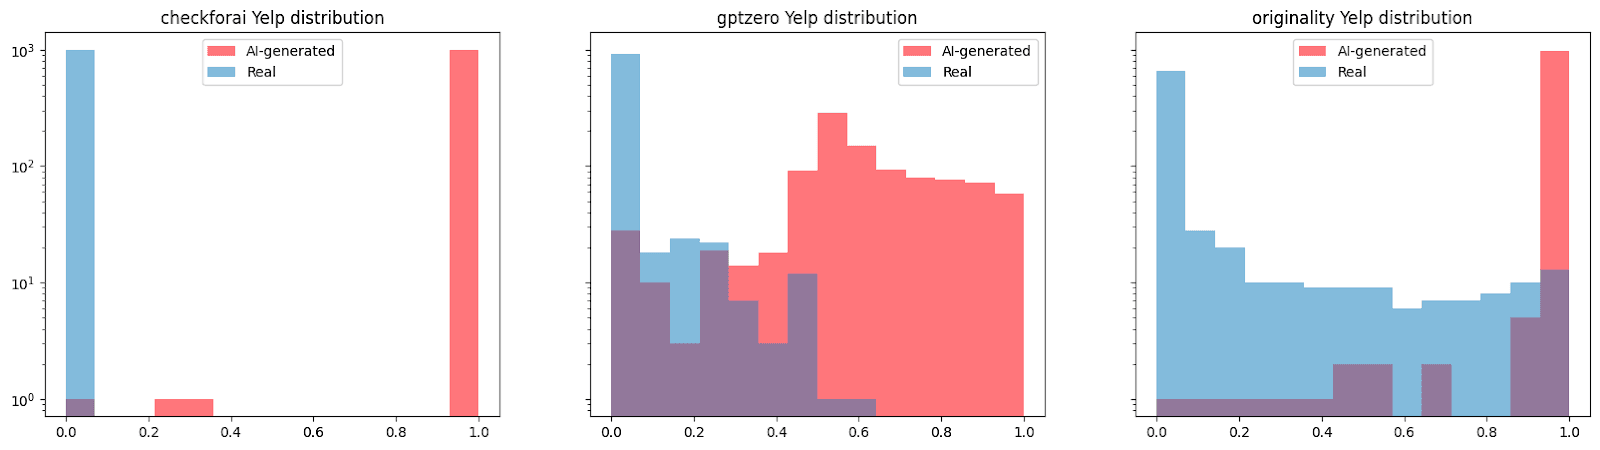
Ein tiefer Einblick in Yelp-Bewertungen

Pangrams Leistung bei einem Schwarm kollaborierender Agenten
KI hilft beim Verfassen von fast 50 % der Pressemitteilungen
Bewertungen von Pangrammen durch Dritte

