
Hier eine kurze Zusammenfassung
Von 986 Eingabeaufforderungen erreicht Pangram 4 eine Genauigkeit von 99,59 % bei den GPT-6 Astra-Ausgaben.
Von 986 aus Chatbot Arena stammenden Eingabeaufforderungen klassifizierte Pangram 4 drei Ausgaben von GPT-6 Astra als gemischt, eine als vollständig menschlich und 982 als vollständig KI-generiert, was einer Genauigkeit von 99,59 % bei GPT-6 Astra entspricht.
Im Folgenden werden die falsch negativen Ergebnisse nach Kategorien aufgeschlüsselt.
Der Benchmark wurde mithilfe einer gefilterten Teilmenge der ersten Chatbot-Arena-Aufforderungen aus dem LMSYS- Datensatz (Zheng et al., 2023) generiert. Ich habe Aufforderungen herausgefiltert, die nach Code, Mathematik, sehr kurzen oder sehr langen Antworten oder unpassendem kreativen Schreiben fragten. Anschließend habe ich diese Aufforderungen GPT-6 Astra übergeben und die Ausgabe mit Pangram 4 analysiert.
Ergebnisse nach Kategorie
| Kategorie | Beispiele | KI | Gemischt | Mensch |
|---|---|---|---|---|
| Argumente | 16 | 16 | 0 | 0 |
| E-Mails / Briefe | 57 | 56 | 1 | 0 |
| Aufsätze / Artikel | 34 | 34 | 0 | 0 |
| Erläuterungen | 547 | 546 | 1 | 0 |
| Gedichte und andere kreative Texte | 183 | 181 | 1 | 1 |
| Rezensionen | 7 | 7 | 0 | 0 |
| Geschichten | 142 | 142 | 0 | 0 |
| Gesamt | 986 | 982 | 3 | 1 |
Die drei gemischten Ergebnisse waren ein Gedicht, eine kurze Erklärung und eine E-Mail.
Astra neigt dazu, kurze Fragen sehr kurz zu beantworten. Insgesamt habe ich für diesen Benchmark-Test 1032 Fragen gestellt, aber 46 Antworten von Astra 6 lagen unter dem von Pangram vorgegebenen Mindestwortlimit von 50 Wörtern und wurden daher nicht bewertet.
Fazit
Pangram ist gegenüber GPT-6 Astra bei natürlichsprachlichen Eingabeaufforderungen robust und erkennt diese mit einer Genauigkeit von 99,59 %. Da neue Modellversionen in der Regel viel vom Stil und der Ausdrucksweise ihrer Vorgänger übernehmen , kann Pangram auf neue Modelle generalisieren, sodass es nicht für jede neue Version neu trainiert werden muss.
Hier sehen Sie, wie GPT-6 Astra im Vergleich zu unseren Benchmarks anderer aktueller Spitzenmodelle abschneidet:
| Modell | Als KI erkannt | Genauigkeit |
|---|---|---|
| Claude Sonett 5.5 | 1.019/1.022 | 99.71% |
| Gemini 3.8 Blitz | 998/1.000 | 99.80% |
| Gemini 3.1 Pro | 997/1.000 | 99.70% |
| Claude Opus 5.5 | 997/1.000 | 99.70% |
| Fabel 5.1 | 1.093/1.097 | 99.64% |
| Claude Opus 5 | 1.105/1.107 | 99.82% |
| GPT-5.6 | 3.408/3.423 | 99.56% |
| Claude Sonett 5 | 1.145/1.147 | 99.83% |
| Gemini 3 | 28/28 | 100% |
Wenn Sie ein bestimmtes Dokument überprüfen möchten, können Sie es hier mit Pangram versuchen.
Weiterführende Literatur
Kann Pangram Gemini 3.8 Flash und Gemini 3.1 Pro erkennen?
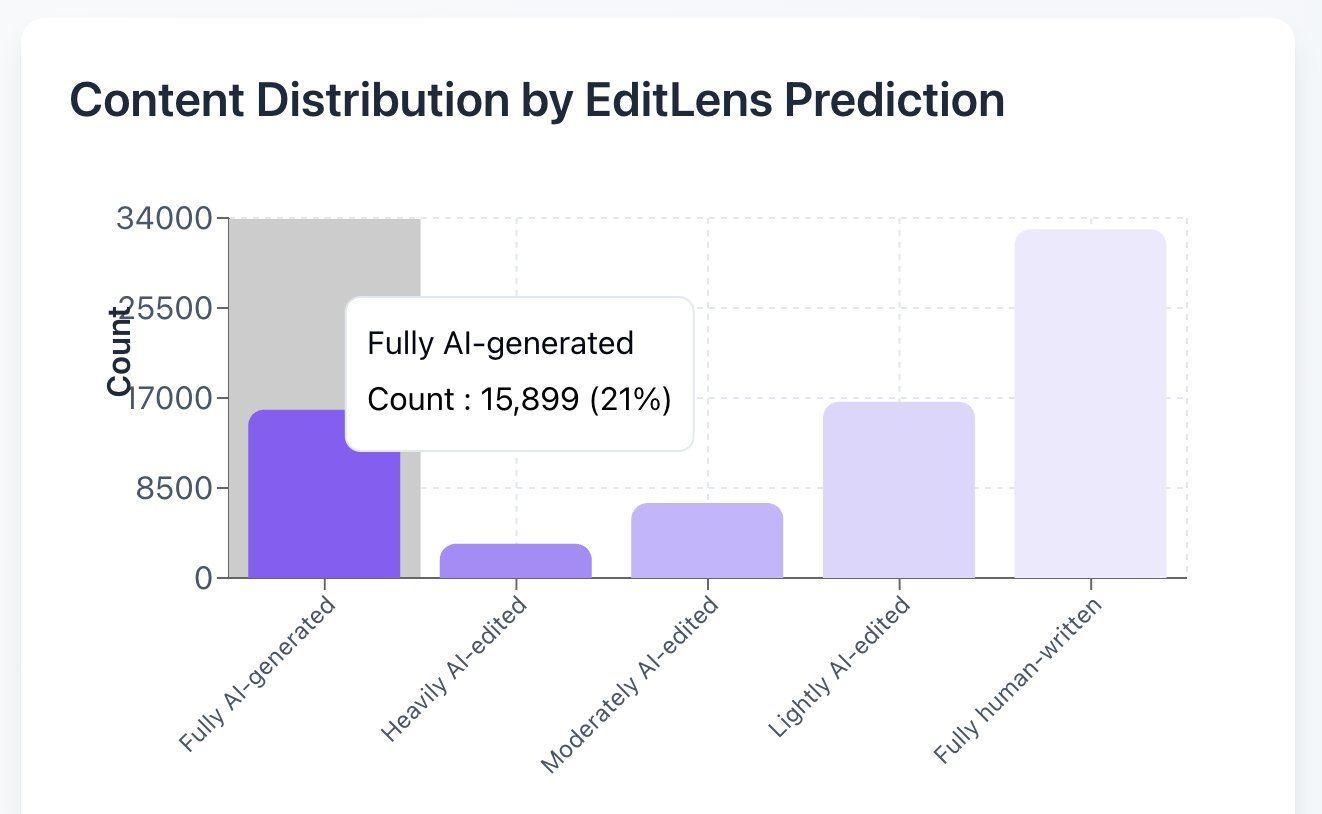
Pangram schätzt, dass 21 % der ICLR-Rezensionen von KI generiert sind
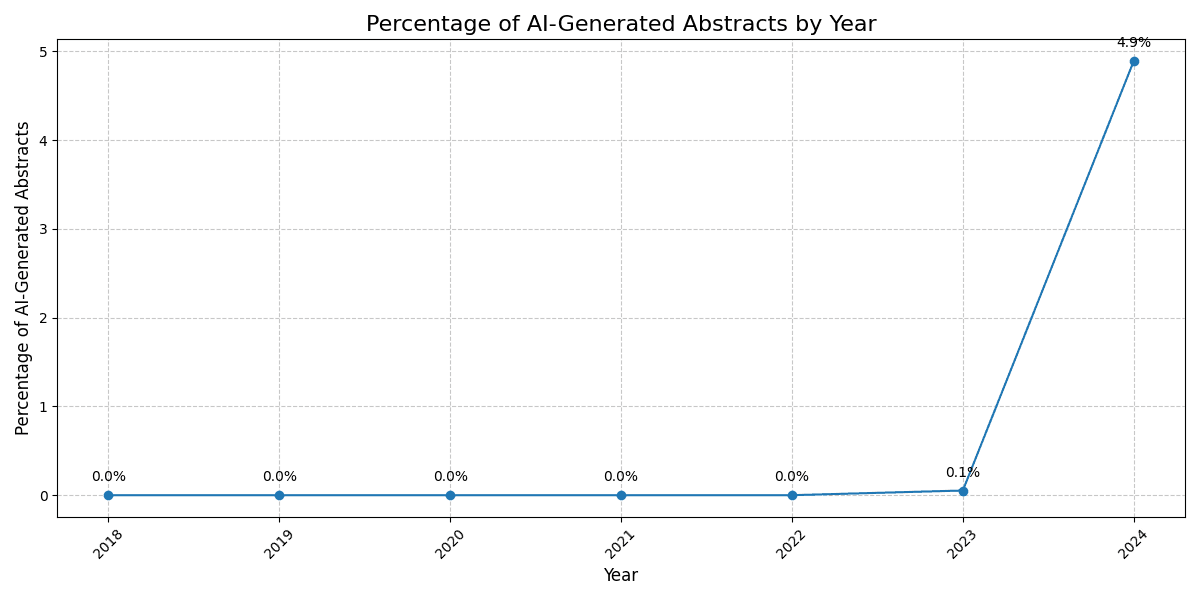
KI-Konferenzbeiträge werden zunehmend von KI verfasst: Anstieg um 370 % seit 2023
Welcher KI-Detektor ist am genauesten? 30 Tools im Test (2026)
Wie man KI-Bewertungen erkennt
Kann Pangram Claude Opus 5.5 erkennen?

