Hier eine kurze Zusammenfassung
Von insgesamt 2.215 Eingabeaufforderungen erreicht Pangram 4.1 bei GPT-6.1 Sol eine Genauigkeit von 98,73 % bei hoher Komplexität und eine Genauigkeit von 98,83 % bei mittlerer Komplexität, was einer Gesamtgenauigkeit von 98,78 % über beide Einstellungen hinweg entspricht.
GPT-6.1 Sol ist ein KI-Modell, das am 29. September 2026 von OpenAI veröffentlicht wurde. OpenAI behauptet, dass GPT-6.1 Sol bei verschiedenen arbeitsbezogenen Aufgaben wie Programmieren und der Nutzung von Computern „Astra-ähnliche Intelligenz zu einem Fünftel des Preises“ bietet. Im Gegensatz zu den meisten neueren Veröffentlichungen, die wir in letzter Zeit gesehen haben, macht OpenAI keine Angaben zur Schreibfähigkeit oder Klarheit von GPT-6.1 Sol. Schreibt es also genauso wie frühere Modelle, und kann Pangram es erkennen?
Wir haben die Leistung von Pangram 4.1 anhand von 2.215 Beispielanfragen getestet und festgestellt, dass Pangram 4.1 6 GPT-6.1-Sol-Ausgaben als von Menschen erstellt, 21 als gemischt und 2.188 als vollständig KI-generiert klassifiziert hat, was einer Genauigkeit von 98,78 % bei GPT-6.1 Sol entspricht.
| Modell | Beispiele | Erkennungsrate |
|---|---|---|
| GPT-6.1 Sol (hohe Denkfähigkeit) | 1,105 | 98.73% |
| GPT-6.1 Sol (mittleres Schlussfolgerungsvermögen) | 1,110 | 98.83% |
Zur Erstellung des Benchmark-Satzes haben wir 1.200 Prompts der ersten Runde aus dem LMSYS-Datensatz (Zheng et al., 2023) verwendet. Diese haben wir anschließend GPT-6.1 Sol mit den Einstellungen „medium“ und „high“ für die Schlussfolgerungsfähigkeit vorgelegt und die Ausgabe mit Pangram 4.1 ausgewertet.
Ergebnisse nach Kategorie
Insgesamt wies GPT-6.1 Sol bei 1.105 Antworten im Bereich „hohes Denkvermögen“ eine Falsch-Negativ-Rate von 1,27 % und bei 1.110 Antworten im Bereich „mittleres Denkvermögen“ eine Falsch-Negativ-Rate von 1,17 % auf. Insgesamt gab es keinen signifikanten Unterschied in der Erkennungsrate zwischen dem mittleren und dem hohen Denkvermögen (p = 0,85).
Hohes logisches Denkvermögen
Als GPT-6.1 Sol auf „hohe Schlussfolgerungsfähigkeit“ eingestellt war, stufte Pangram 4.1 drei Antworten als „menschlich“, elf als „gemischt“ und 1.091 als „vollständig KI-generiert“ ein, was einer Recall-Rate von 98,73 % entsprach.
| Kategorie | Beispiele | KI | Gemischt | Mensch |
|---|---|---|---|---|
| Argumente | 64 | 64 | 0 | 0 |
| E-Mails / Briefe | 53 | 52 | 1 | 0 |
| Aufsätze / Artikel | 137 | 136 | 1 | 0 |
| Erläuterungen | 481 | 477 | 3 | 1 |
| Gedichte und andere kreative Texte | 97 | 94 | 2 | 1 |
| Geschichten | 89 | 89 | 0 | 0 |
| Programmierung und Mathematik | 10 | 10 | 0 | 0 |
| Rollenspiele und Spiele | 42 | 42 | 0 | 0 |
| Sonstiges | 132 | 127 | 4 | 1 |
| Gesamt | 1,105 | 1,091 | 11 | 3 |
Mittleres logisches Denken
Bei mittlerer Argumentationskomplexität stufte Pangram 4.1 drei Antworten als von Menschen verfasst, zehn als gemischt und 1.097 als vollständig von der KI erstellt ein und erreichte damit eine Recall-Rate von 98,83 %.
| Kategorie | Beispiele | KI | Gemischt | Mensch |
|---|---|---|---|---|
| Argumente | 64 | 64 | 0 | 0 |
| E-Mails / Briefe | 55 | 55 | 0 | 0 |
| Aufsätze / Artikel | 138 | 137 | 1 | 0 |
| Erläuterungen | 481 | 474 | 5 | 2 |
| Gedichte und andere kreative Texte | 99 | 96 | 2 | 1 |
| Rezensionen | 1 | 1 | 0 | 0 |
| Geschichten | 85 | 85 | 0 | 0 |
| Programmierung und Mathematik | 10 | 10 | 0 | 0 |
| Rollenspiele und Spiele | 42 | 42 | 0 | 0 |
| Sonstiges | 135 | 133 | 2 | 0 |
| Gesamt | 1,110 | 1,097 | 10 | 3 |
Wie klingt „Sol“?
GPT-6.1 Sol hat einen unverwechselbaren Stil bei der Zeichensetzung; so verwendet es beispielsweise in 74 % seiner Antworten geschwungene Apostrophe und fast nie gerade Apostrophe, insbesondere im Vergleich zu anderen aktuellen Modellen.
| GPT-6.1 Sol | Claude Haiku 5.5 | Gemini 4 Argon | |
|---|---|---|---|
| Geschwungenes Apostroph ’ | 73.9% | 0.0% | 9.1% |
| Einfaches Apostroph ' innerhalb eines Wortes | 0.5% | 75.4% | 48.5% |
| Geschwungene doppelte Anführungszeichen „ “ | 39.0% | <0.1% | <0.1% |
Außerdem verwendet es sowohl Em-Striche als auch En-Striche sehr gerne und setzt im Durchschnitt 1,3 Em-Striche pro 1.000 Wörter ein – weit mehr als Haiku 5.5 oder Gemini 4 Argon.
| GPT-6.1 Sol | Claude Haiku 5.5 | Gemini 4 Argon | |
|---|---|---|---|
| Antworten mit einem Gedankenstrich — | 29.7% | 0.1% | 12.1% |
| Lange Striche pro 1.000 Wörter | 1.32 | <0.01 | 0.85 |
| Antworten mit einem Halbgeviertstrich – | 11.4% | 0.4% | 0.4% |
Beim kreativen Schreiben zeigte GPT-6.1 Sol einige Eigenheiten. Es bevorzugte es stark, seine weiblichen Figuren entweder Mara oder Maya zu nennen (wobei mindestens eine dieser Namen in 65 Antworten vorkam), und gab ihnen im Allgemeinen die Initialen M.V., wobei es insgesamt den Nachnamen Vale bevorzugte (es tauchten jedoch auch Mara Velez und Mara Venn auf). Bei den männlichen Vornamen ist „Daniel“ der Favorit von GPT-6.1 Sol, den es nur zweimal mit einem Nachnamen kombinierte (einmal mit „Vale“ und einmal mit „Mercer“). Von den 418 kreativen Schreibantworten begann GPT-6.1 Sol 36 Mal mit „Der erste…“; eine deutlich höhere Quote als bei Haiku und Gemini, die dies jeweils 11 Mal bzw. 1 Mal taten.
Sol weigerte sich, 23 Anfragen zu beantworten, und lehnte weitere 32 Anfragen teilweise ab. Bei den teilweisen Ablehnungen lieferte Sol eine abgeschwächte oder abweichende Version dessen, was angefordert worden war. Die meisten dieser teilweisen Ablehnungen sind darauf zurückzuführen, dass unser Prompt-Set zufällig auch anzügliche kreative Schreibaufträge enthielt. Sol ging damit so um, dass er darauf verzichtete, explizite Inhalte zu verfassen, und stattdessen einen „Fade to Black“ einbaute.
Sol schreibt manchmal sehr kurze Antworten: 95 davon umfassen höchstens 50 Wörter, 90 davon liegen im mittleren Bereich. Der Median der von Sol verfassten Antworten lag bei 300 Wörtern, wobei die Spanne von 50 bis 10.513 Wörtern reichte.
Frühere Benchmarks
Pangram ist gegenüber GPT-6.1 Sol bei Prompts in natürlicher Sprache robust und erkennt das Modell bei hohem Denkvermögen mit einer beobachteten Genauigkeit von 98,73 %. Bei mittlerem Denkvermögen erkennt Pangram GPT-6.1 Sol mit einer beobachteten Genauigkeit von 98,83 %, was insgesamt 2.188 von 2.215 Fällen (98,78 %) über beide Einstellungen hinweg ergibt. Pangram lässt sich auf neue Modelle übertragen, da neue Modellversionen in der Regel einen Großteil des Stils und der Ausdrucksweise ihrer Vorgänger übernehmen, sodass Pangram nicht für jede neue Version neu trainiert werden muss.
Hier sehen Sie, wie GPT-6.1 Sol im Vergleich zu unseren Benchmarks anderer aktueller Pioniermodelle abschneidet:
| Modell | Als KI erkannt | Genauigkeit |
|---|---|---|
| Claude Haiku 5.5 | 1.179/1.183 | 99.66% |
| Gemini 4 Argon | 1.159/1.174 | 98.72% |
| Gemini 3.8 Blitz | 998/1.000 | 99.80% |
| Gemini 3.1 Pro | 997/1.000 | 99.70% |
| Claude Sonett 5.5 | 1.019/1.022 | 99.71% |
| Claude Opus 5.5 | 997/1.000 | 99.70% |
| GPT-6 Astra | 982/986 | 99.59% |
| Fabel 5.1 | 1.093/1.097 | 99.64% |
| Claude Opus 5 | 1.105/1.107 | 99.82% |
| GPT-5.6 | 3.408/3.423 | 99.56% |
| Claude Sonett 5 | 1.145/1.147 | 99.83% |
Wenn Sie ein bestimmtes Dokument überprüfen möchten, können Sie es hier mit Pangram versuchen.
Weiterführende Literatur
Bewertungen von Pangrammen durch Dritte
Pangram schätzt, dass 21 % der ICLR-Rezensionen von KI generiert sind
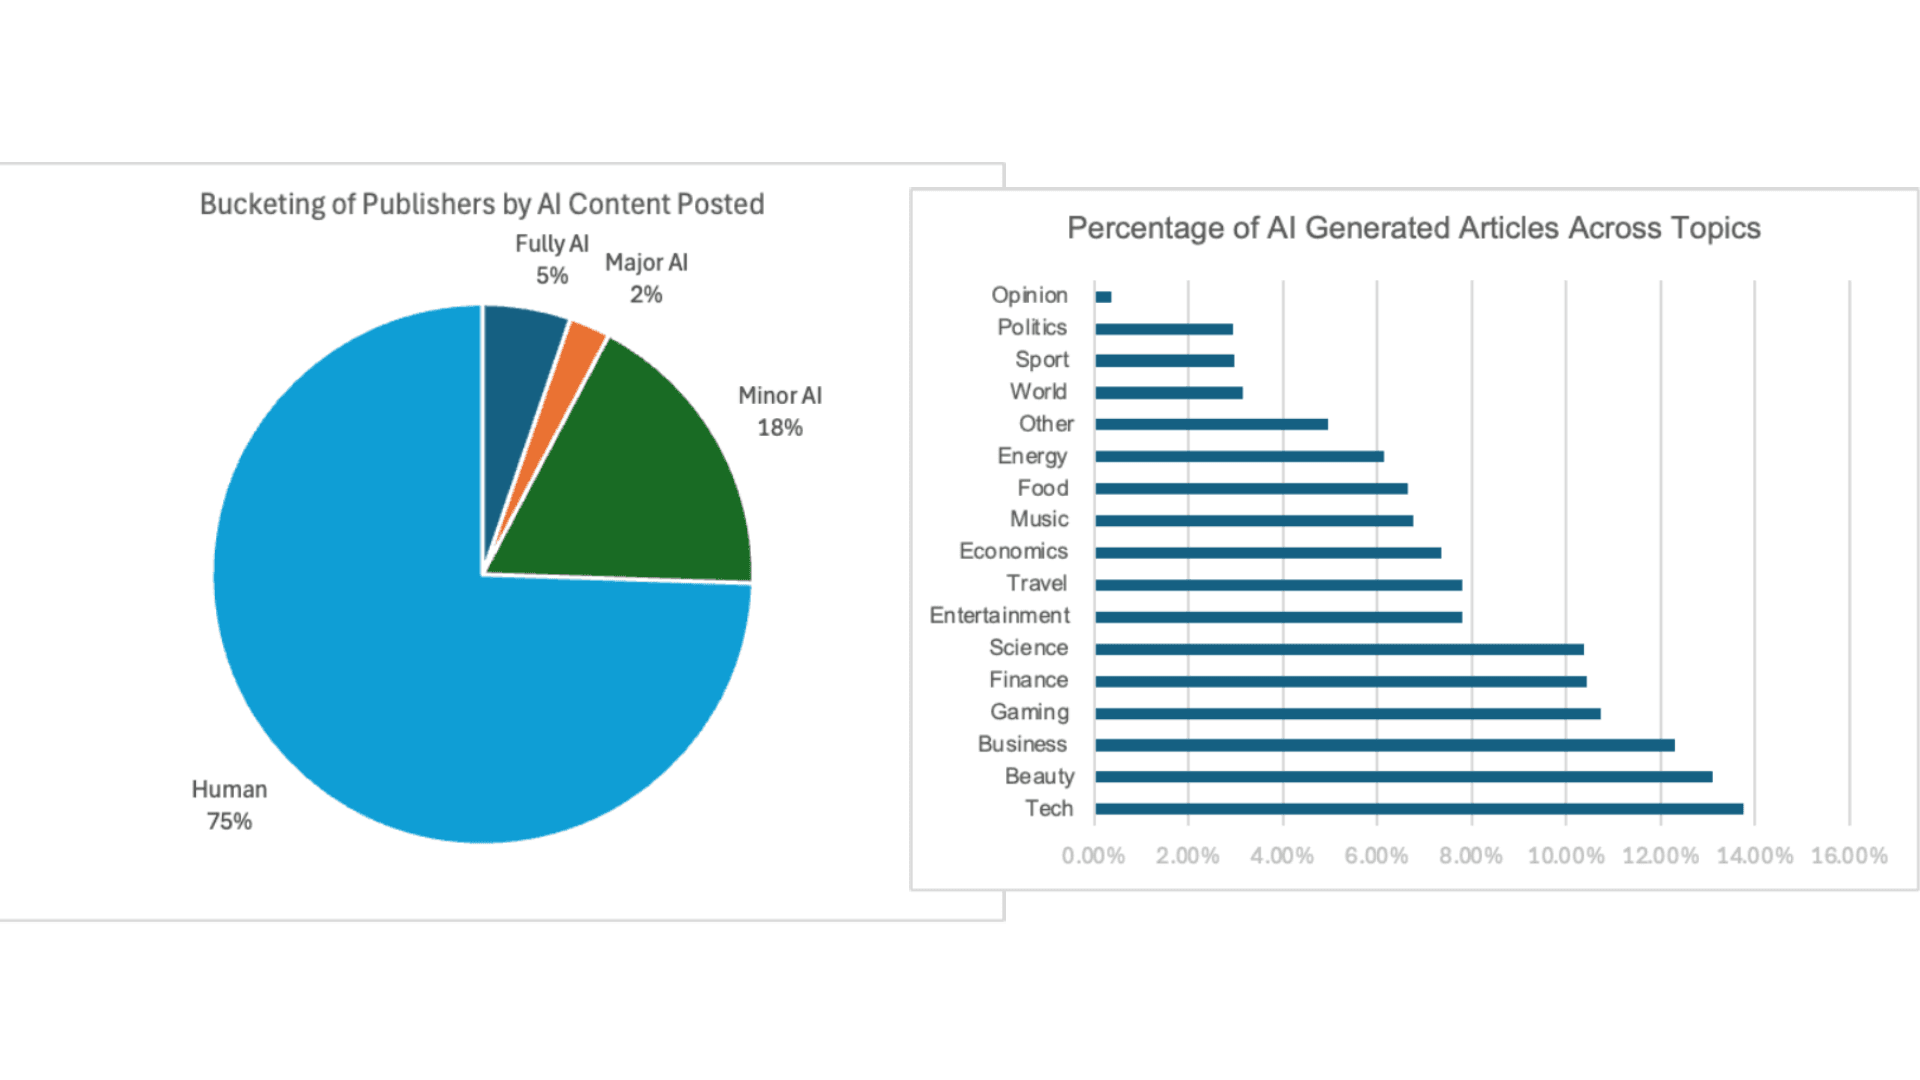
Jeden Tag werden 60.000 KI-generierte Nachrichtenartikel veröffentlicht
Wie Gradpilot mit Hilfe von Pangram Schülern dabei hilft, ihren eigenen Stil zu finden
KI verfasst preisgekrönte Belletristik