¿Puede Pangram detectar Gemini 3.8 Flash y Gemini 3.1 Pro?
Además, se abordará la selección de indicadores de referencia, la distribución de la muestra y la finalidad de la estadística.

Aquí tienes un breve resumen
De 1000 indicaciones, Pangram 4 logra una precisión del 99,80 % en las salidas de Gemini 3.8 Flash y una precisión del 99,70 % en las salidas de Gemini 3.1 Pro, para una precisión total del 99,75 % en la última versión de la familia Gemini para este conjunto de pruebas de referencia.
De 1000 ejemplos de lenguaje natural, Pangram 4 clasificó dos salidas de Gemini 3.8 Flash como humanas y 998 como generadas completamente por IA, logrando una precisión del 99,80 % en Gemini 3.8 Flash. En Gemini 3.1 Pro (lanzado el 19 de febrero de 2026), Pangram clasificó una salida como mixta, dos como completamente humanas y 997 como generadas completamente por IA, logrando una precisión del 99,70 % en Gemini 3.1 Pro.
Para generar el conjunto de referencia, utilicé un subconjunto filtrado de las indicaciones de la primera ronda de Chatbot Arena del conjunto de datos LMSYS (Zheng et al., 2023). Filtré las indicaciones que solicitaban código, matemáticas, respuestas muy cortas o muy largas, o escritura creativa inapropiada. Luego, las proporcioné a Gemini 3.8 Flash y Gemini 3.1 Pro y procesé el resultado con Pangram 4 .
A continuación, analizamos los resultados de detección por categoría, los falsos negativos, el rendimiento de Gemini 3.1 Pro en pruebas comparativas anteriores, así como algunas deficiencias y posibles mejoras futuras en la selección de indicaciones para la entrada del blog.
Resultados por categoría
Por categoría de indicación (asignada por los agentes de Haiku), así fue el rendimiento de Pangram 4 en 1000 salidas de Gemini 3.8 Flash:
| Categoría | Ejemplos | IA | Misto | Humano |
|---|---|---|---|---|
| Argumentos | 18 | 18 | 0 | 0 |
| Correos electrónicos / cartas | 54 | 53 | 0 | 1 |
| Ensayos / artículos | 33 | 33 | 0 | 0 |
| Explicaciones | 563 | 563 | 0 | 0 |
| Poemas | 108 | 107 | 0 | 1 |
| Otros textos de creación literaria | 75 | 75 | 0 | 0 |
| Opiniones | 7 | 7 | 0 | 0 |
| Historias | 142 | 142 | 0 | 0 |
| Total | 1,000 | 998 | 0 | 2 |
Y aquí están los resultados por categoría para Gemini 3.1 Pro:
| Categoría | Ejemplos | IA | Misto | Humano |
|---|---|---|---|---|
| Argumentos | 18 | 18 | 0 | 0 |
| Correos electrónicos / cartas | 55 | 55 | 0 | 0 |
| Ensayos / artículos | 33 | 33 | 0 | 0 |
| Explicaciones | 559 | 559 | 0 | 0 |
| Poemas y otros textos creativos | 182 | 179 | 1 | 2 |
| Opiniones | 7 | 7 | 0 | 0 |
| Historias | 146 | 146 | 0 | 0 |
| Total | 1,000 | 997 | 1 | 2 |
Uno de los falsos negativos de Gemini 3.8 Flash se produjo en una solicitud que pedía al modelo que humanizara los resultados , añadiendo errores ortográficos y tipográficos:
Escribe una carta con errores tipográficos y ortográficos a un clan (Raid Shadow Legends, también soy nivel 10, un jugador nuevo) llamado HelpWanted. Haz que sea una carta corta y muy persuasiva.
Pangram 4 omitió ambas versiones de Penguinmandias de los modelos, al igual que cuando fue generado por Opus 5.5 . La indicación es:
Escríbeme un poema de Club Penguin al estilo de Ozymandias.
En el caso de Gemini 3.1 Pro, el 71 % de las palabras de Penguinmandias coinciden con el poema original de Shelley, por lo que considero que se trata de un falso negativo de poca importancia. Gemini 3.1 Pro también detectó otros dos errores, ambos relacionados con poemas.
¿Qué define un resultado de referencia?
En nuestro informe técnico sobre Pangram 4, realizamos una prueba de falsos negativos con 520 000 resultados de IA de 26 modelos diferentes, lo que equivale a 20 000 respuestas por modelo. Uno de los modelos analizados en el informe fue Gemini 3.1 Pro, que también probamos aquí. Sin embargo, como podrá comprobar en el informe técnico, encontramos una tasa de falsos negativos diferente y más alta en ese conjunto de resultados que en este. ¿Por qué?
Una respuesta es que, estadísticamente, no son diferentes. Los 3 errores de respuesta en 1000 respuestas que encontramos aquí se traducen en una tasa de falsos negativos (FNR) observada del 0,3 %, con un intervalo de confianza del 95 % de entre el 0,06 % y el 0,87 %. La FNR que figura en el informe técnico es de 111 errores de respuesta en 20 000 preguntas, o una FNR del 0,555 %, que se encuentra dentro de ese rango.
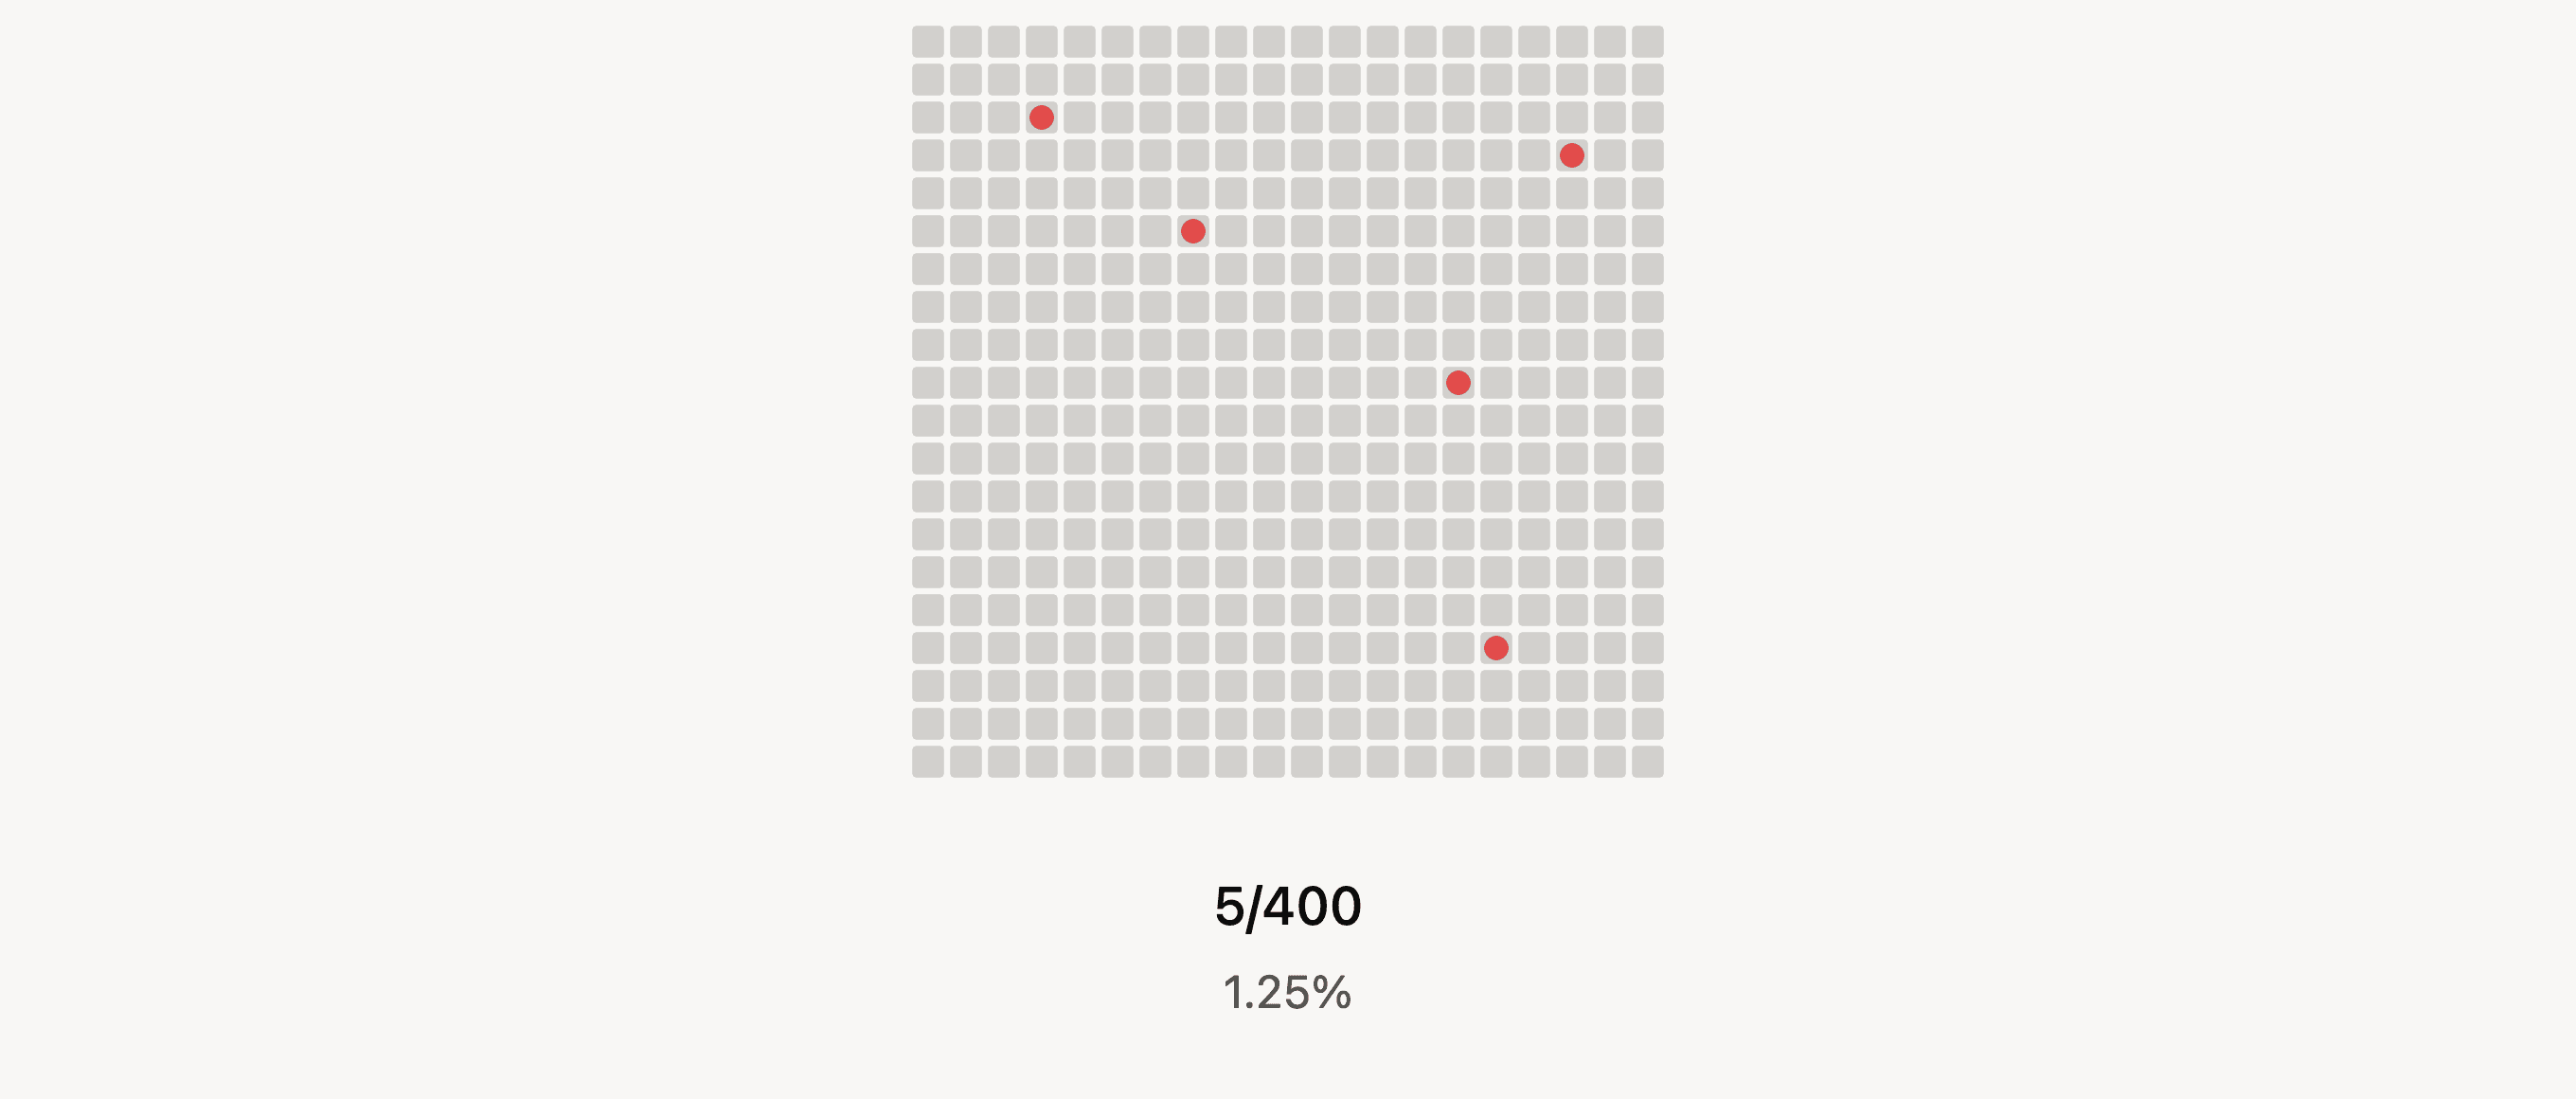
Pero ¿qué quiero decir cuando afirmo que esos números no son estadísticamente diferentes? Digamos que tengo un conjunto grande de 400 casos de prueba que sé a priori que son positivos, y quiero probar si algún detector los etiqueta correctamente como positivos o si etiqueta erróneamente algunos como negativos. En el universo A, pruebo los 400 ejemplos y encuentro que 5 están etiquetados erróneamente como negativos (representados a continuación como puntos rojos), lo que se traduce en una tasa de falsos negativos del 1,25 % para mi detector en todo el conjunto. ¡Genial!
En el universo B, por otro lado, por una razón u otra, mis recursos son limitados. Solo puedo permitirme probar una pequeña parte de los 400 ejemplos. Esto significa que debo tomar una muestra, idealmente aleatoria, y realizar la prueba. Digamos que puedo permitirme probar 40 ejemplos, o el 10 % de mi conjunto total. A continuación, se muestran tres maneras diferentes de seleccionar ese conjunto, cada una con una tasa de falsos negativos distinta.
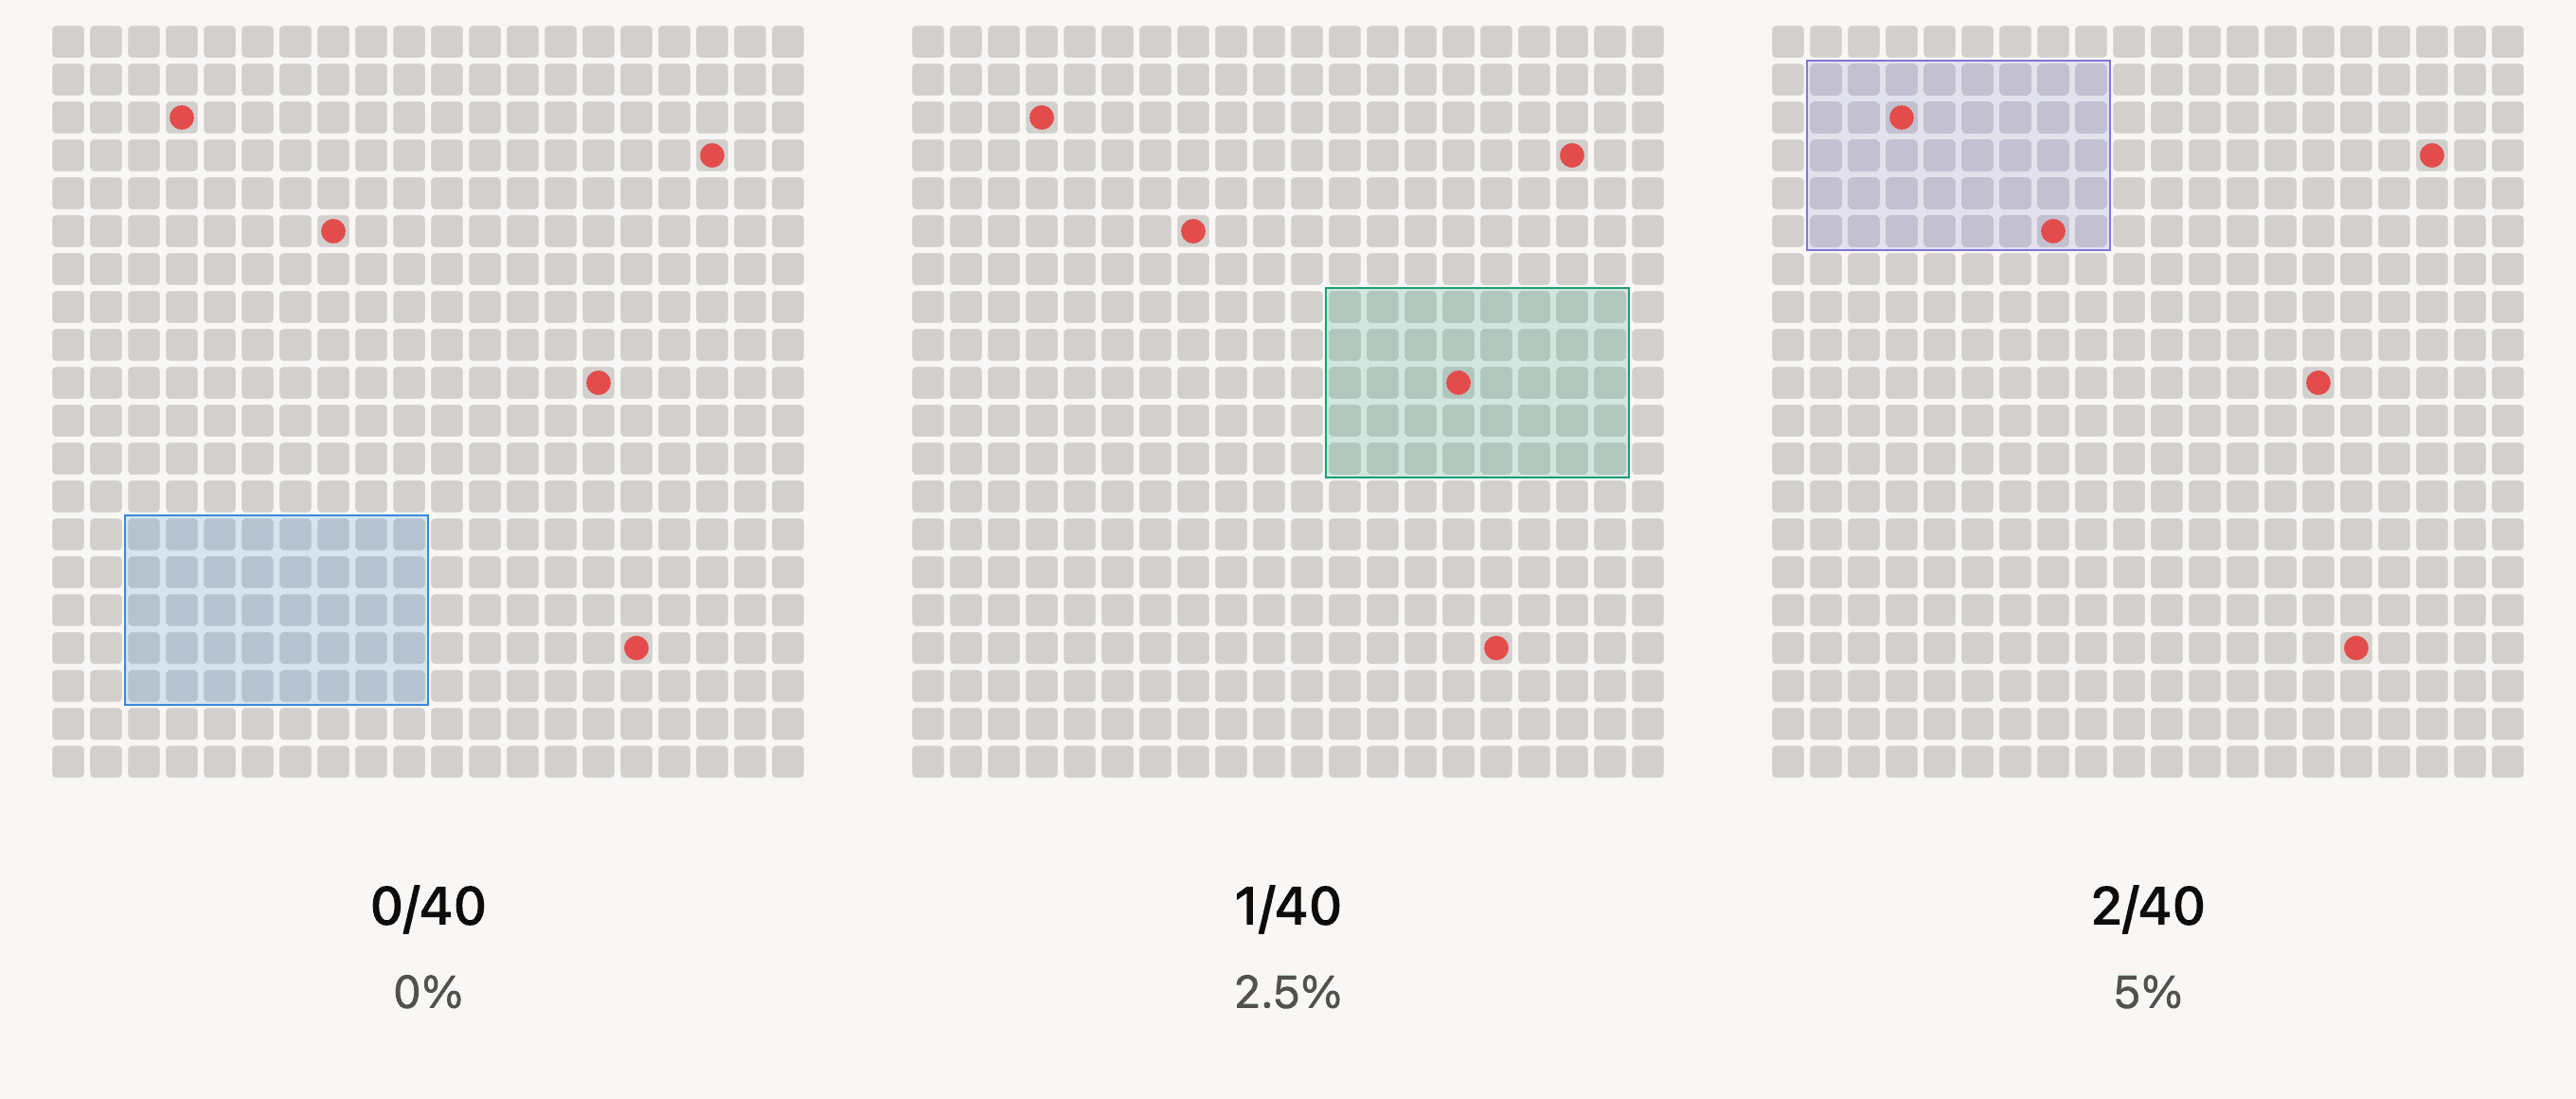
Cada una de estas muestras reporta una tasa de falsos negativos diferente, y ninguna coincide con la tasa de falsos negativos "real" del detector del 1,25% a la que tuvimos acceso en el universo A. En teoría, una muestra aleatoria de 40 cuadrados en esta cuadrícula detectaría medio punto rojo, pero dependiendo del muestreo, podría no detectar ningún punto rojo, como en la muestra azul, un punto rojo o dos puntos rojos, como en la morada. Una muestra muy desafortunada podría detectar todos los puntos rojos, y en ese caso la tasa de falsos negativos observada sería de 5/40, o 12,5%.
Una muestra tan desafortunada es muy improbable. Una muestra aleatoria del 10 % del conjunto encontrará entre 0 y 2 puntos el 99 % de las veces; este rango proviene de lo que se denomina distribución muestral. En la práctica, esto significa que el tamaño de la muestra del universo B, de 40 casos de un total de 400 posibles, no puede distinguir entre una tasa subyacente de falsos negativos del 0 % y una del 5 %. Cuanto mayor sea la muestra, menor será este rango: si, por ejemplo, tomáramos una muestra de 125 puntos de un total de 400, encontraríamos entre 0 y 4 puntos el 99 % de las veces, o una tasa observada de falsos negativos del 0 % al 3,2 %.
La misma lógica se aplica a nuestras pruebas de rendimiento de Gemini 3.1 Pro, y los dos resultados de falsos negativos no son contradictorios. Sin embargo, la diferencia podría generar dudas sobre cuál es más fiable. Generalmente, el factor clave para decidirlo es el tamaño de la muestra: una muestra mayor ofrece una visión más representativa y reduce el margen de error. Por lo tanto, siguiendo esta lógica, conviene confiar más en la prueba de rendimiento del informe técnico y considerar esta como una mera indicación.
Existen otras maneras en que dos resultados de referencia podrían diferir. A diferencia del ejemplo de la cuadrícula, el conjunto de datos de referencia que he estado utilizando no es un subconjunto estricto de las 20 000 preguntas de Chatbot Arena que se utilizaron en el informe técnico: en total, las dos pruebas de referencia de Gemini 3.1 Pro compartieron 286 preguntas exactas. Esto deja abierta la posibilidad de que 714 de las preguntas de referencia que utilicé fueran más favorables para generar resultados de IA detectables que las utilizadas en el informe técnico de Pangram 4.
No parece ser el caso. Ambos conjuntos excluyen otros idiomas, matemáticas y código. Sin embargo, existen diferencias: la mediana de palabras por respuesta de Gemini 3.1 Pro fue mayor en mi conjunto en comparación con el conjunto de informes técnicos, y es más fácil puntuar textos más largos, como sabemos . Pero, ¿cuál es una prueba más justa del modelo? Si controláramos la longitud de la respuesta y el tamaño de la muestra, ¿qué conjunto de preguntas representaría mejor el universo A?
La respuesta sincera es que no lo sé y no puedo decirlo. Es difícil, casi imposible, crear un conjunto que sea perfecta y exactamente representativo del mundo real. Esa es la limitación fundamental de la estadística. En realidad, cada prueba de rendimiento es un pequeño cuadrado en un mosaico de muestras que se aproximan a la realidad subyacente del universo A, o el mundo "exterior". En cierto sentido, esto podría interpretarse como que todos los resultados de las pruebas de rendimiento son erróneos, lo cual no es falso, pero eso no significa que no sean útiles. Al combinar muchos resultados diferentes en muchos tipos de conjuntos distintos, podemos acercarnos a una buena aproximación de la verdadera realidad subyacente. Por eso realizamos muchos tipos diferentes de pruebas de rendimiento, incluidas aquellas específicas para modelos, idiomas , contenido y humanizadores .
Para lograr una mejor aproximación, tengo en mente algunas mejoras que me gustaría implementar en mi proceso de generación de conjuntos de referencia. En adelante, seleccionaré aleatoriamente las preguntas de Chatbot Arena a partir de un conjunto más amplio, en lugar de usar las mismas preguntas en cada versión del modelo. También flexibilizaré ligeramente los filtros para permitir preguntas más variadas, como preguntas técnicas, y añadiré algunas preguntas adicionales al conjunto para diversificar el tipo de respuesta que obtenemos.
Estas entradas de blog tienen poca trascendencia en comparación con el informe técnico, pero eso no significa que no debamos aspirar al rigor, incluso en el universo B.
Conclusión
Pangram es robusto frente a Gemini 3.8 Flash en indicaciones de lenguaje natural y lo detecta con una precisión observada del 99,80 %. Detecta Gemini 3.1 Pro con una precisión observada del 99,70 %, para un total combinado de 1995 de 2000 (99,75 %) en ambos modelos. Pangram es capaz de generalizar a nuevos modelos porque las nuevas versiones tienden a heredar gran parte del estilo y la voz de sus predecesores , por lo que no necesita ser reentrenado para cada nueva versión.
Aquí te mostramos cómo se comparan Gemini 3.8 Flash y Gemini 3.1 Pro con nuestros resultados de pruebas de otros modelos fronterizos recientes:
| Modelo | Detectado como IA | Precisión |
|---|---|---|
| Géminis 3.8 Flash | 998/1.000 | 99.80% |
| Gemini 3.1 Pro | 997/1.000 | 99.70% |
| Claude Opus 5.5 | 997/1.000 | 99.70% |
| Fábula 5.1 | 1.093/1.097 | 99.64% |
| Claude, Op. 5 | 1.105/1.107 | 99.82% |
| GPT-5.6 | 3.408/3.423 | 99.56% |
| Claude Soneto 5 | 1.145/1.147 | 99.83% |
| Géminis 3 | 28/28 | 100% |
Si quieres consultar un documento concreto, puedes probar Pangram aquí.
Lecturas relacionadas
El tres por ciento de las reseñas que aparecen en la primera página de Amazon están generadas por IA
Pangram no detecta ningún falso positivo en diversos redacciones de los alumnos
Análisis en profundidad de las reseñas de Yelp

Rendimiento de Pangram en un enjambre de agentes que actúan en colusión
La IA ayuda a redactar casi el 50 % de los comunicados de prensa
Evaluaciones de pangramas realizadas por terceros

