Pangram peut-il détecter Gemini 3.8 Flash et Gemini 3.1 Pro ?
De plus, une discussion sur la sélection des consignes de référence, la distribution des échantillons et l'intérêt des statistiques sera abordée.

Voici un bref résumé
Sur 1 000 invites, Pangram 4 atteint une précision de 99,80 % sur les sorties Gemini 3.8 Flash et une précision de 99,70 % sur les sorties Gemini 3.1 Pro, pour une précision totale de 99,75 % sur la dernière version de la famille Gemini pour cet ensemble de référence.
Sur 1 000 exemples de langage naturel, Pangram 4 a classé deux productions Gemini 3.8 Flash comme étant d'origine humaine et 998 comme étant entièrement générées par l'IA, atteignant ainsi une précision de 99,80 % sur Gemini 3.8 Flash. Sur Gemini 3.1 Pro (sortie prévue le 19 février 2026), Pangram a classé une production comme mixte, deux comme étant entièrement humaines et 997 comme étant entièrement générées par l'IA, atteignant ainsi une précision de 99,70 % sur Gemini 3.1 Pro.
Pour générer l'ensemble de référence, j'ai utilisé un sous-ensemble filtré des premières invites de Chatbot Arena issues du jeu de données LMSYS (Zheng et al., 2023). J'ai éliminé les invites demandant du code, des mathématiques, des réponses très courtes ou très longues, ou des textes créatifs inappropriés. J'ai ensuite soumis ces invites à Gemini 3.8 Flash et Gemini 3.1 Pro, puis j'ai analysé leurs résultats avec Pangram 4 .
Nous discutons ci-dessous des résultats de détection par catégorie, des faux négatifs, des performances de Gemini 3.1 Pro sur les précédents tests de performance, ainsi que de certaines lacunes et améliorations futures de ma sélection d'invites pour l'article de blog.
Résultats par catégorie
Par catégorie d'invite (attribuée par les agents Haiku), voici les résultats obtenus avec Pangram 4 sur 1 000 sorties Gemini 3.8 Flash :
| Catégorie | Exemples | IA | Mixte | Humain |
|---|---|---|---|---|
| Arguments | 18 | 18 | 0 | 0 |
| E-mails / lettres | 54 | 53 | 0 | 1 |
| Essais / articles | 33 | 33 | 0 | 0 |
| Explications | 563 | 563 | 0 | 0 |
| Poèmes | 108 | 107 | 0 | 1 |
| Autres textes de création littéraire | 75 | 75 | 0 | 0 |
| Avis | 7 | 7 | 0 | 0 |
| Récits | 142 | 142 | 0 | 0 |
| Total | 1,000 | 998 | 0 | 2 |
Voici les résultats par catégorie pour Gemini 3.1 Pro :
| Catégorie | Exemples | IA | Mixte | Humain |
|---|---|---|---|---|
| Arguments | 18 | 18 | 0 | 0 |
| E-mails / lettres | 55 | 55 | 0 | 0 |
| Essais / articles | 33 | 33 | 0 | 0 |
| Explications | 559 | 559 | 0 | 0 |
| Poèmes et autres écrits créatifs | 182 | 179 | 1 | 2 |
| Avis | 7 | 7 | 0 | 0 |
| Récits | 146 | 146 | 0 | 0 |
| Total | 1,000 | 997 | 1 | 2 |
L'un des faux négatifs de Gemini 3.8 Flash concernait une invite demandant au modèle d' humaniser les résultats , en y ajoutant des fautes d'orthographe et des coquilles :
Rédigez une lettre contenant des fautes d'orthographe et de frappe à l'attention d'un clan (Raid Shadow Legends, je suis niveau 10 et un nouveau joueur) nommé HelpWanted. Faites une lettre courte et très persuasive.
Pangram 4 n'a pas inclus les deux versions de Penguinmandias, tout comme lors de sa génération par Opus 5.5 . L'invite est :
Écris-moi un poème de Club Penguin dans le style d'Ozymandias.
Pour Gemini 3.1 Pro, 71 % des mots de « Penguinmandias » sont communs au poème original de Shelley ; il s’agit donc, à mon avis, d’un faux négatif peu préoccupant. Gemini 3.1 Pro a également détecté deux autres erreurs, concernant deux poèmes.
Qu'est-ce qui constitue un résultat de référence ?
Dans notre rapport technique sur Pangram 4, nous avons effectué un test de faux négatifs sur 520 000 sorties d'IA issues de 26 modèles différents, soit 20 000 réponses par modèle. Parmi ces modèles figurait Gemini 3.1 Pro, que nous avons également testé ici. Or, comme vous le constaterez en consultant le rapport technique, le taux de faux négatifs est différent et plus élevé sur cet ensemble de sorties que sur le nôtre. Pourquoi ?
Une explication possible est que la différence est due à la taille de l'échantillon, de sorte que les deux valeurs ne reflètent pas des taux de détection statistiquement distincts. Les 3 erreurs de détection sur 1 000 réponses que nous avons constatées correspondent à un taux de faux négatifs (FNR) observé de 0,3 %, avec un intervalle de confiance à 95 % compris entre 0,06 % et 0,87 %. Le FNR indiqué dans le rapport technique est de 111 erreurs de détection sur 20 000 sollicitations, soit un FNR de 0,555 %, ce qui se situe dans cet intervalle.
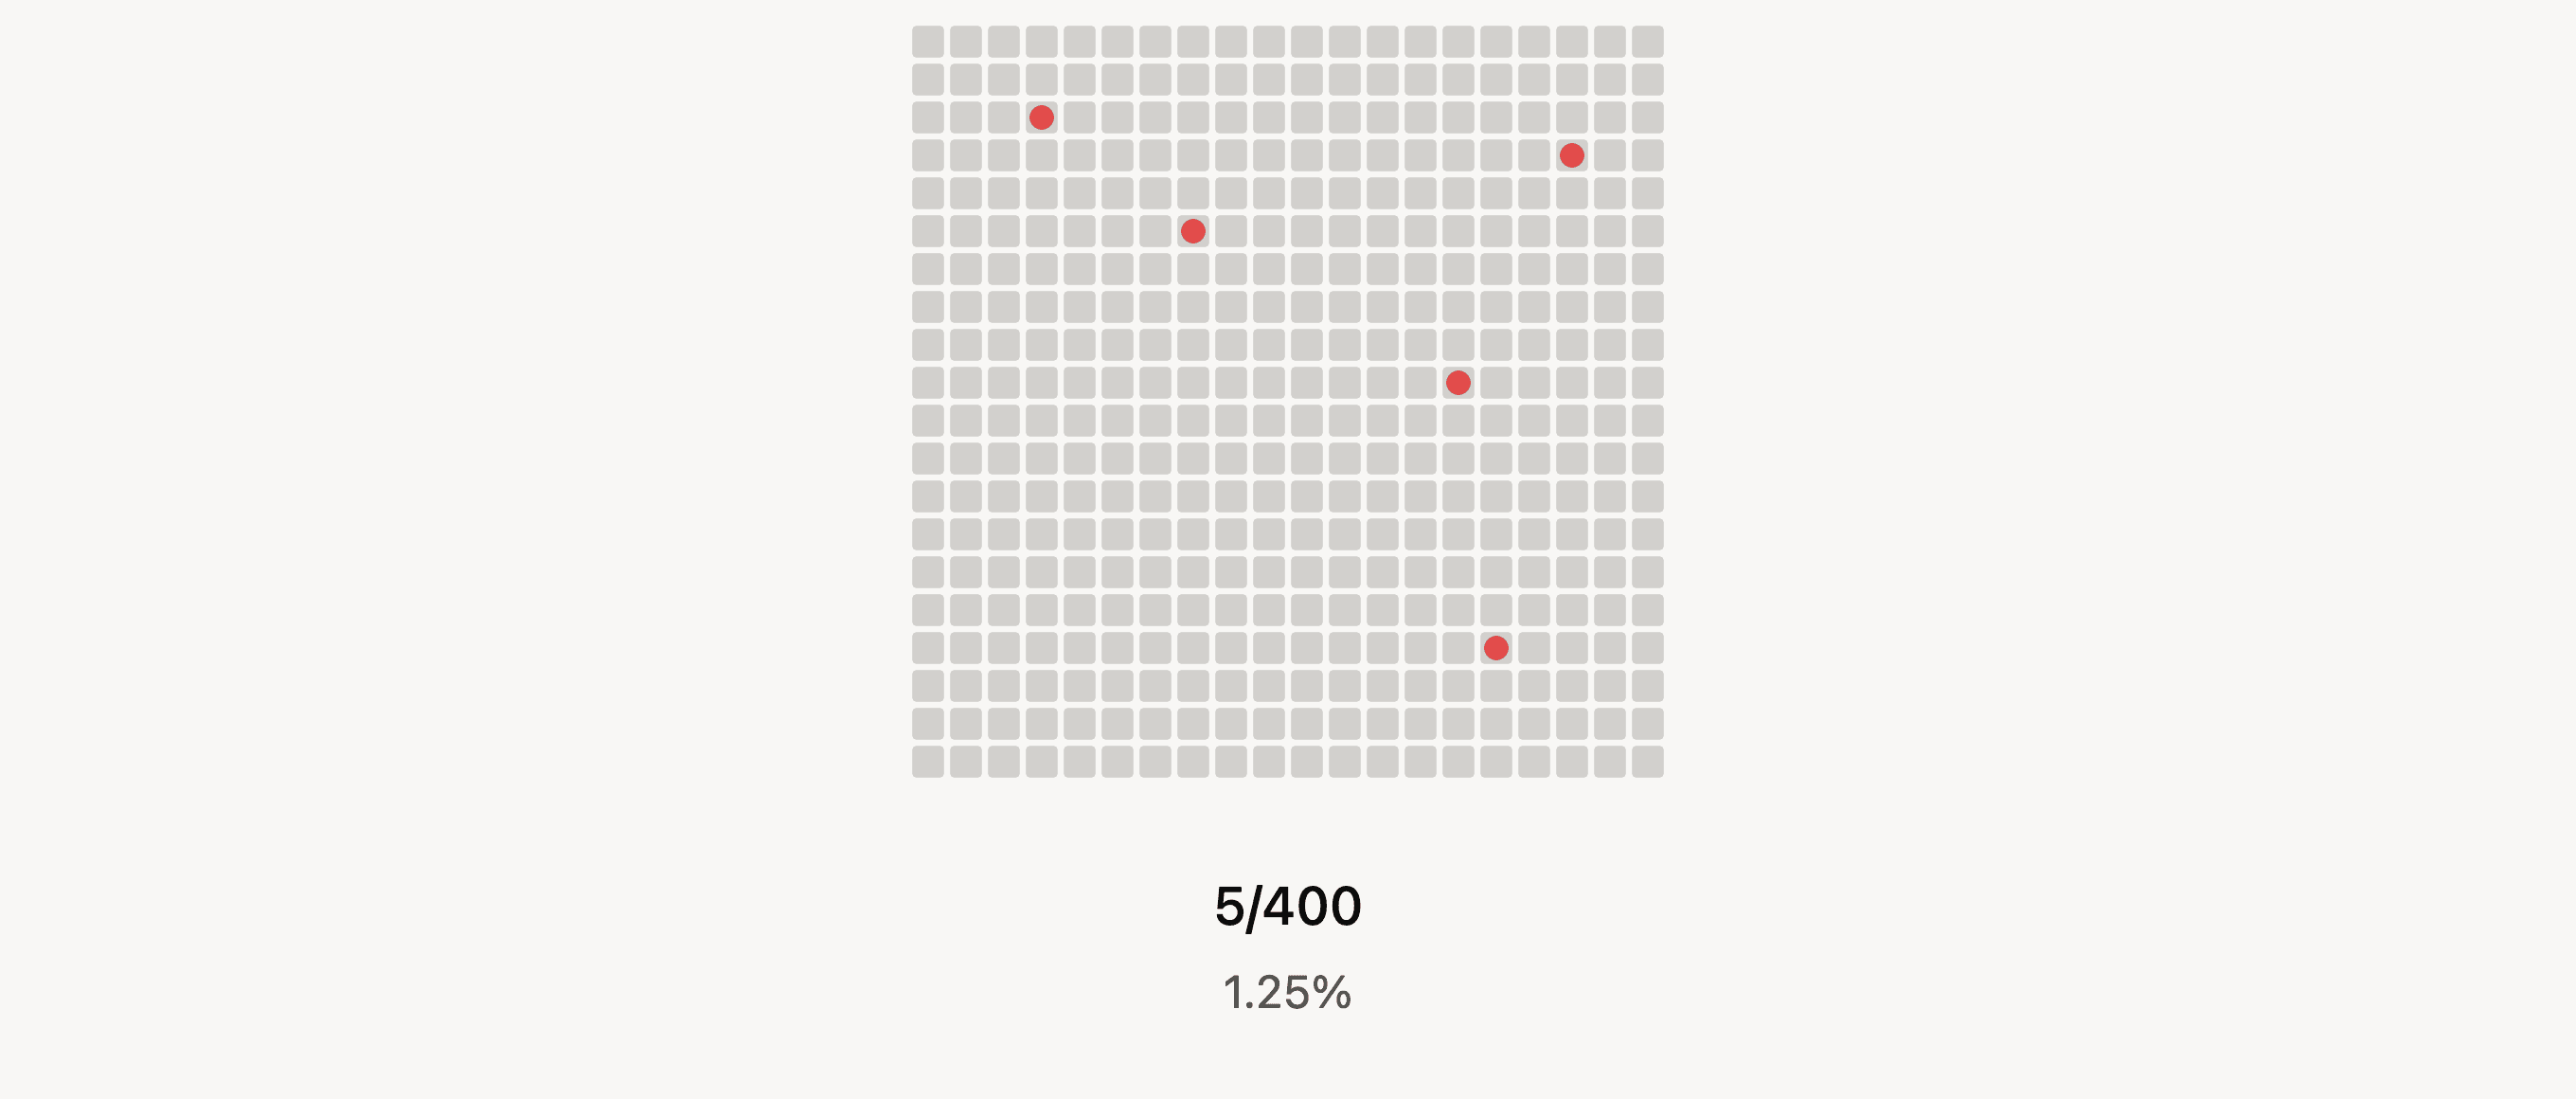
On peut envisager la question autrement. Imaginons un vaste ensemble de 400 cas de test que je sais a priori positifs, et que je souhaite vérifier si un détecteur les identifie correctement comme positifs ou s'il en identifie certains par erreur comme négatifs. Dans l'univers A, je teste les 400 exemples et constate que 5 sont identifiés par erreur comme négatifs (représentés ci-dessous par des points rouges), ce qui correspond à un taux de faux négatifs de 1,25 % pour mon détecteur sur l'ensemble des cas. Excellent !
Dans l'univers B, en revanche, pour une raison ou une autre, mes ressources sont limitées. Je ne peux tester qu'une petite partie des 400 exemples. Je dois donc prélever un échantillon, idéalement aléatoire, et effectuer les tests dessus. Supposons que je puisse tester 40 exemples, soit 10 % de mon ensemble total. Voici trois manières différentes de sélectionner cet ensemble, chacune entraînant un taux de faux négatifs différent.
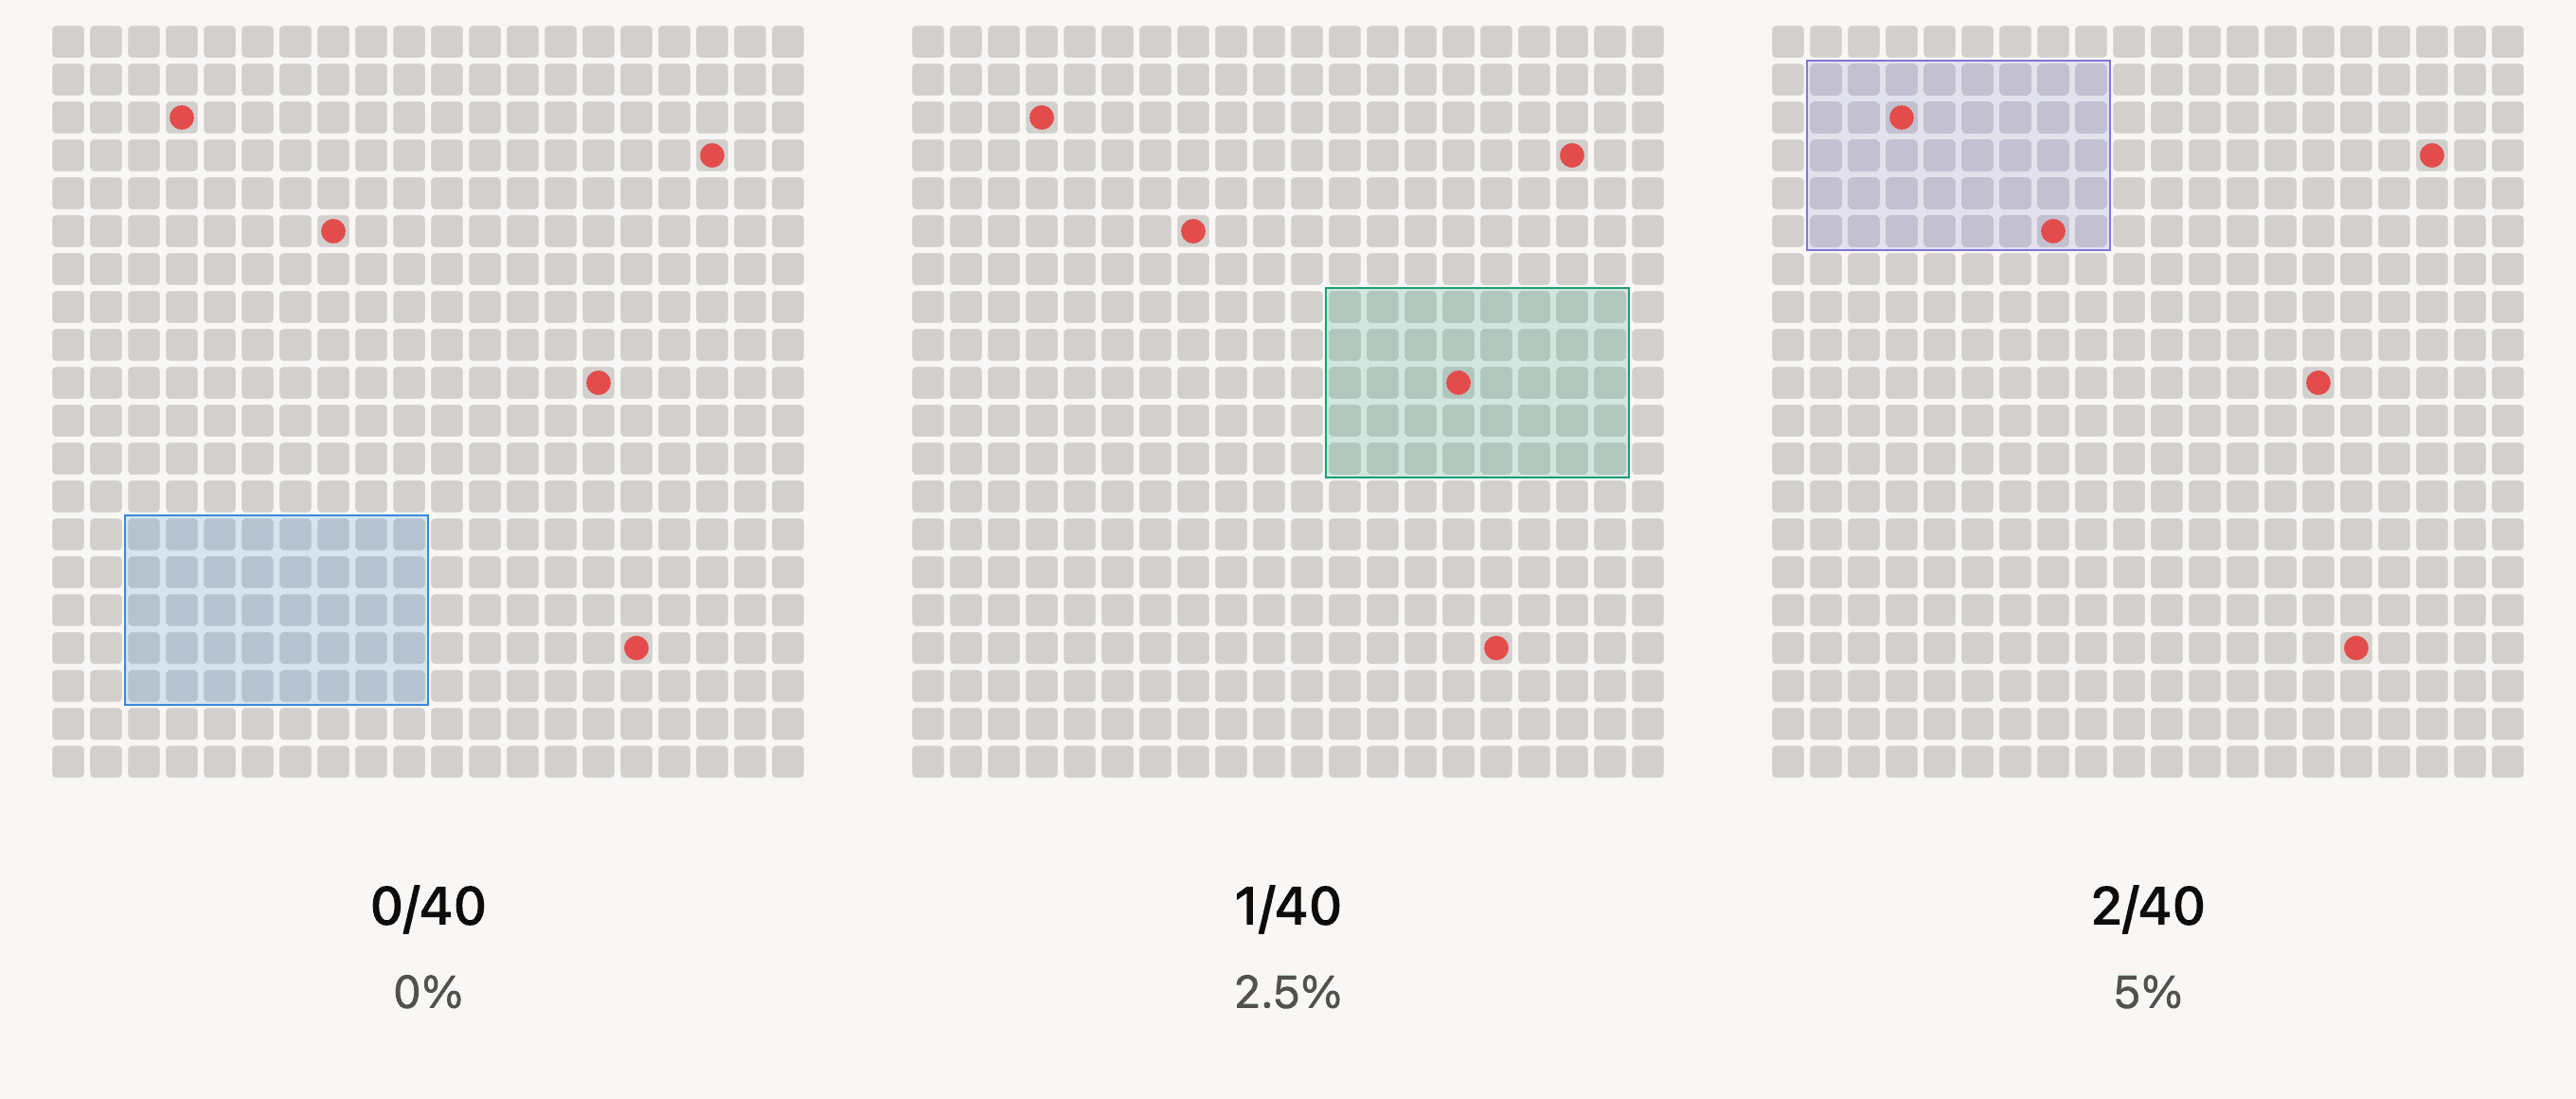
Chacun de ces échantillons présente un taux de faux négatifs différent, et aucun ne correspond au taux de faux négatifs « réel » du détecteur (1,25 %) auquel nous avions accès dans l'univers A. En théorie, un échantillon aléatoire de 40 carrés de cette grille devrait détecter la moitié d'un point rouge. Cependant, selon l'échantillonnage, il pourrait ne détecter aucun point rouge (comme dans l'échantillon bleu), un seul point rouge, ou deux points rouges (comme dans l'échantillon violet). Un échantillon particulièrement malchanceux pourrait détecter tous les points rouges, auquel cas le taux de faux négatifs observé serait de 5/40, soit 12,5 %.
Un tel échantillon malchanceux est cependant très improbable. Un échantillon aléatoire de 10 % de l'ensemble contiendra entre 0 et 2 points dans 99 % des cas – cette plage correspond à la distribution d'échantillonnage. Concrètement, cela signifie que l'échantillon de l'univers B, composé de 40 cas sur 400 possibles, ne permet pas de distinguer un taux de faux négatifs sous-jacent de 0 % d'un taux de faux négatifs sous-jacent de 5 %. Plus l'échantillon est grand, plus cette plage est réduite : si l'on échantillonnait, par exemple, 125 points sur un total de 400, on trouverait entre 0 et 4 points dans 99 % des cas, soit un taux de faux négatifs observé de 0 à 3,2 %.
Le même raisonnement s'applique à nos différents benchmarks Gemini 3.1 Pro, sachant toutefois que l'ensemble de 20 000 invites ne représente pas non plus fidèlement toutes les sorties possibles de l'IA. Malgré cela, la différence entre les deux résultats peut amener à se demander lequel est le plus fiable. En règle générale, la taille de l'échantillon doit être le critère principal : un échantillon plus grand offre une image plus représentative et réduit la marge d'erreur. Par conséquent, il est préférable de se fier au benchmark du rapport technique et de considérer celui-ci comme une simple indication.
Mais il existe d'autres raisons pour lesquelles deux résultats de tests comparatifs peuvent différer. Contrairement à l'exemple de la grille, l'ensemble de tests que j'ai utilisé ne correspond pas exactement aux 20 000 questions de Chatbot Arena utilisées dans le rapport technique : au total, les deux tests Gemini 3.1 Pro partageaient 286 questions identiques. Il est donc possible que 714 des questions utilisées lors des tests comparatifs aient été plus propices à la production de réponses d'IA détectables que celles utilisées dans le rapport technique de Pangram 4.
Il ne semble pas que ce soit le cas ici. Les deux ensembles excluent les productions mathématiques et de programmation, sont rédigés en anglais et couvrent des sujets comparables. Cependant, des différences existent : le nombre médian de mots par réponse Gemini 3.1 Pro était plus élevé dans mon ensemble que dans celui du rapport technique, et, comme nous le savons , un texte plus long est plus facile à évaluer. Mais lequel constitue le test le plus équitable du modèle ? Si l’on contrôlait la longueur des productions et la taille de l’échantillon, quel ensemble de questions représenterait le mieux l’univers A ?
Il est difficile, voire impossible, de créer un ensemble parfaitement représentatif du monde réel ; c’est la contrainte fondamentale des statistiques. Chaque test de performance, s’il est bien conçu, constitue un élément parmi d’autres d’un ensemble d’échantillons qui approchent la réalité sous-jacente de l’univers A, ou du monde extérieur. D’une certaine manière, on pourrait interpréter ce fait comme signifiant que tous les résultats de tests de performance sont, par définition, erronés, ce qui n’est pas faux, mais cela ne signifie pas pour autant qu’ils sont inutiles. En combinant de nombreux résultats différents sur des ensembles de données variés, nous pouvons obtenir une bonne approximation de la réalité sous-jacente. C’est pourquoi nous effectuons différents types de tests de performance, notamment ceux spécifiques au modèle, à la langue , au contenu et à l’humaniseur .
Afin d'obtenir une meilleure approximation, j'envisage d'apporter quelques améliorations à mon processus de génération des ensembles de référence. À l'avenir, je randomiserai la sélection des invites pour Chatbot Arena à partir d'un ensemble plus vaste, au lieu d'utiliser les mêmes invites pour chaque nouvelle version. Je vais également assouplir légèrement mes filtres pour permettre des invites plus variées, comme des questions techniques, et j'ajouterai des invites supplémentaires afin de diversifier les types de réponses obtenues.
Ces articles de blog ont peu d'enjeux comparés au rapport technique, mais cela ne signifie pas que nous ne devrions pas viser la rigueur, même dans l'univers B.
Conclusion
Pangram est robuste face à Gemini 3.8 Flash lors de la saisie de commandes en langage naturel, et le détecte avec une précision observée de 99,80 %. Il détecte Gemini 3.1 Pro avec une précision observée de 99,70 %, soit un taux de détection combiné de 1 995 sur 2 000 (99,75 %) pour les deux modèles. Pangram est capable de généraliser aux nouveaux modèles car les nouvelles versions ont tendance à hériter largement du style et de la voix de leurs prédécesseurs ; il n’est donc pas nécessaire de réentraîner Pangram pour chaque nouvelle version.
Voici comment les Gemini 3.8 Flash et Gemini 3.1 Pro se comparent à nos tests de référence d'autres modèles Frontier récents :
| Modèle | Détectée comme IA | Précision |
|---|---|---|
| Gemini 3.8 Flash | 998/1 000 | 99.80% |
| Gemini 3.1 Pro | 997/1 000 | 99.70% |
| Claude Opus 5.5 | 997/1 000 | 99.70% |
| Fable 5.1 | 1 093/1 097 | 99.64% |
| Claude, opus 5 | 1 105/1 107 | 99.82% |
| GPT-5.6 | 3 408/3 423 | 99.56% |
| Claude Sonnet 5 | 1 145/1 147 | 99.83% |
| Gémeaux 3 | 28/28 | 100% |
Si vous souhaitez vérifier un document en particulier, vous pouvez essayer Pangram ici.
Annamieka est rédactrice technique chez Pangram.
Lectures complémentaires
Comment se positionne Pangram par rapport à GPTZero ?

Performances de Pangram sur un essaim d'agents agissant de concert
Analyse approfondie des avis sur Yelp
Pangram peut-il détecter Claude Opus 5.5 ?
Trois pour cent des avis en première page sur Amazon sont désormais générés par l'IA
Pangram n'a détecté aucun faux positif dans divers essais rédigés par des élèves