AI透かしとは何ですか?
AI透かしは、LLMの文章生成方法を操作するAI検出戦略の一つです。その仕組み、利用している主体、失敗する理由、そしてパングラムとの関連性について解説します。

ウォーターマーキングとは、LLMが特定の単語を使用する頻度を操作することに着目して、AI生成コンテンツを検出する手法です。これにより、単語使用頻度の変化を検知し、そのテキストが特定のAIモデルによって生成されたものかどうかを判断することが可能になります。
透かしはどのように機能するのでしょうか?
LLMは、一連の単語を入力すると、その文の中でその単語の後に続く可能性のある単語のリストを出力するという仕組みで動作します。AIの文章生成はこのように行われます。つまり、AIは文を読み取り、その文の次に続く可能性のある単語のリストを生成するのです。これらの単語のそれぞれには、LLMがそれを次に配置したいと思う確率が付与されます。 その後、LLMはそのリストから実際に次に続く単語を選択しますが、必ずしも(あるいは通常は)絶対的に「最も」確率の高い単語を選ぶわけではありません。もし、例えば「I walk my…」という文に対して、LLMが常に最も確率の高い次の単語「dog」を選んでいたとしたら、同じ質問をされるたびにLLMは毎回同じ答えを返すことになってしまうでしょう。
つまり、未完成の文と、そこから選べる候補となる次の単語のリストがあるわけです。LLMが次の単語を選ぶプロセスにおいて、この「ウォーターマーク」が作用するのです。つまり、LLMは次の単語の選択肢の確率を微調整しているのです。
これを別の言い方で説明すると、次のようになります。LLMが使用し得る単語の集合、つまりAIモデルが将来的に発する可能性があるあらゆる単語を考えます。これをLLMの「語彙」と呼びます。ウォーターマーキングは、この語彙から擬似ランダムにサブセットを選択し、そのスコアにごくわずかな修正を加えて、特定の単語が選ばれる確率を高める仕組みです。
 LLMの語彙から擬似ランダムに選択された部分集合に透かしが入れられる
つまり、LLMが候補となる単語の順位付けリストを作成する際、修飾語によってそれらの単語が本来よりもわずかに上位に表示されるようになり、その結果、選ばれる可能性が高くなるのです。
 透かしが入った単語は、LLMの「次の単語」のランク付けリストでわずかに上位に表示される
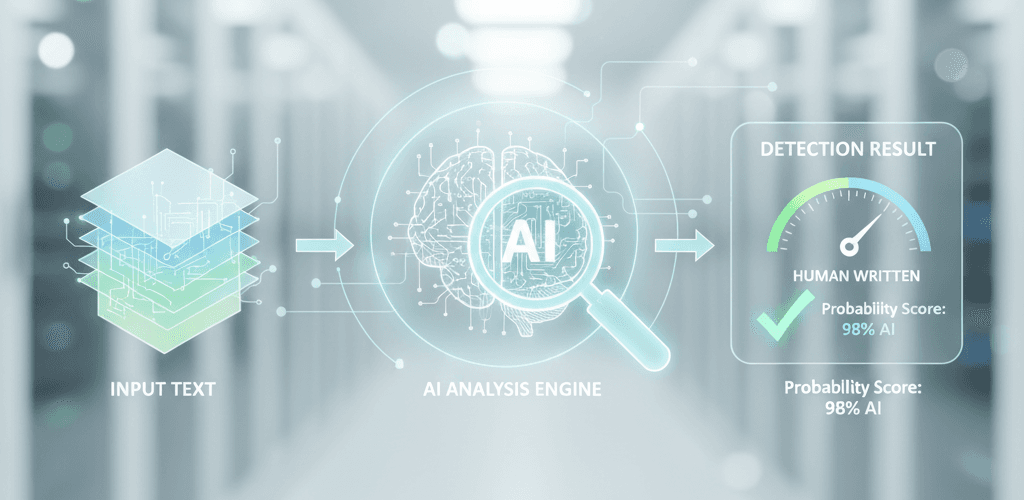
透かしは、出力されたテキストを分析し、透かしが施された単語の出現頻度を判定することで検出されます。それらの単語が、基準となる英語テキストよりも頻繁にテキスト内に現れる場合、それは陽性判定とみなされ、透かし検出器は、そのテキストがAIによって生成されたものであると判定します。
AIによる透かしはどのようなものですか?
AIによる透かしは目に見えず、研究によると、AIによる透かし処理は出力の品質を低下させないことが示されています。これは直感に反するように思えるかもしれません。もし透かしが、LLMの出力に特定の単語が現れる確率を変えるのであれば、LLMが「delve」のような単語を使う際に私たちが気づくのと同じように、人間にもその変化が気づかれるはずではないでしょうか?
これは、透かしが入れられる単語のリストがトークンごとに生成されるためです。つまり、透かしが入れられる単語として選択される語彙のサブセットは、文中の新しい単語が出るたびに変化します。これは、透かしが入れられる単語のセットが、あらかじめ決められた固定の単語セットである場合と比較して、語彙にははるかに大きなばらつきが生じることを意味します。
AIによる透かし入れにはどのような利点がありますか?
透かしは、いくつかの理由からAI検出において有利です。まず第一に、透かしを付けることで、比較的少ない単語数でも高い確信度を得ることができますが、パングラムの場合と同様、セグメントが短くなるにつれて確信度は低下します。 また、ウォーターマークは各モデルに固有のものです。パングラムはテキストがAIによって生成されたかどうかしか判別できませんが、ウォーターマークであれば、そのテキストを出力したAIモデルを正確に特定することができます。ただし、ウォーターマークによる陽性判定もモデルに固有のものです。例えば、ChatGPTで生成されたテキストをClaudeのウォーターマーク検出器にかけると、陰性の結果が返されます。これは、そのウォーターマークがClaudeで書かれたテキストにのみ現れるためです。
AI企業側にとっても、透かし処理の実装は容易です。透かしは比較的低コストで実装でき、使用するモデルの再学習も必要としないからです。
AIによる透かしは破ることができるのか?
透かしは脆弱であり、ヒューマナイザーなど、Pangramが耐性を持つアルゴリズム的手法によって容易に回避されてしまいます。透かしは単語の選択に埋め込まれているため、単語を同義語に置き換えるだけで、AIによる透かし検出器を簡単に無効化できてしまいます。 また、ウォーターマーキングは二値的な性質を持っています。パングラムの検出器は、AIが作成したコンテンツと人間とAIが混在したコンテンツを区別できますが、ウォーターマーキングでは、そのテキストがユーザーの手元に届く前の最終段階でLLMを通過したかどうかしか判別できません。
透かし検査によって、あるモデルがテキストを作成したかどうかを判断することはできますが、透かし検出ツールで陰性結果が出たからといって、そのテキストがAIによって生成されていないこと、あるいはその特定のモデルによって生成されていないことまではわかりません。それは、単にそのモデル特有の透かしが含まれていないということに過ぎないのです。 そのテキストは、別のモデルによって生成されたものである可能性も十分にあるし、ヒューマナイザーや類似のプログラムを通され、テキスト内の単語が同義語に置き換えられた可能性もあります。
ClaudeにはAIによる透かし機能が実装されていますか?
はい、現在、Claudeモデルでは、EUの規制に準拠するため、AIによる透かし処理が施されています。Anthropicは、ブログでの発表通り、2026年8月2日よりClaudeの出力結果に透かしを入れるようになりました。
| プロバイダー | テキスト透かし | EU行動規範への署名 | 誰がそれを確認できるのか |
|---|---|---|---|
| Gemini(Google) | はい、2024年からGeminiにSynthID-Textが導入されています | はい | GoogleのSynthID検出ツール(アクセス制限あり) |
| クロード(アンソロピック) | はい、2026年8月2日以降です | はい | Anthropic 検出 API(プライベートプレビュー) |
| ChatGPT(OpenAI) | いいえ | はい | テキストチェッカーなし |
| Meta AI(Meta) | いいえ | はい | テキストチェッカーなし |
| Copilot(マイクロソフト) | いいえ | はい | テキストチェッカーなし |
| ミストラル | いいえ | はい | — |
| Grok (xAI) | いいえ | いいえ | — |
| オープンウェイトモデル(Llama、DeepSeekなど) | いいえ | — | — |
現時点では、ChatGPTにはAI透かし機能が実装されておらず、ChatGPTが生成したテキストを検出・確認できる信頼性の高いAI透かし検出ツールやチェッカーも存在しません。
透かしはパングラムに影響を与えますか?
AIによる透かし処理は、PangramのAI検出にはあまり影響を与えません。透かし処理は、LLMが使用する単語の確率スコアをわずかに調整するだけのものであるため、透かしが施されたLLMの出力は、Pangramによって引き続き検出可能となります。
結局のところ、透かし処理は、AIの使用を隠蔽する努力が一切なされていない、最も露骨で改変されていないAI出力にのみ印を付けるに過ぎません。私たちは、それよりもはるかにきめ細かな区別を行い、AIによる支援、AIと人間が共同で作成したテキスト、そして完全にAIによって生成されたテキストを区別することを目指しています。また、透かし検出ツールとは異なり、テキスト生成に使用されたモデルについては中立的な立場をとっています。
私たちは、AIによる透かし入れをPangramを補完するものと捉えています。また、AIによる執筆の透明性が高まることは、世界全体にとって概して良いことだと考えています。
よくある質問
ChatGPTには透かしが入っていますか?
いいえ、ChatGPTはテキストに透かしを入れません。OpenAIは2024年にテキストに透かしを入れるシステムを開発しましたが、それを公開することはありませんでした。
SynthIDとは何ですか?
SynthIDは、2024年からGeminiモデルで使用されているGoogleの透かしです。
あるテキストにAIの透かしが入っているかどうかを確認するにはどうすればよいですか?
AI透かし検出ツールは、そのモデルを開発した企業によって公開されるため、テキストに透かしが含まれているかどうかを確認するには、その企業が透かしの生成に使用した秘密鍵へのアクセス権を提供する必要があります。2026年9月14日現在、Geminiが画像用検出ツールを公開しているものの、テキスト用のAI透かし検出ツールを一般に公開しているAI企業は存在しません。
パングラムはAIによる透かしを検出しますか?
Pangramでは現在、AIによる透かし検出はサポートされていません。