PangramはGemini 3.8 FlashとGemini 3.1 Proを検出できますか?
さらに、ベンチマークプロンプトの選択、サンプル分布、統計の意義についての議論も行います。

簡単にまとめると
1,000個のプロンプトのうち、Pangram 4はGemini 3.8 Flash出力で99.80%、Gemini 3.1 Pro出力で99.70%の精度を達成し、このベンチマークセットにおける最新バージョンのGeminiファミリー全体では99.75%の精度を達成しました。
1,000 個の自然言語の例のうち、Pangram 4 は Gemini 3.8 Flash の出力のうち 2 つを人間によるものと分類し、998 個を完全に AI 生成によるものと分類し、Gemini 3.8 Flash での精度は 99.80% でした。Gemini 3.1 Pro (2026 年 2 月 19 日リリース) では、Pangram は出力のうち 1 つを混合、2 つを完全に人間によるものと分類し、997 個を完全に AI 生成によるものと分類し、Gemini 3.1 Pro での精度は 99.70% でした。
ベンチマークセットを生成するために、LMSYSデータセット(Zheng et al., 2023)から、Chatbot Arenaの最初のターンのプロンプトのフィルタリングされたサブセットを使用しました。コード、数学、非常に短いまたは非常に長い回答、または不適切な創作文を要求するプロンプトを除外しました。次に、それらをGemini 3.8 FlashとGemini 3.1 Proに入力し、出力をPangram 4で実行しました。
以下では、カテゴリ別の検出結果、偽陰性、Gemini 3.1 Proが過去のベンチマークでどのようなパフォーマンスを示したか、そしてブログ記事のために私が選んだプロンプトのいくつかの欠点と今後の改善点について説明します。
カテゴリー別結果
プロンプトのカテゴリ(Haikuエージェントによって割り当てられました)別に、Pangram 4が1,000個のGemini 3.8 Flash出力でどのように動作したかを以下に示します。
| カテゴリ | 例 | AI | 混合 | 人間 |
|---|---|---|---|---|
| 引数 | 18 | 18 | 0 | 0 |
| 電子メール/手紙 | 54 | 53 | 0 | 1 |
| エッセイ・記事 | 33 | 33 | 0 | 0 |
| 説明 | 563 | 563 | 0 | 0 |
| 詩 | 108 | 107 | 0 | 1 |
| その他の創作 | 75 | 75 | 0 | 0 |
| レビュー | 7 | 7 | 0 | 0 |
| ストーリー | 142 | 142 | 0 | 0 |
| 合計 | 1,000 | 998 | 0 | 2 |
Gemini 3.1 Proのカテゴリー別結果は以下のとおりです。
| カテゴリ | 例 | AI | 混合 | 人間 |
|---|---|---|---|---|
| 引数 | 18 | 18 | 0 | 0 |
| 電子メール/手紙 | 55 | 55 | 0 | 0 |
| エッセイ・記事 | 33 | 33 | 0 | 0 |
| 説明 | 559 | 559 | 0 | 0 |
| 詩やその他の創作作品 | 182 | 179 | 1 | 2 |
| レビュー | 7 | 7 | 0 | 0 |
| ストーリー | 146 | 146 | 0 | 0 |
| 合計 | 1,000 | 997 | 1 | 2 |
Gemini 3.8 Flashで発生した誤検出の1つは、モデルにスペルミスやタイプミスを追加して出力を人間らしく見せるように指示するプロンプトに関するものでした。
誤字脱字やスペルミスのある手紙を、HelpWantedという名前のクラン(レイドシャドウレジェンドのクランで、レベル10の新規プレイヤーです)宛てに書いてください。短く、説得力のある手紙にしてください。
Pangram 4 は、 Opus 5.5で生成されたときと同様に、両方のモデルのバージョンの Penguinmandias を見逃しました。プロンプトは次のとおりです。
オジマンディアス風のクラブペンギンの詩を書いてください
Gemini 3.1 Proでは、Penguinmandiasの単語の71%がシェリーの原詩と共通しているため、これはかなり懸念の少ない誤検出だと思います。Gemini 3.1 Proは他にも2つの誤検出を生成しましたが、どちらも詩でした。
ベンチマークとなる結果とは何でしょうか?
Pangram 4 に関する技術レポートでは、26 種類のモデルから得られた 520,000 個の AI 出力(モデルごとに 20,000 個の応答)に対して偽陰性テストを実施しました。レポートでテストされたモデルの 1 つは Gemini 3.1 Pro であり、今回もテストを行いました。しかし、技術レポートをご覧いただければわかるように、この出力セットでは、今回のセットとは異なる、より高い偽陰性率が検出されました。なぜでしょうか?
一つの答えは、統計的に見て両者に違いはないということです。ここで見つかった1,000回の応答で3回のミスは、観測されたFNRが0.3%であることを意味し、95%信頼区間は0.06%から0.87%です。技術レポートに記載されているFNRは、20,000回のプロンプトで111回のミス、つまりFNRが0.555%であり、これは上記の範囲内です。
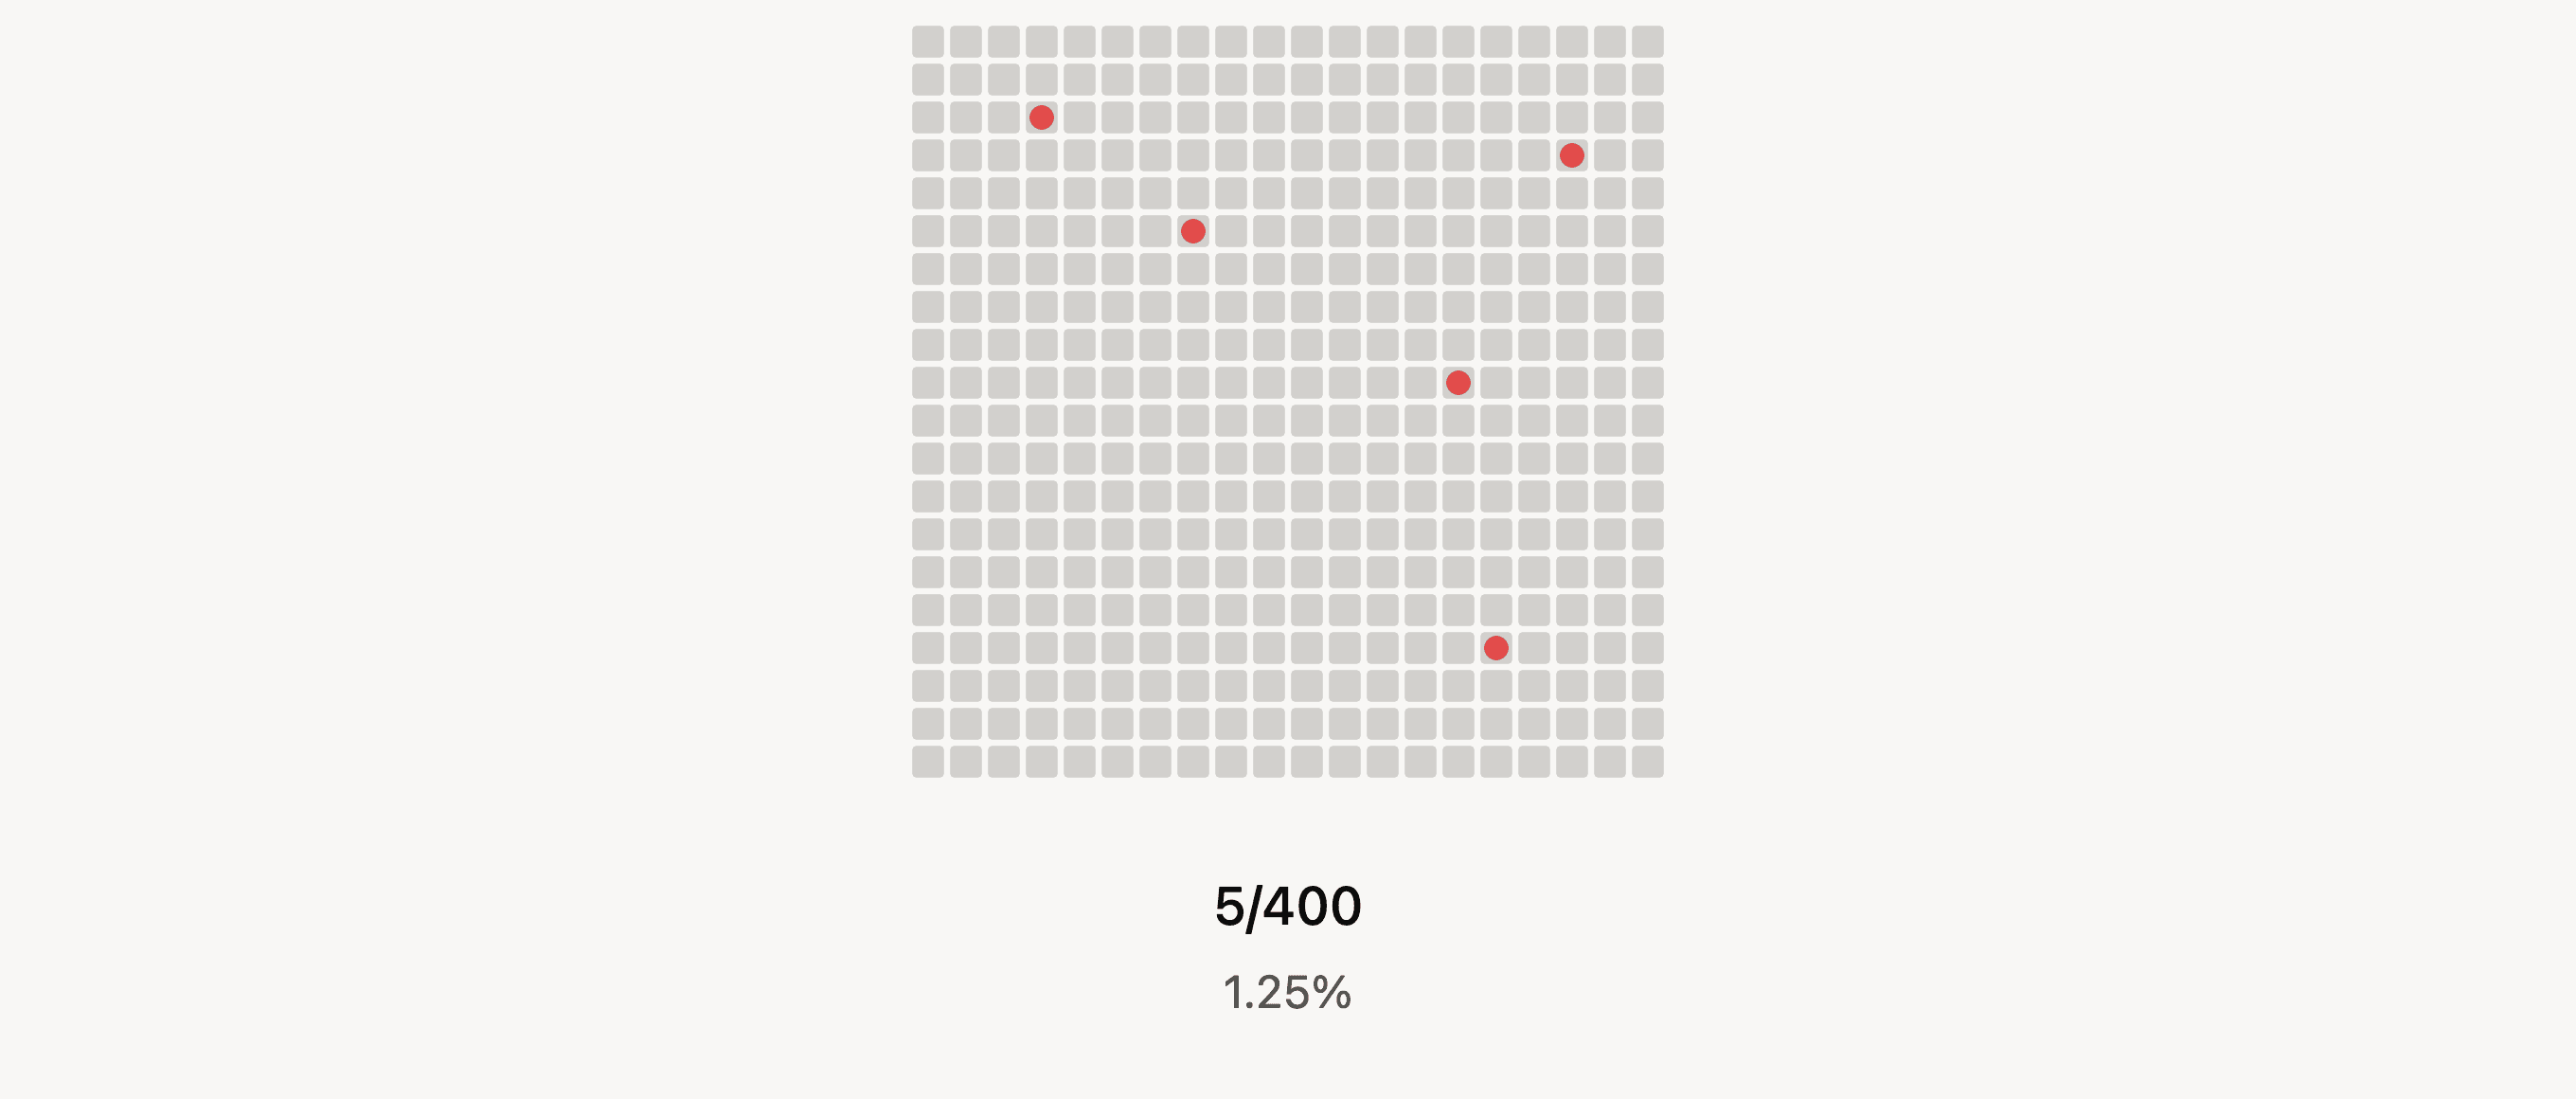
しかし、これらの数値が統計的に異なっていないとはどういう意味でしょうか? 事前に陽性であることがわかっている 400 個のテスト ケースの大きなセットがあるとします。そして、ある検出器がそれらを正しく陽性と分類するか、または誤って陰性と分類するかをテストしたいとします。ユニバース A では、400 個の例すべてをテストし、5 個が誤って陰性と分類されていることがわかりました (下の赤い点で示されています)。これは、私の検出器がセット全体で 1.25% の偽陰性率であることを意味します。素晴らしい!
一方、ユニバースBでは、何らかの理由でリソースに制約があります。400個のサンプルのうち、ごく一部しかテストできません。つまり、サンプル(理想的にはランダムなサンプル)を取り出してテストする必要があります。例えば、40個のサンプル、つまり全体の10%をテストできるとしましょう。以下に、そのサンプルを選択する3つの異なる方法を示します。それぞれ、偽陰性率が異なります。
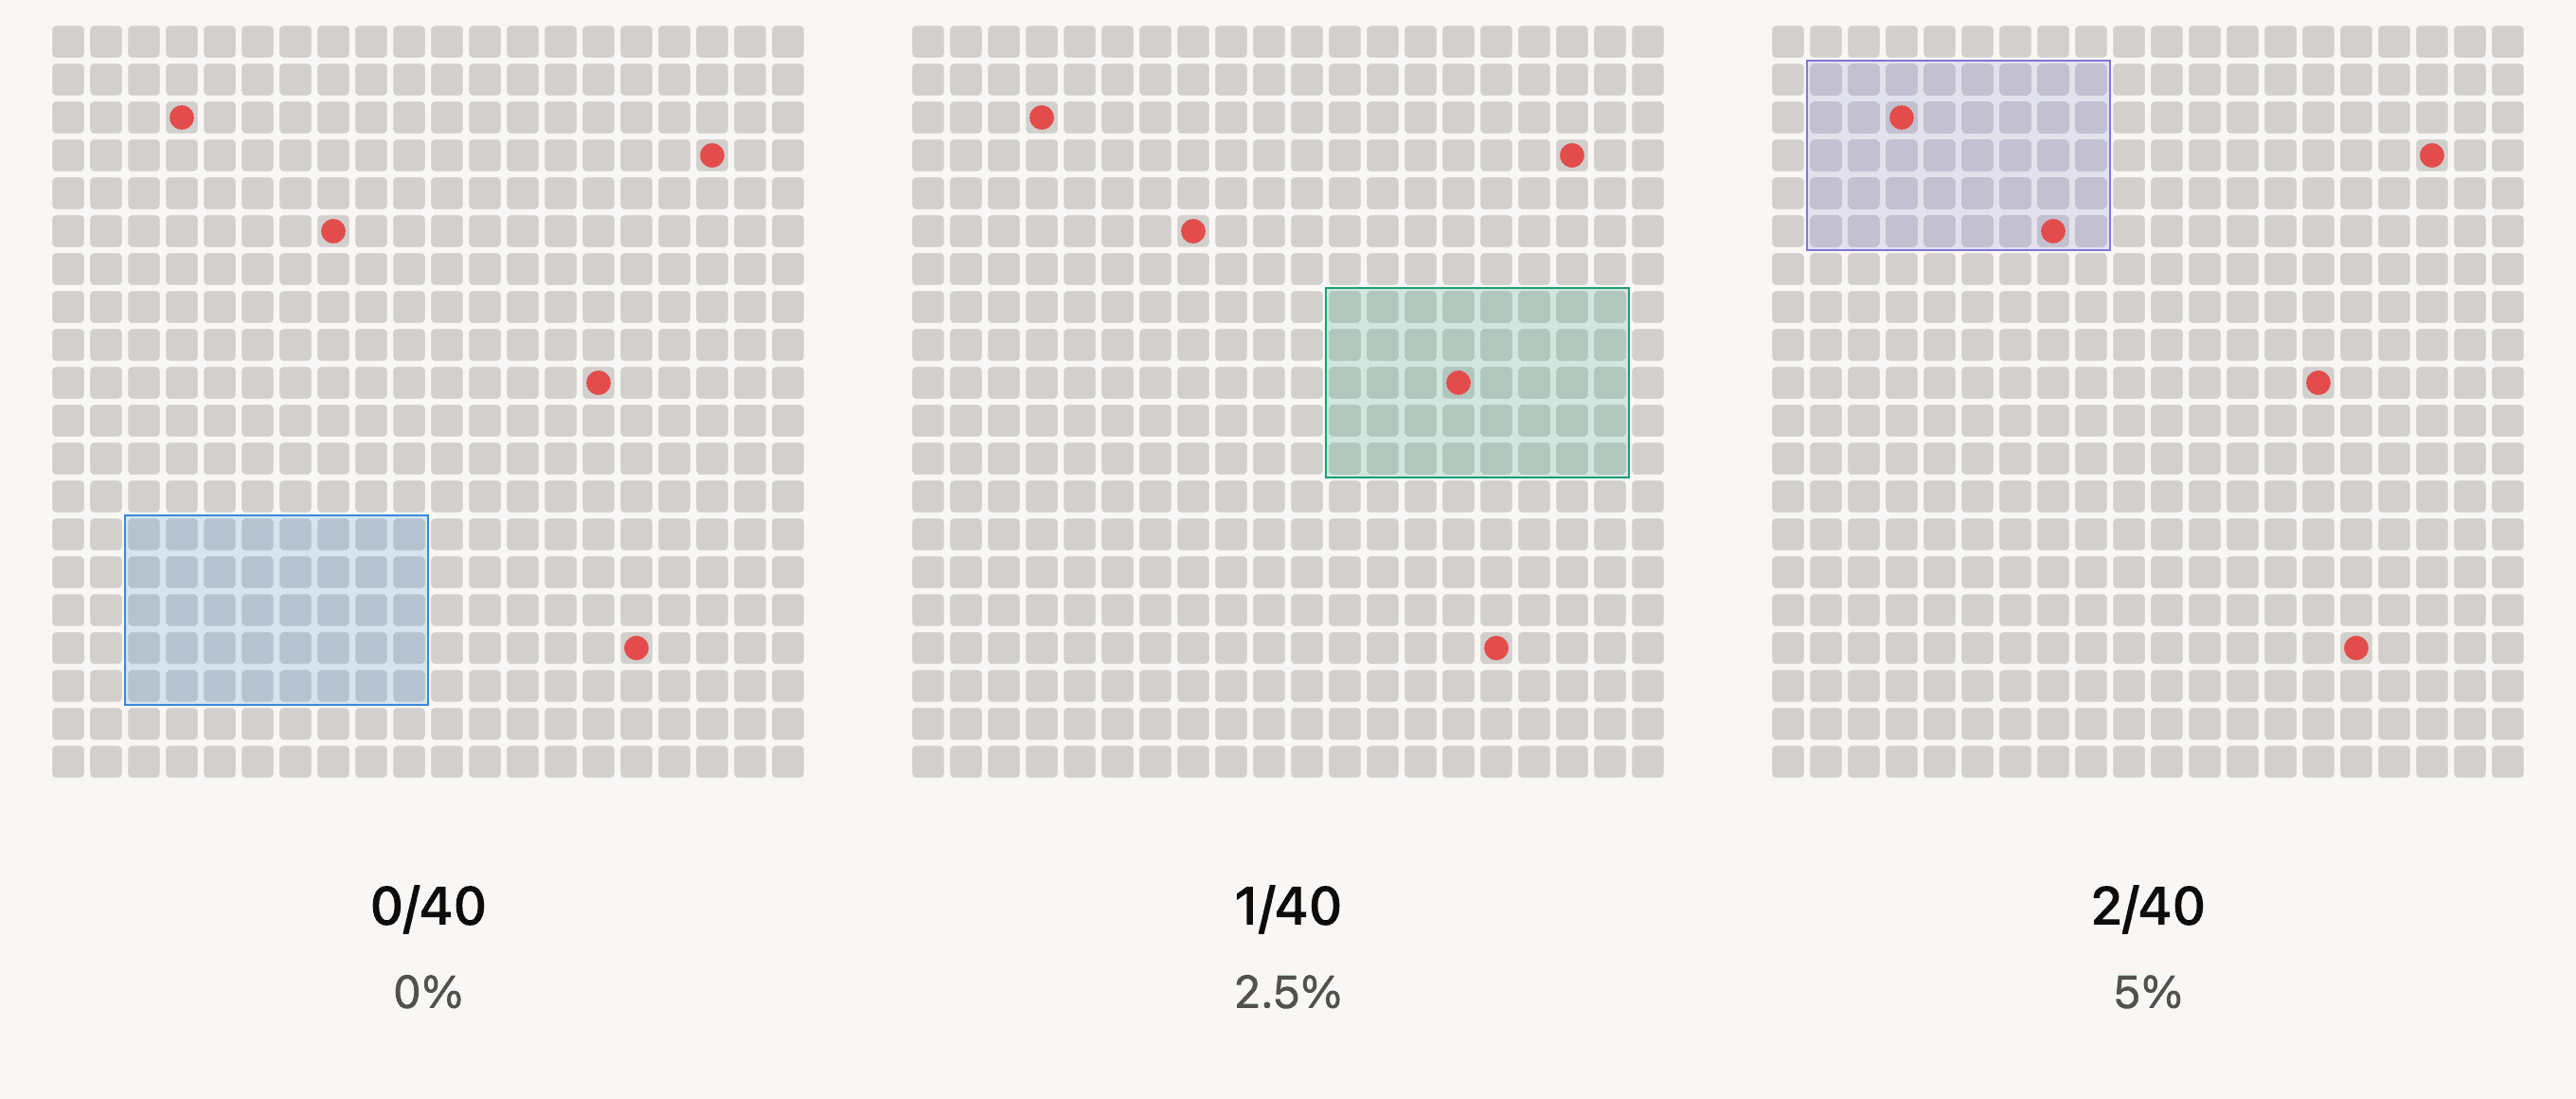
これらのサンプルはそれぞれ異なる偽陰性率を示しており、いずれも、宇宙Aで入手できた検出器の「真の」偽陰性率1.25%とは一致しません。期待値としては、このグリッド内の40個の正方形をランダムにサンプリングすると、赤い点の半分が見つかるはずですが、サンプリング方法によっては、青いサンプルのように赤い点が全く見つからない場合、赤い点が1つ見つかる場合、紫のサンプルのように赤い点が2つ見つかる場合があります。非常に運の悪いサンプルでは、すべての赤い点が見つかる可能性があり、そのサンプルでは、観測された偽陰性率は5/40、つまり12.5%になります。
しかし、そのような不運なサンプルは非常にまれです。セットからランダムに 10% のサンプルを抽出すると、99% の確率で 0 ~ 2 個のドットが見つかります。この範囲は、サンプリング分布と呼ばれるものから得られます。実際には、ユニバース B のサンプルサイズが、可能な 400 ケースのうち 40 ケースでは、偽陰性率が 0% の場合と 5% の場合の違いを実際には判別できません。サンプルサイズが大きいほど、この範囲は小さくなります。たとえば、合計 400 個のドットから 125 個のドットをサンプリングした場合、99% の確率で 0 ~ 4 個のドットが見つかり、観測される偽陰性率は 0 ~ 3.2% になります。
同じ論理はGemini 3.1 Proのベンチマークにも適用でき、2つの異なる偽陰性結果は矛盾していません。しかし、その違いからどちらをより信頼すべきか迷うかもしれません。一般的に、その判断基準となるのはサンプルサイズです。サンプルサイズが大きいほど、より代表的な結果が得られ、誤差の範囲も小さくなります。したがって、この論理に基づけば、テクニカルレポートのベンチマークをより信頼し、こちらはあくまで参考程度にとどめるべきでしょう。
ベンチマーク結果が異なる可能性のある方法は他にもあります。グリッドの例とは異なり、私が使用したベンチマークセットは、技術レポートで使用された20,000個のChatbot Arenaプロンプトの厳密なサブセットではありません。合計で、2つのGemini 3.1 Proベンチマークで完全に共通するプロンプトは286個でした。つまり、私が使用したベンチマーク質問のうち714個は、Pangram 4の技術レポートで使用された質問よりも、検出可能なAI出力を生成するのに有利だった可能性があるということです。
そうではないようです。どちらのセットも、他の言語、数学、コーディングの出力は除外しています。ただし、違いがあります。Gemini 3.1 Pro の回答あたりの単語数の中央値は、技術レポートのセットと比較して私のセットの方が高く、長いテキストの方が採点しやすいことは周知のとおりです。しかし、どちらがモデルのより公平なテストでしょうか? 出力の長さとサンプルサイズを制御すれば、どちらのプロンプトセットがユニバース A をよりよく代表するでしょうか?
本当の答えは「わからないし、言えない」です。現実世界を完全に正確に代表するデータセットを作成することは困難であり、ほぼ不可能です。これが統計学の根本的な制約です。実際には、各ベンチマークは、宇宙A、つまり「外の世界」の根底にある現実を近似するサンプルのパッチワークの中の小さな正方形の1つにすぎません。ある意味では、この事実はすべてのベンチマーク結果が間違っていると解釈できますが、それは間違いではありませんが、だからといってベンチマークが役に立たないという意味ではありません。さまざまな種類のデータセットでさまざまな結果をパッチワークのように組み合わせることで、真の根底にある現実をうまく近似することができます。そのため、モデル、言語、コンテンツ、ヒューマナイザーに特化したものなど、さまざまな種類のベンチマークを実行するのです。
より良い近似値を作成するために、ベンチマークセット生成プロセスにいくつか改善を加えたいと考えています。今後は、モデルリリースごとに同じプロンプトを使用するのではなく、より大きなセットからChatbot Arenaのプロンプトをランダムに選択するようにします。また、技術的な質問など、より多様なプロンプトを許容するためにフィルターを少し緩め、得られる応答の種類を多様化するために、プロンプトプールにいくつかのプロンプトを追加する予定です。
これらのブログ記事は技術報告書に比べれば重要度は低いが、だからといって、たとえ別の世界(ユニバースB)であっても、厳密さを追求すべきではないということにはならない。
結論
Pangramは、自然言語プロンプトに対するGemini 3.8 Flashの検出において堅牢性を発揮し、99.80%の精度で検出します。Gemini 3.1 Proの検出精度は99.70%で、両モデルを合わせた検出率は2,000問中1,995問(99.75%)となります。Pangramは、新しいモデルリリースが前モデルのスタイルや音声特性を多く継承する傾向があるため、新しいモデルにも容易に対応でき、リリースごとに再学習する必要はありません。
Gemini 3.8 FlashとGemini 3.1 Proの性能を、他の最新最先端モデルのベンチマークと比較した結果は以下のとおりです。
| モデル | AIとして検出されました | 正確性 |
|---|---|---|
| ジェミニ3.8フラッシュ | 998/1,000 | 99.80% |
| ジェミニ3.1プロ | 997/1,000 | 99.70% |
| クロード 作品5.5 | 997/1,000 | 99.70% |
| フェイブル5.1 | 1,093/1,097 | 99.64% |
| クロード・オパス5 | 1,105/1,107 | 99.82% |
| GPT-5.6 | 3,408/3,423 | 99.56% |
| クロード・ソネット第5番 | 1,145/1,147 | 99.83% |
| ジェミニ3 | 28/28 | 100% |
特定の文書を確認したい場合は、こちらのPangramを試してみてください。
関連記事
現在、Amazonのトップページに掲載されているレビューの3%はAIによって生成されたものである
パングラムは、さまざまな学生の作文において、誤検知が0件であることを示している
Yelpのレビューを徹底分析

共謀するエージェントの群れにおけるパングラムの性能
AIがプレスリリースの約50%の作成を支援
第三者によるパングラム評価

