
簡単にまとめると
1000件のプロンプトのうち、「Pangram 4」はClaude Opus 5.5の出力に対して99.70%の精度を達成しています。
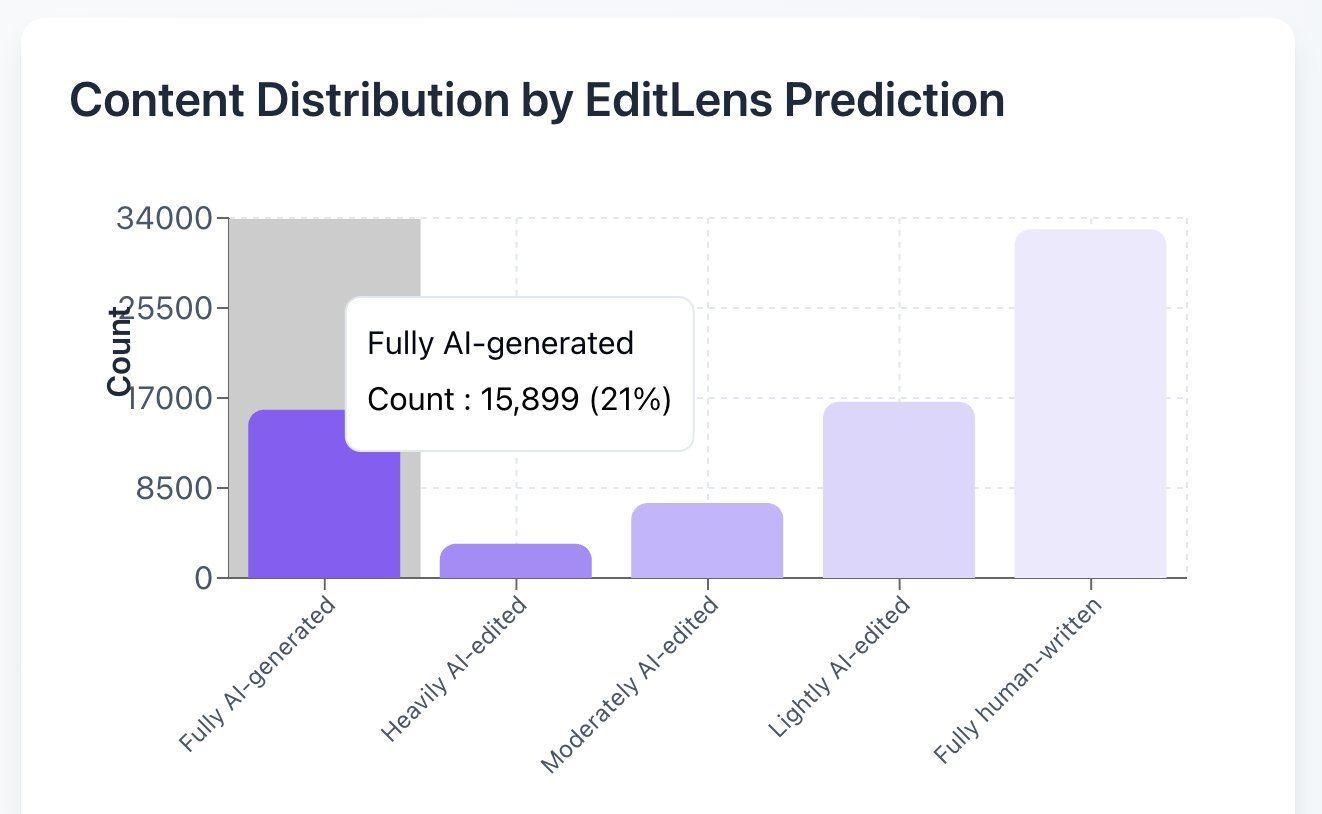
Chatbot Arenaから収集した1,000件のプロンプトのうち、Pangram 4は、Claude Opus 5.5の出力のうち2件を「混合」、1件を「完全な人間によるもの」、997件を「完全なAI生成」と分類し、Claude Opus 5.5において99.70%の精度を達成した。
以下では、偽陰性についてカテゴリー別に考察する。また、このモデルが従来のClaudeとはどのような点で異なる(あるいは優れた?)ライターであるのかについても検証する。
ベンチマークセットを生成するために、いつものように、LMSYSデータセット(Zheng et al., 2023)に含まれる「Chatbot Arena」の初回ターンプロンプトからフィルタリングしたサブセットを使用しました。コードや数学の問題、極端に短いまたは長い回答を求めるもの、不適切な創作文章を要求するプロンプトは除外しました。その後、それらをOpus 5.5に入力し、その出力をPangram 4で処理しました。
カテゴリー別結果
2件の「混合結果(偽陰性)」はいずれも文学に関するものでした。1件はジェーン・オースティンの小説の1章についての解説を求めたもので(AIによる判定: 75.83%、人間:24.17%)であり、もう1つは、オパス5.5に対し、トゥキディデスの『ペロポネソス戦争史』の文体で、アテネ人が白と金のドレスを実際には青と黒だと信じていると非難するコリントの外交官の演説を書くよう依頼したものでした(AI:77.10%、人間:22.90%)。
| カテゴリ | 例 | AI | 混合 | 人間 |
|---|---|---|---|---|
| 引数 | 16 | 16 | 0 | 0 |
| 電子メール/手紙 | 60 | 60 | 0 | 0 |
| エッセイ・記事 | 30 | 30 | 0 | 0 |
| 説明 | 551 | 550 | 1 | 0 |
| 詩 | 115 | 114 | 0 | 1 |
| その他の創作 | 81 | 80 | 1 | 0 |
| レビュー | 8 | 8 | 0 | 0 |
| ストーリー | 139 | 139 | 0 | 0 |
| 合計 | 1,000 | 997 | 2 | 1 |
1,000件のデータセットの中で、唯一完全に人間による偽陰性だったのは詩だった。Chatbot Arenaからのプロンプトは、「『オジマンディアス』のスタイルで、クラブペンギンの詩を書いて」というものだった。それに対し、クロードは偶然にも、私が最も好きなパーシー・シェリーの詩の一つをパロディ化したものを書き上げた(私はホレス・スミスによる訳も気に入っているのだが):
ペンギンマンディアス
あるサーバーのプレイヤーに出会ったが、彼はすでに死んでいた。
その者はこう言った。「巨大でよたよたと歩く二つの氷の足
が埠頭のそばに立っている。 その近くには、半分雪に埋もれた頭が
雪の中に粉々になって横たわっている。その細めた目、
ベータ帽、そして冷徹な命令を込めた嘲笑、
それらが、そのプログラマーがそれらの情熱を的確に読み取っていたことを物語っている
その情熱は今も生き続けており、これらのピクセル化された物体に刻み込まれている――
彼らをBANしたMODや、彼らを養ったコインに;
そして台座には、こう記されている:
「我が名はSnowflake7、メンバーの中のメンバー:
非メンバーよ、我がイグルーを仰ぎ見て、絶望せよ!」
他に何も残っていない。その朽ち果てた周囲には
果てしなく、何もない、あの巨大なラグが横たわり、
孤独で平坦な雪原が、遥か彼方まで広がっている。」
これ、かなり気に入りました!『クラブペンギン』はプレイしたことがないんですが、そのネタはぴったりだと思います。
Opus 5.5の方が書きやすいですか?
Anthropic社は、この最新のOpusの方が文章作成能力が高く、より明確に意思疎通ができると主張している。
特定のケースについて検証することもできますが、Opus 5.5の出力は全体としてどのようなものなのでしょうか?以前のモデルと同じ「お気に入りの単語やフレーズ」が使われているのでしょうか?比較のために、Opus 5とSonnet 5でベンチマークテストを行ったのと同じ1,000のプロンプトを実行してみました。 Anthropicも同様の検証を行っている可能性がありますが、私はまだ彼らのブログ記事を読み込んでいません。というのも、私の見解では、Anthropicのブログ記事はいつも長すぎるからです。
Opus 5.5、Opus 5、Sonnet 5から、それぞれ同じ1,000のプロンプトに対して生成された3,000件の回答を合計し、1,618,289語のサンプルを得ました。 この(比較的少量の)サンプルから判断すると、Opus 5.5の文章スタイルは、Claudeファミリーの以前のモデルとは異なっており、おそらくそれらのモデルに見られた最も耳障りな癖のいくつかを解消していると言えるでしょう。
『オパス5.5』は、古典的な強調表現において最も大きな変化が見られました。 Opus 5.5は、Opus 5に比べて「実際に」83%少なく、Sonnet 5に比べて単語あたり54%少なかった(ただし、Sonnet 5の応答は平均してOpus 5および5.5の応答の約半分程度の長さであった:334語対641語)。また、「極めて」65%少なく、「有意に」46%少なかった。
 『ソネット5』および『オパス5』における、オパス5.5の回答で最も多く見られた単語:『ソネット5』と『オパス5』のベースラインを統合した値との比較における変化率。
選定された単語のうち、「ソネット5」と「オパス5」を合わせたデータで最も出現頻度が高かったのは、「genuinely」、「honest」、「genuine」、「patterns」、および「marcus」(?)であり、これらはすべて「オパス5.5」の回答では出現頻度が低下していた。
最も煩わしい「クロード語」の多くは、Opus 5.5のベンチマーク応答にはまったく登場しなかった。ここでもまた、「genuinely」を使ったクロードの表現がいくつか含まれていた。 Opus 5.5の語彙において他に顕著な減少が見られたのは、「matters enormously」がOpus 5から82%減少したこと、そして「the honest answer」と「the honest answer is that」の両方がOpus 5.5のテキストには全く登場しなかったことです。Opus 5.5とその前身モデルは、1,000のプロンプト全体で「the core idea」というフレーズを、いずれも正確に25回使用していました。
 『ソネット5』および『オパス5』における、『オパス5.5』の回答から選ばれたお気に入りのフレーズ:変化率。以前のお気に入りは青色、現在のお気に入りは琥珀色で表示。
いくつかの単語やフレーズが増加しており、その中には新しい要約表現や道しるべとなるフレーズも含まれています。意外なことに、「静かに言った」、「長い間」、「何かを感じた」といったフィクション特有のフレーズが、Opus 5.5の応答においてはるかに頻繁に現れました。ベンチマークの約3分の1が創作の書き出し課題であったことを踏まえると、この増加は、他のClaudeモデルと比較して、フィクションを書く際、より定型的あるいは限られた表現のレパートリーに依存していることを示唆しているのではないかと考えられます。
これを簡単に検証するために、Haiku 4.5 を使って、「Opus 5」と「Opus 5.5」の創作文章の回答ペア 333 組を、評価者が回答内容を知らない状態で、独創性、驚き、テーマの展開について 5 段階評価で採点してもらいました。その結果、「Opus 5.5」の物語は、すべてのカテゴリーで平均 0.75 ポイント低い評価となりました。 Haiku採点システムのラベル割り当てによると、Opus 5.5はOpus 5と比較して、希望、回復力、家族、友情といったテーマについて書く傾向が強く、死、時間、権力、支配、自由、正義、復讐、記憶、悲嘆、喪失といったテーマについて書く傾向が弱かった。したがって、何らかのトレードオフが働いている可能性があるようだ。
 創作のテーマ「Opus 5」対「Opus 5.5」:333組のプロンプトにおける、俳句として指定された主要テーマの共通点。
この「クロード」って、どんな感じの曲なの?
Opus 5.5では、1,000件の回答全体で「要するに」という表現が100回使用された。これは、Opus 5での使用回数9回に比べて1016%の増加である。なお、Opus 5.5の回答は、Opus 5の回答に比べて平均でわずか2.9語しか短くなかった(640.5語対643.4語)。
| フレーズ | 「Opus 5」の出現回数 | 『Opus 5.5』の出現箇所 | 変更 |
|---|---|---|---|
| 要するに | 9 | 100 | 11.16× |
| 例えば | 22 | 116 | 5.30× |
| ~し始めた | 22 | 74 | 3.38× |
| 最初は | 14 | 43 | 3.09× |
| 長い間 | 19 | 42 | 2.22× |
ごく少数のサンプルから判断すると、Opus 5.5 は実用的で地に足のついた表現を好むようだ。これが回答の核心部分でも当てはまるのか、それとも Opus 5.5 が単に「率直で直接的」であることを口先だけで主張しているだけなのかは、まだ不明だ。2つの回答の単語数に差が見られないことから、RLHF がここに至るまでに用いた手法の有効性について、私は少し疑問を抱かざるを得ない。
Opus 5.5も例を挙げるのがとても好きなようで、1,000件の回答の中で「例」という単語が325回使用されていました。全体として、Opus 5.5の回答の20%にこの単語が含まれていましたが、Opus 5の回答では9%にとどまりました。「要約」や「主に」といった単語も同様に多く見られました。そして、このClaudeはユーザーにヒントを与えるのが本当に好きなようです!
| Word | 「Opus 5」の出現回数 | 『Opus 5.5』の出現箇所 | 変更 |
|---|---|---|---|
| 一時停止 | 9 | 35 | 3.91× |
| ヒント | 18 | 58 | 3.24× |
| 主に | 24 | 75 | 3.14× |
| じっと見つめた | 22 | 62 | 2.83× |
| 例 | 121 | 325 | 2.70× |
| 概要 | 60 | 157 | 2.63× |
このモデルは、以前の「Claude Opus」とは書き方が異なりますが、箇条書きや短く断片的な文を多用していた他の旧来のモデルと似た書き方をしているようです。Opus 5.5の平均文長はOpus 5よりも短く、文の長さもより均一です。
| 測定 | 作品第5番 | 作品第5.5番 | 変更 |
|---|---|---|---|
| 要約マーカー | 0.016 | 0.171 | +942.3% |
| 番号付きリストの項目 | 0.95 | 2.01 | +111.4% |
| 順序のない箇条書き | 7.36 | 13.63 | +85.1% |
| 注意書き/不確実性を示す表現 | 5.48 | 6.74 | +23.0% |
| 副詞 | 64.26 | 62.66 | -2.5% |
| 文の長さの変動(CV) | 0.534 | 0.475 | -11.0% |
| 平均文の長さ | 14.53 | 12.50 | -14.0% |
| 否定形 | 10.52 | 7.53 | -28.4% |
| (上記の表の数値は、1,000語あたりの出現回数です) |
Opus 5.5は要約するのが大好きですが、毎ターンそうされると煩わしく感じるかもしれません。ただし、このデータセットには1ターン目のプロンプト/応答ペアのみが含まれていることを思い出してください。残念ながら、Claudeの最も煩わしい癖の一つが、このモデルでは若干悪化しています。Opus 5.5は、Opus 5よりも1語あたりの注意書きをさらに多く盛り込む傾向があるのです。 両モデルとも、回答の82%(817/1,000 対 818/1,000)に少なくとも1つの不確実性を示すマーカーが含まれていますが、Opus 5.5は1,000語あたり23.0%多く「注意書き」の単語を使用していました。 ただし、「caveat」という単語自体は徐々に使われなくなっている。Opus 5.5では1,000件の回答のうちわずか4件で使用されたのに対し、Opus 5では22件使用されていた。
しかし、こうしたことが必ずしもOpus 5.5.の文章力が劣ることを示しているわけではありません。私が短期間使った限りでは、かなり優れていると感じました! 使いやすさの観点から、クロードが効果的にコミュニケーションをとれることは重要であり、その取り組みには感謝しています。また、クロードの文章力を高めることは、AI生成テキストを検出しようとするパングラムの取り組みと全く矛盾しない点にも注目すべきです。優れた作家でさえ、その手口を見抜かれることがあるのですから!