Pangram, Gemini 3.8 Flash ve Gemini 3.1 Pro'yu algılayabilir mi?
Ayrıca, kıyaslama ölçütü seçimi, örneklem dağılımı ve istatistiğin amacı üzerine bir tartışma da yer almaktadır.

İşte kısa bir özet
1.000 komut üzerinden yapılan testlerde, Pangram 4, Gemini 3.8 Flash çıktılarında %99,80, Gemini 3.1 Pro çıktılarında ise %99,70 doğruluk oranına ulaşarak, bu kıyaslama seti için Gemini ailesinin en son sürümünde toplamda %99,75 doğruluk oranı elde etmiştir.
1.000 doğal dil örneği arasından, Pangram 4, Gemini 3.8 Flash çıktılarından ikisini insan tarafından, 998'ini ise tamamen yapay zeka tarafından üretilmiş olarak sınıflandırarak Gemini 3.8 Flash'ta %99,80 doğruluk oranına ulaştı. Gemini 3.1 Pro'da (19 Şubat 2026'da yayınlandı) ise Pangram, bir çıktıyı karışık, ikisini tamamen insan tarafından ve 997'sini tamamen yapay zeka tarafından üretilmiş olarak sınıflandırarak Gemini 3.1 Pro'da %99,70 doğruluk oranına ulaştı.
Karşılaştırma veri setini oluşturmak için, LMSYS veri setinden (Zheng vd., 2023) ilk tur Chatbot Arena sorularının filtrelenmiş bir alt kümesini kullandım. Kod, matematik, çok kısa veya çok uzun cevaplar ya da uygunsuz yaratıcı yazılar isteyen soruları filtreledim. Ardından bunları Gemini 3.8 Flash ve Gemini 3.1 Pro'ya verdim ve çıktıyı Pangram 4'ten geçirdim.
Aşağıda, kategoriye göre tespit sonuçlarını, yanlış negatifleri, Gemini 3.1 Pro'nun önceki kıyaslamalardaki performansını ve blog yazısı için seçtiğim komut satırı yönteminin bazı eksikliklerini ve gelecekteki iyileştirmelerini ele alıyoruz.
Kategorilere göre sonuçlar
Haiku temsilcileri tarafından atanan komut kategorisine göre, Pangram 4'ün 1.000 adet Gemini 3.8 Flash çıktısı üzerindeki performansı şu şekildedir:
| Kategori | Örnekler | Yapay Zeka | Karışık | İnsan |
|---|---|---|---|---|
| Gerekçeler | 18 | 18 | 0 | 0 |
| E-postalar / mektuplar | 54 | 53 | 0 | 1 |
| Denemeler / makaleler | 33 | 33 | 0 | 0 |
| Açıklamalar | 563 | 563 | 0 | 0 |
| Şiirler | 108 | 107 | 0 | 1 |
| Diğer yaratıcı yazılar | 75 | 75 | 0 | 0 |
| Yorumlar | 7 | 7 | 0 | 0 |
| Hikâyeler | 142 | 142 | 0 | 0 |
| Toplam | 1,000 | 998 | 0 | 2 |
İşte Gemini 3.1 Pro için kategoriye göre sonuçlar:
| Kategori | Örnekler | Yapay Zeka | Karışık | İnsan |
|---|---|---|---|---|
| Gerekçeler | 18 | 18 | 0 | 0 |
| E-postalar / mektuplar | 55 | 55 | 0 | 0 |
| Denemeler / makaleler | 33 | 33 | 0 | 0 |
| Açıklamalar | 559 | 559 | 0 | 0 |
| Şiirler ve diğer yaratıcı yazılar | 182 | 179 | 1 | 2 |
| Yorumlar | 7 | 7 | 0 | 0 |
| Hikâyeler | 146 | 146 | 0 | 0 |
| Toplam | 1,000 | 997 | 1 | 2 |
Gemini 3.8 Flash'ın yanlış negatiflerinden biri, modelden çıktıları insansılaştırmasını , yazım hataları ve imla yanlışları eklemesini isteyen bir komutta ortaya çıktı:
(Raid Shadow Legends oyununda yeni bir oyuncuyum ve 10. seviyedeyim.) HelpWanted adlı bir klana, yazım hataları ve imla yanlışları içeren kısa ve ikna edici bir mektup yazın.
Pangram 4, tıpkı Opus 5.5 tarafından oluşturulduğunda olduğu gibi, Penguinmandias'ın her iki model versiyonunu da kaçırdı. Komut şu şekildedir:
Ozymandias tarzında bana bir Club Penguin şiiri yaz.
Gemini 3.1 Pro için, Penguinmandias'taki kelimelerin %71'i Shelley'nin orijinal şiiriyle aynı, bu yüzden bunun oldukça düşük endişe verici bir yanlış negatif olduğunu düşünüyorum. Gemini 3.1 Pro ayrıca iki şiirde daha hata tespit etti.
Bir kıyaslama sonucunu ne belirler?
Pangram 4 hakkındaki teknik raporumuzda , 26 farklı modelden elde edilen 520.000 yapay zeka çıktısı üzerinde (model başına 20.000 yanıt) yanlış negatif testi gerçekleştirdik. Raporda test edilen modellerden biri de burada da test ettiğimiz Gemini 3.1 Pro idi. Ancak, teknik rapora bakarsanız göreceğiniz gibi, bu çıktı setinde bulduğumuzdan farklı, daha yüksek bir yanlış negatif oranı bulduk. Neden?
Bir cevap, istatistiksel olarak farklı olmadıklarıdır. Burada bulduğumuz 1.000 yanıtta 3 hata, %0,3'lük gözlemlenen bir yanlış negatif oranına (FNR) karşılık gelir ve %95 güven aralığı %0,06 ile %0,87 arasındadır. Teknik rapordaki FNR ise 20.000 istemde 111 hata veya %0,555'tir ve bu da belirtilen aralık içindedir.
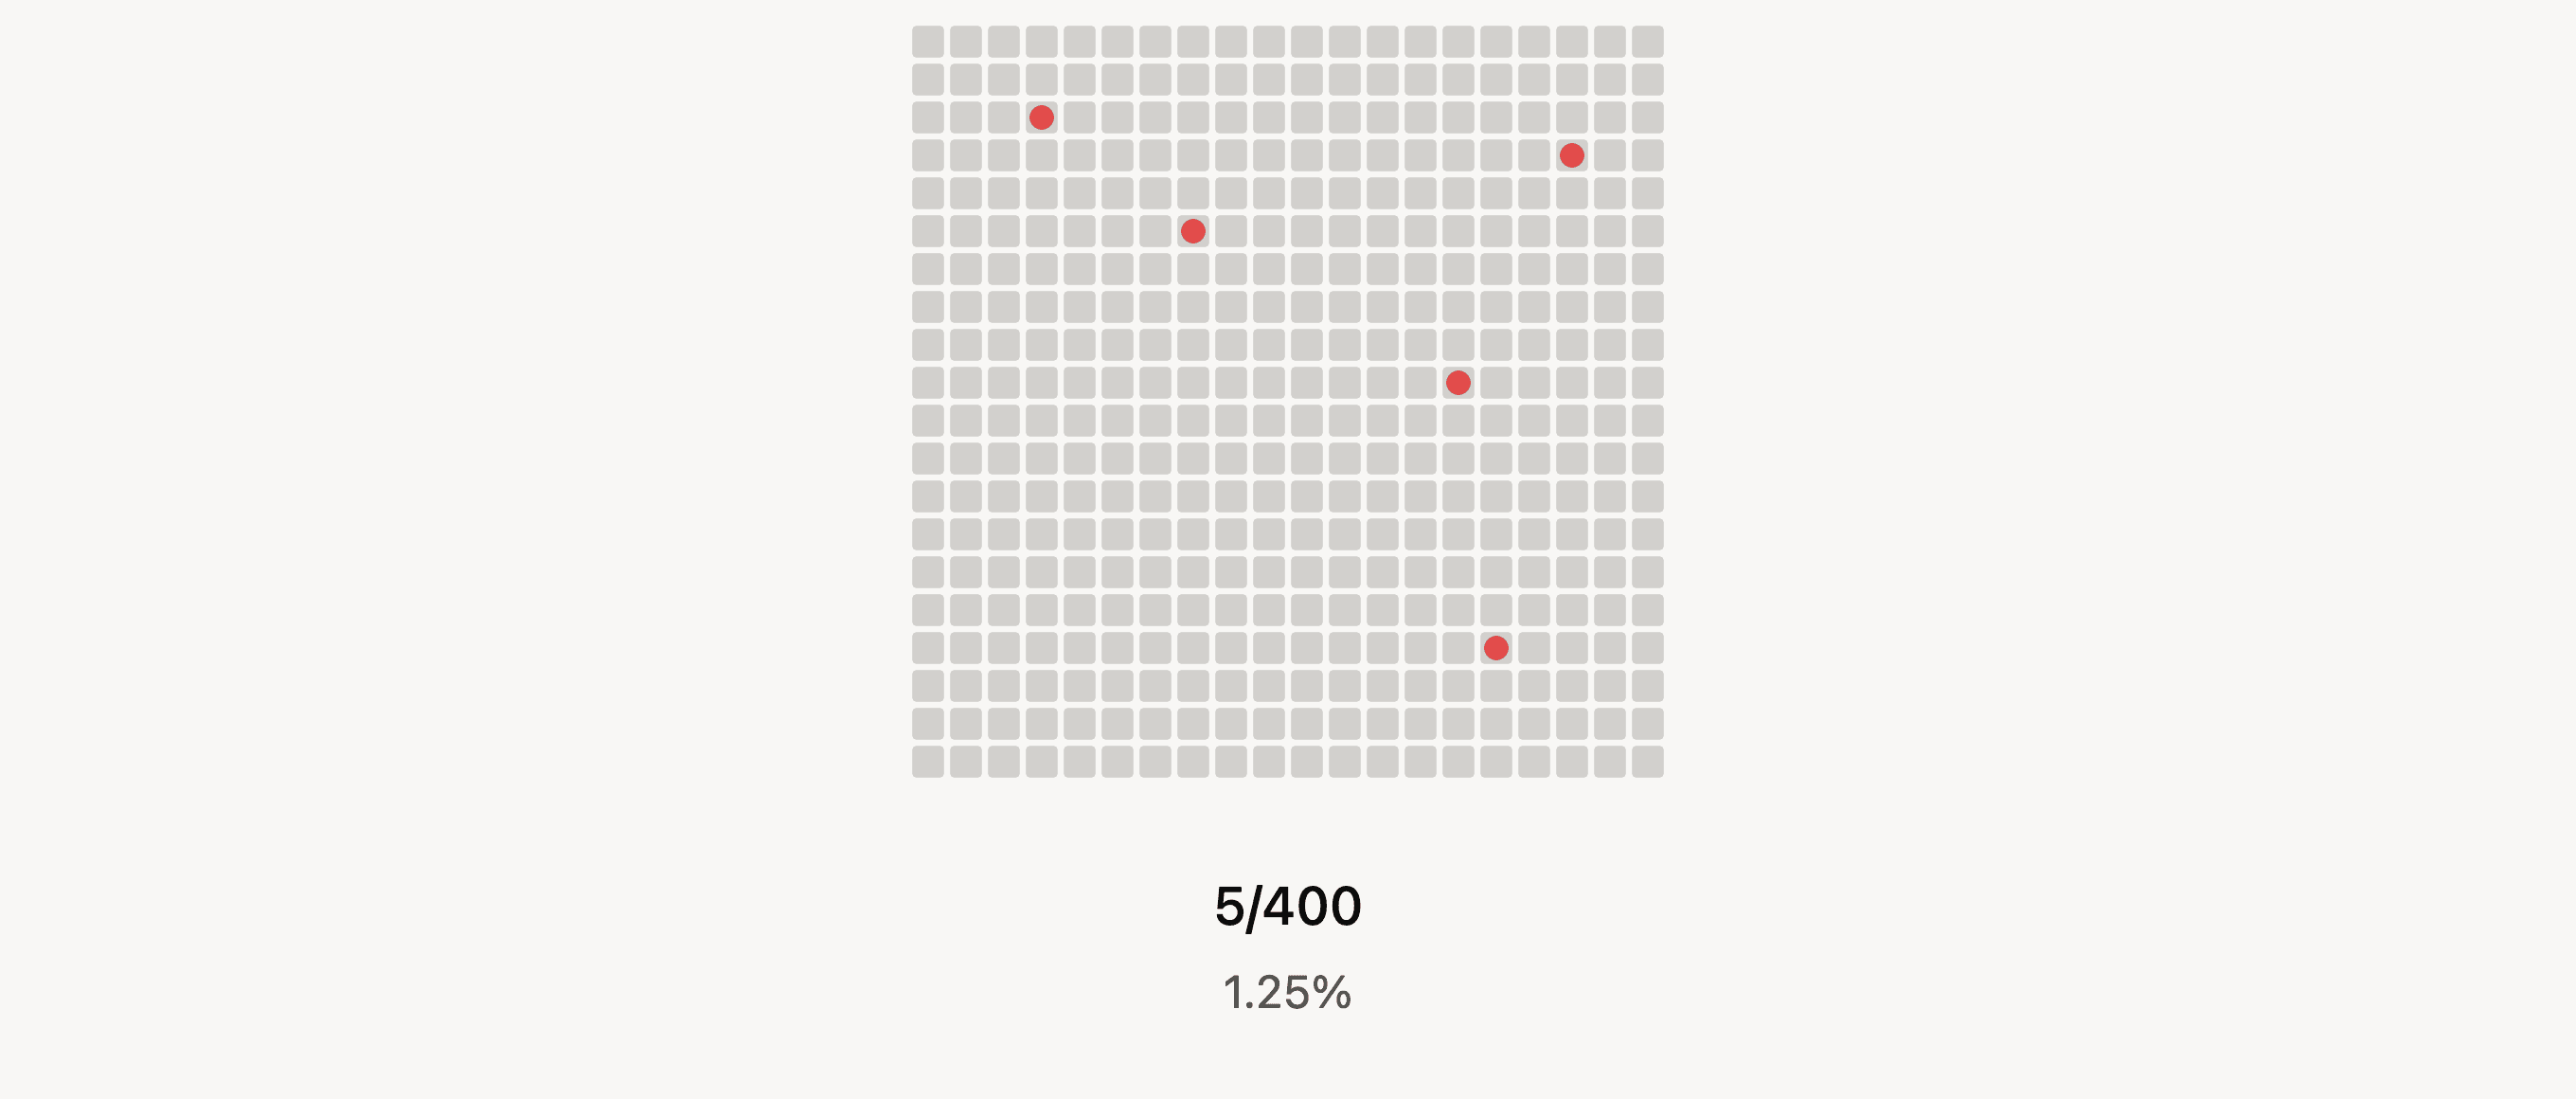
Peki, bu sayıların istatistiksel olarak farklı olmadığını söylerken ne demek istiyorum? Diyelim ki, önceden pozitif olduğunu bildiğim 400 test örneğinden oluşan büyük bir kümem var ve bir dedektörün bunları doğru bir şekilde pozitif olarak etiketleyip etiketlemediğini veya bazılarını yanlışlıkla negatif olarak etiketleyip etiketlemediğini test etmek istiyorum. A evreninde, 400 örneğin tamamını test ediyorum ve 5'inin yanlışlıkla negatif olarak etiketlendiğini buluyorum (aşağıda kırmızı noktalarla gösterilmiştir), bu da dedektörümün tüm küme için %1,25'lik bir yanlış negatif oranına karşılık geliyor. Harika!
Öte yandan, B evreninde, bir nedenden dolayı kaynak kısıtlaması altındayım. 400 örneğin sadece küçük bir kısmını test edebiliyorum. Bu, ideal olarak rastgele bir örneklem alıp üzerinde test yapmam gerektiği anlamına geliyor. Diyelim ki 40 örnek, yani toplam setimin %10'unu test edebiliyorum. Aşağıda, bu seti seçebileceğim ve her birinin farklı bir yanlış negatif oranına yol açacağı üç farklı yol bulunmaktadır.
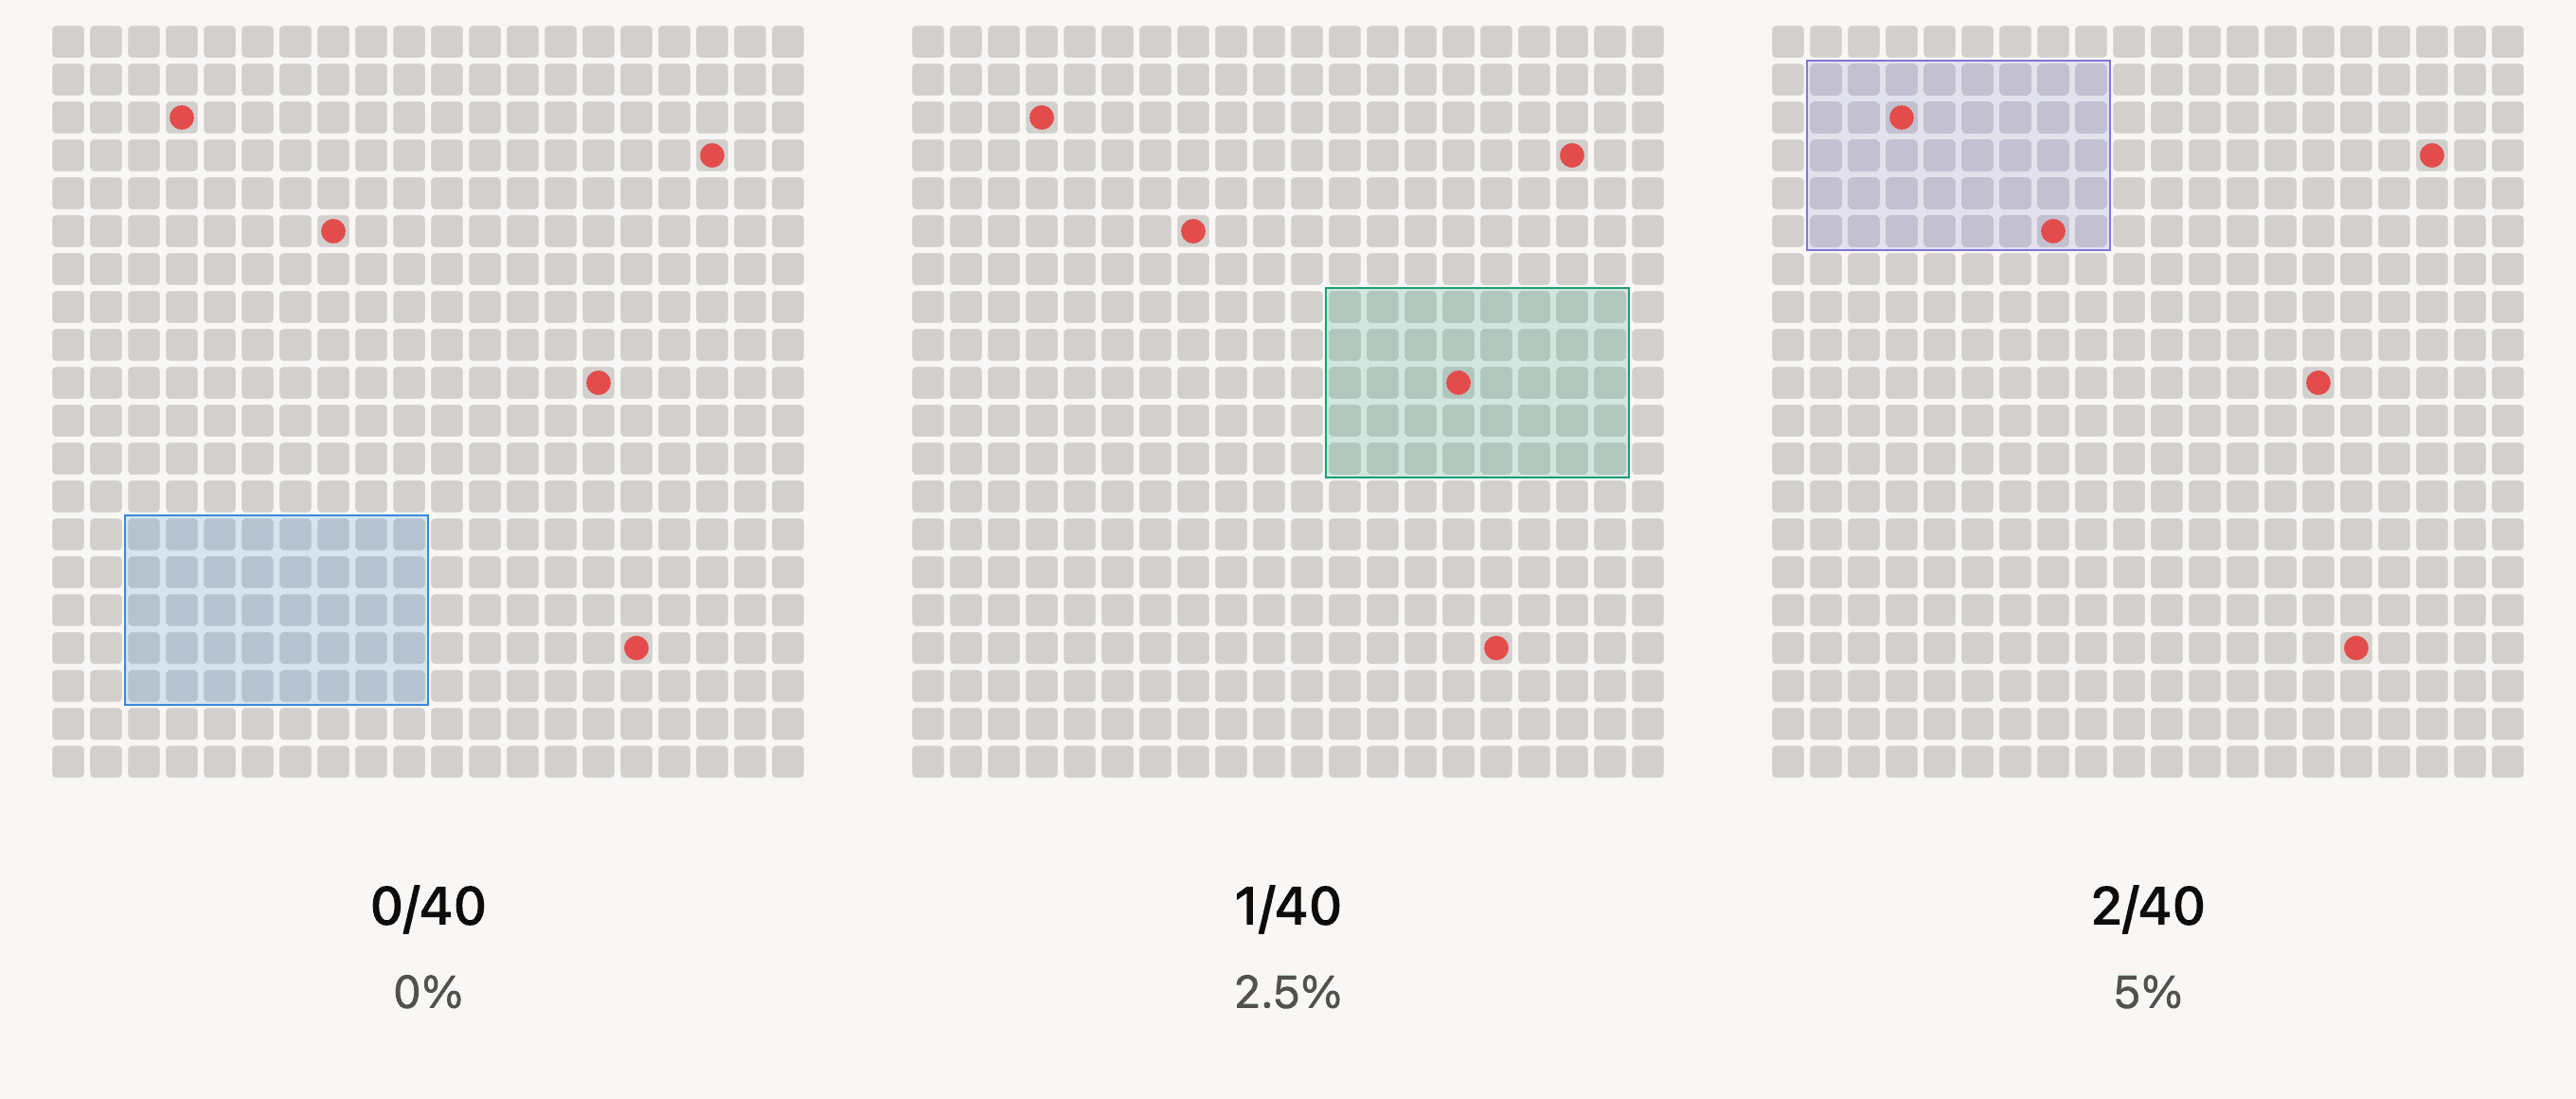
Bu örneklerin her biri farklı bir yanlış negatif oranı bildirmektedir ve bunların hiçbiri, A evreninde erişebildiğimiz dedektörün "gerçek" yanlış negatif oranı olan %1,25 ile örtüşmemektedir. Beklentide, bu ızgaradaki 40 kareden oluşan rastgele bir örneklem, kırmızı noktaların yarısını yakalayacaktır, ancak örneklemeye bağlı olarak, mavi örnekte olduğu gibi hiç kırmızı nokta, bir kırmızı nokta veya mor örnekte olduğu gibi iki kırmızı nokta yakalayabilir. Çok şanssız bir örneklem tüm kırmızı noktaları yakalayabilir ve bu örneklemde gözlemlenen yanlış negatif oranı 5/40 veya %12,5 olacaktır.
Böyle şanssız bir örneklem çok düşük bir olasılıktır. Kümenin rastgele %10'luk bir örneği, %99 olasılıkla 0 ile 2 nokta arasında sonuç verecektir; bu aralık, örnekleme dağılımı olarak adlandırılan şeyden kaynaklanır. Pratikte bu, B evreninin olası 400 vakadan 40'ını örneklem olarak almasının, %0'lık bir yanlış negatif oranı ile %5'lik bir yanlış negatif oranı arasındaki farkı gerçekten ayırt edemeyeceği anlamına gelir. Örneklem ne kadar büyük olursa, bu aralık o kadar küçük olur: Örneğin, toplam 400 noktadan 125'ini örneklem olarak alsaydık, %99 olasılıkla 0 ile 4 nokta arasında sonuç bulurduk veya gözlemlenen yanlış negatif oranı %0-3,2 olurdu.
Aynı mantık Gemini 3.1 Pro kıyaslama testlerimize de uygulanabilir ve iki farklı yanlış negatif sonuç birbiriyle çelişmez. Ancak aradaki fark yine de hangisine daha çok güvenmeniz gerektiği konusunda sizi düşündürebilir. Genel olarak, bu konuda karar verirken yol gösterici unsur örneklem büyüklüğüdür: daha büyük bir örneklem, daha temsili bir tablo ve daha küçük bir olası hata aralığı anlamına gelir. Bu mantığa göre, teknik rapor kıyaslama testine daha çok güvenmeli ve bunu sadece bir gösterge olarak kabul etmelisiniz.
İki kıyaslama sonucunun farklılık gösterebileceği başka yollar da vardır. Izgara örneğinden farklı olarak, kullandığım kıyaslama seti, teknik raporda kullanılan 20.000 Chatbot Arena sorusunun kesin bir alt kümesi değildir: toplamda, iki Gemini 3.1 Pro kıyaslaması 286 tam soruyu paylaşmaktadır. Bu da, kullandığım kıyaslama sorularından 714'ünün, Pangram 4 teknik raporunda kullanılanlardan daha algılanabilir yapay zeka çıktıları üretmek için daha elverişli olabileceği olasılığını ortaya koymaktadır.
Durum böyle görünmüyor. Her iki veri seti de diğer dilleri, matematiği ve kodlama çıktılarını dışlıyor. Ancak farklılıklar var: Gemini 3.1 Pro yanıtı başına düşen kelime sayısının medyan değeri, teknik rapor setine kıyasla benim veri setimde daha yüksekti ve bildiğimiz gibi daha uzun metinlerin puanlanması daha kolay. Peki, modelin daha adil bir testi hangisi? Çıktı uzunluğunu ve örneklem büyüklüğünü kontrol altına alırsak, hangi soru seti A evrenini daha iyi temsil eder?
Doğru cevap, bilmiyorum ve söyleyemem. Gerçek dünyayı mükemmel ve tam olarak temsil eden bir küme oluşturmak zordur, neredeyse imkansızdır. Bu, istatistiğin temel kısıtlamasıdır. Gerçekte, her kıyaslama, A evreninin veya "dışarıdaki" dünyanın temel gerçekliğini yaklaşık olarak temsil eden örneklerden oluşan bir yamalı bohçanın içindeki küçük bir karedir. Bir anlamda, bu gerçek, tüm kıyaslama sonuçlarının yanlış olduğu anlamına gelebilir ki bu yanlış değildir, ancak bu onların yararlı olmadığı anlamına gelmez. Birçok farklı türdeki küme üzerinde birçok farklı sonucu bir araya getirerek, gerçek temel gerçekliğin iyi bir yaklaşık temsiline ulaşabiliriz. Bu nedenle, model, dil , içerik ve insanlaştırıcıya özgü olanlar da dahil olmak üzere birçok farklı türde kıyaslama yapıyoruz.
Daha iyi bir yaklaşım oluşturmak için, kıyaslama seti oluşturma sürecimde yapmak istediğim bazı iyileştirmeler var. Bundan sonra, her model sürümü için aynı soruları kullanmak yerine, Chatbot Arena soruları için seçim sürecini daha büyük bir kümeden rastgele hale getireceğim. Ayrıca, teknik sorular gibi daha çeşitli sorulara izin vermek için filtrelerimi biraz gevşeteceğim ve aldığımız yanıt türünü çeşitlendirmek için havuza bazı ek sorular ekleyeceğim.
Bu blog yazıları teknik rapora kıyasla daha az önem taşıyor, ancak bu, B evreninde bile titizliği hedeflemememiz gerektiği anlamına gelmiyor.
Sonuç
Pangram, doğal dil komutlarında Gemini 3.8 Flash'a karşı dayanıklıdır ve %99,80'lik gözlemlenen bir doğruluk oranıyla tespit eder. Gemini 3.1 Pro'yu ise %99,70'lik gözlemlenen bir doğruluk oranıyla tespit eder; bu da her iki modelde toplamda 2000'de 1995 (%99,75) doğruluk anlamına gelir. Pangram, yeni model sürümlerinin genellikle önceki sürümlerin stilini ve sesini büyük ölçüde miras alması nedeniyle yeni modellere genelleme yapabilir; bu nedenle Pangram'ın her yeni sürüm için yeniden eğitilmesine gerek yoktur.
İşte Gemini 3.8 Flash ve Gemini 3.1 Pro'nun diğer yeni nesil modellerle karşılaştırmalı testlerimiz:
| Model | Yapay zeka olarak algılandı | Doğruluk |
|---|---|---|
| Gemini 3.8 Flash | 998/1.000 | 99.80% |
| Gemini 3.1 Pro | 997/1.000 | 99.70% |
| Claude Opus 5.5 | 997/1.000 | 99.70% |
| Masal 5.1 | 1.093/1.097 | 99.64% |
| Claude Opus 5 | 1.105/1.107 | 99.82% |
| GPT-5.6 | 3.408/3.423 | 99.56% |
| Claude Sonnet 5 | 1.145/1.147 | 99.83% |
| İkizler 3 | 28/28 | 100% |
Belirli bir belgeyi kontrol etmek istiyorsanız, buradan Pangram’ı deneyebilirsiniz.
Annamieka, Pangram’da teknik yazar olarak çalışmaktadır.
İlgili makaleler
Amazon'daki ilk sayfadaki yorumların yüzde üçü artık yapay zeka tarafından oluşturuluyor
Pangram, çeşitli öğrenci kompozisyonlarında 0 yanlış pozitif sonuç gösteriyor
Yelp yorumlarına derinlemesine bir bakış

Pangram’ın İşbirliği Yapan Ajan Sürüsündeki Performansı
Basın bültenlerinin yaklaşık %50’sinin yazılmasında yapay zeka yardımcı oluyor
Üçüncü Taraf Pangram Değerlendirmeleri

