以下是简要总结
在 1000 个提示中,Pangram 4 在 Gemini 3.8 Flash 输出上达到 99.80% 的准确率,在 Gemini 3.1 Pro 输出上达到 99.70% 的准确率,对于此基准测试集,在最新版本的 Gemini 系列上总准确率为 99.75%。
在1000个自然语言示例中,Pangram 4 将Gemini 3.8 Flash上的两个输出结果分类为人类语言,将998个结果分类为完全由人工智能生成,在Gemini 3.8 Flash上的准确率达到99.80%。在Gemini 3.1 Pro(2026年2月19日发布)上,Pangram 将一个输出结果分类为混合语言,两个结果分类为完全由人类语言,将997个结果分类为完全由人工智能生成,在Gemini 3.1 Pro上的准确率达到99.70%。
为了生成基准数据集,我使用了LMSYS数据集(Zheng等人,2023)中Chatbot Arena第一轮对话提示的筛选子集。我剔除了要求编写代码、数学公式、回答过短或过长,以及不恰当的创意写作的提示。然后,我将筛选后的数据集输入到Gemini 3.8 Flash和Gemini 3.1 Pro中,并将输出结果导入Pangram 4进行分析。
下面我们将按类别讨论检测结果、漏报情况、Gemini 3.1 Pro 在之前的基准测试中的表现,以及我在博客文章中选择的提示的一些不足之处和未来的改进方向。
按类别查看结果
根据提示类别(由 Haiku 代理分配),以下是 Pangram 4 在 1,000 个 Gemini 3.8 Flash 输出上的表现:
| 类别 | 示例 | AI | 混合 | 人类 |
|---|---|---|---|---|
| 参数 | 18 | 18 | 0 | 0 |
| 电子邮件/信件 | 54 | 53 | 0 | 1 |
| 随笔/文章 | 33 | 33 | 0 | 0 |
| 说明 | 563 | 563 | 0 | 0 |
| 诗歌 | 108 | 107 | 0 | 1 |
| 其他创意写作 | 75 | 75 | 0 | 0 |
| 评论 | 7 | 7 | 0 | 0 |
| 故事 | 142 | 142 | 0 | 0 |
| 总计 | 1,000 | 998 | 0 | 2 |
以下是 Gemini 3.1 Pro 的各项分类结果:
| 类别 | 示例 | AI | 混合 | 人类 |
|---|---|---|---|---|
| 参数 | 18 | 18 | 0 | 0 |
| 电子邮件/信件 | 55 | 55 | 0 | 0 |
| 随笔/文章 | 33 | 33 | 0 | 0 |
| 说明 | 559 | 559 | 0 | 0 |
| 诗歌及其他创意写作 | 182 | 179 | 1 | 2 |
| 评论 | 7 | 7 | 0 | 0 |
| 故事 | 146 | 146 | 0 | 0 |
| 总计 | 1,000 | 997 | 1 | 2 |
Gemini 3.8 Flash 的一个误报是针对要求模型使输出内容人性化的提示,即添加拼写错误和错别字:
请写一封包含拼写错误和错别字的信给一个名为 HelpWanted 的公会(我是 Raid Shadow Legends 的新手,等级 10)。信件要简短且极具说服力。
Pangram 4 错过了两种模型版本的 Penguinmandias,就像它由Opus 5.5生成时一样。提示是:
请用奥兹曼迪亚斯的风格为我写一首企鹅俱乐部的诗。
对于 Gemini 3.1 Pro 来说,《企鹅曼迪亚斯》中有 71% 的词语与雪莱的原诗相同,所以我认为这算是一个不太值得关注的误判。Gemini 3.1 Pro 还漏判了另外两首诗。
基准结果由什么构成?
在我们关于全语词组4的技术报告中,我们对来自26个不同模型的52万个AI输出(每个模型2万个响应)进行了漏报测试。报告中测试的模型之一是Gemini 3.1 Pro,我们也在这里对其进行了测试。然而,正如您在技术报告中看到的那样,我们发现该数据集的漏报率比我们在这里测试的数据集更高。这是为什么呢?
一种解释是,从统计学角度来看,它们之间没有差异。我们在这里发现的1000次响应中3次漏报,对应的观测假阴性率为0.3%,其95%置信区间为0.06%至0.87%。技术报告中的假阴性率为20000次提示中111次漏报,即0.555%,也在这个范围内。
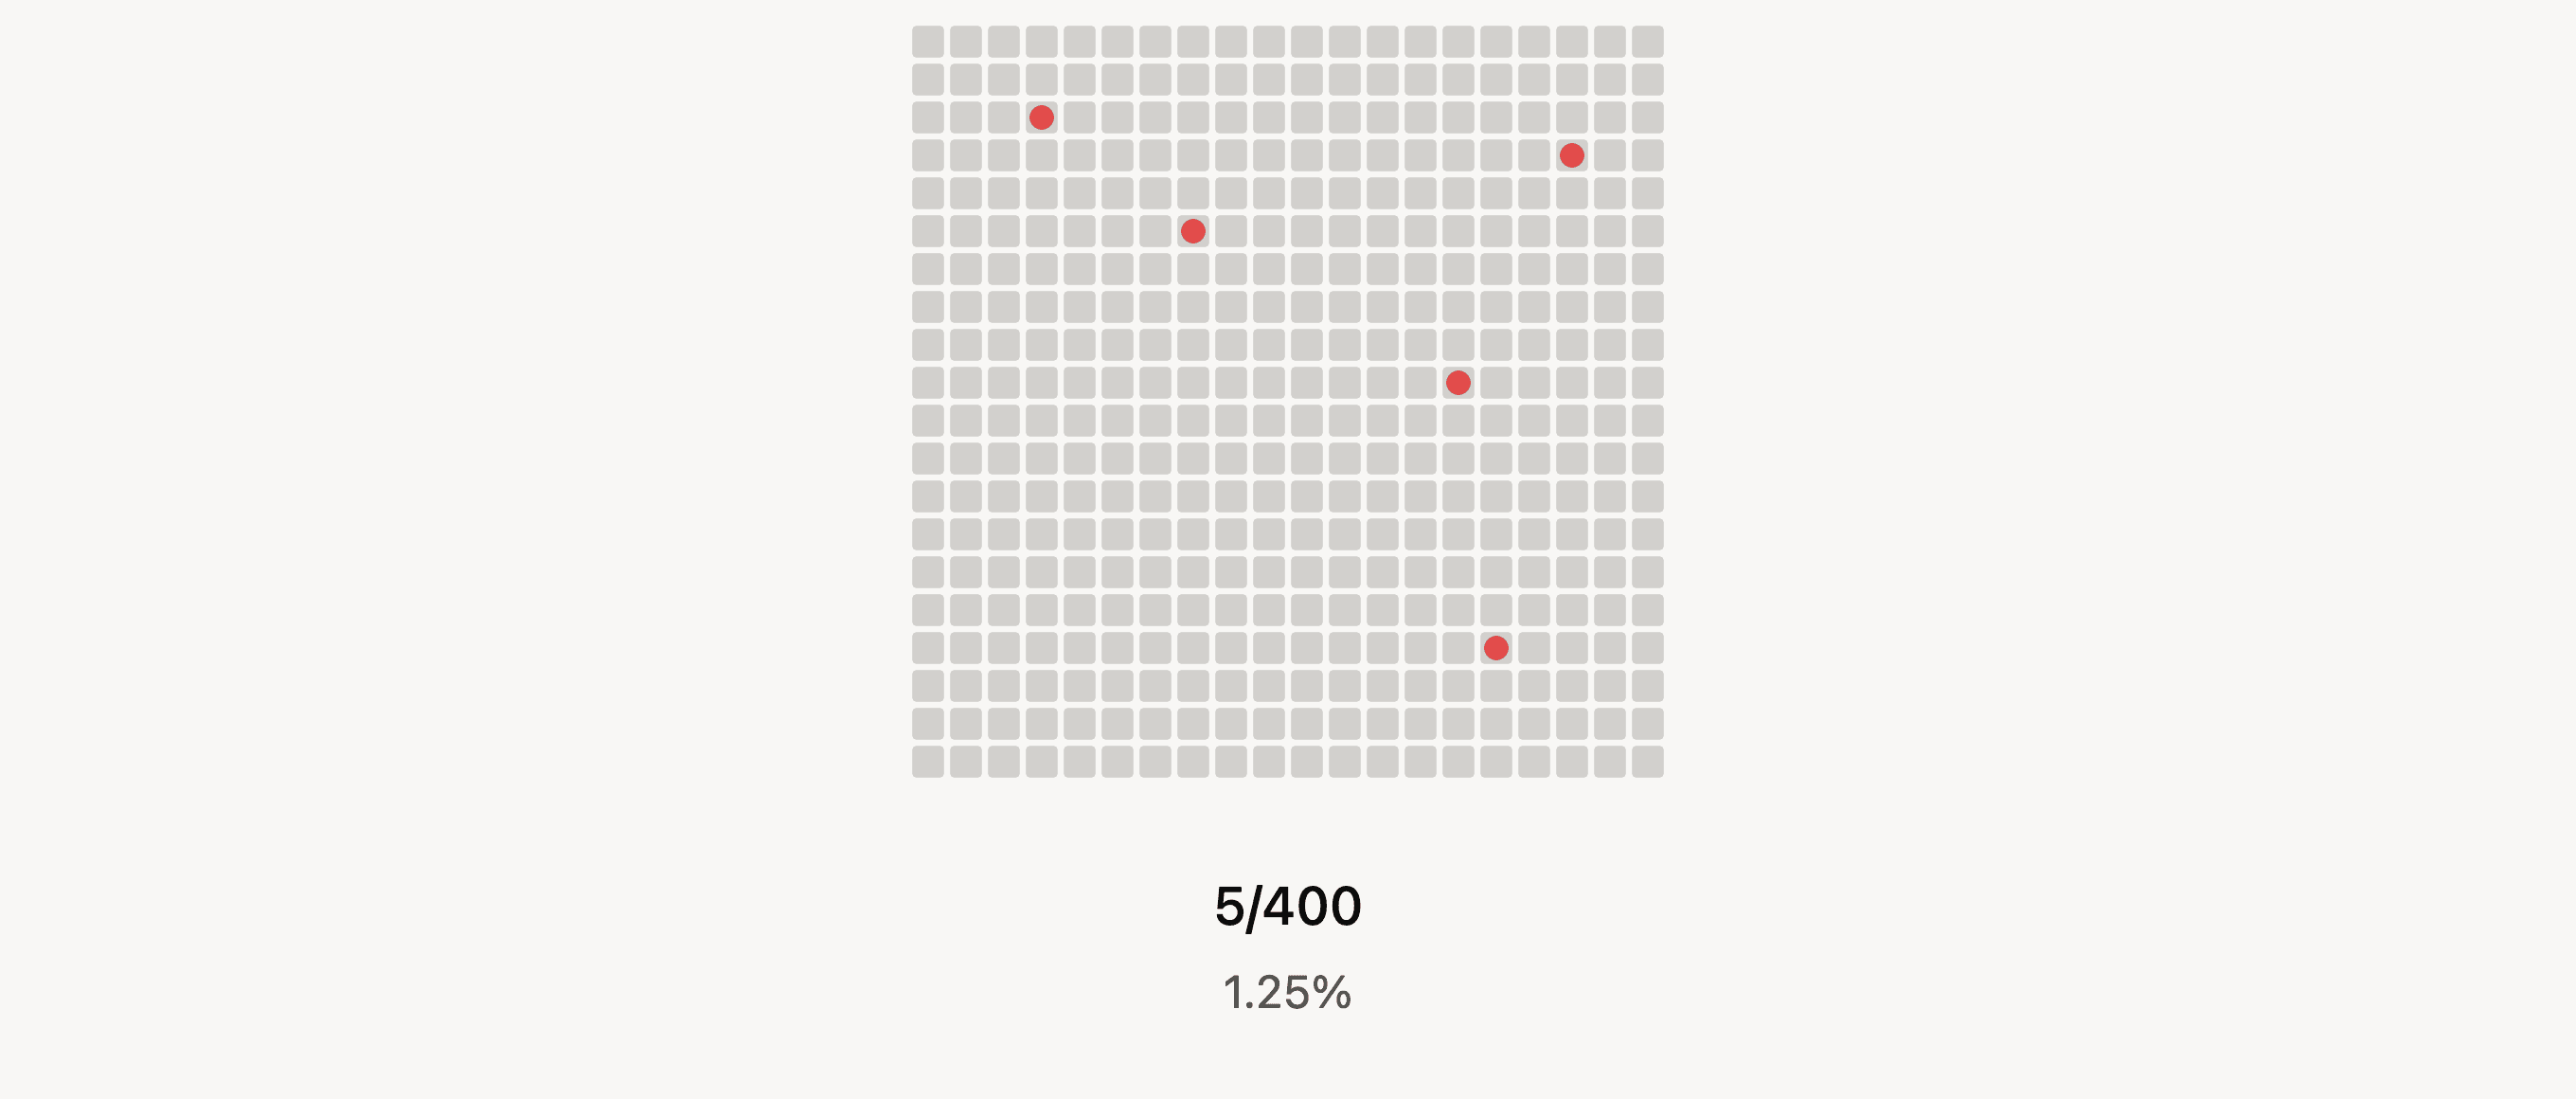
但我说这些数字在统计学上没有显著差异是什么意思呢?假设我有一个包含 400 个测试用例的大型数据集,我事先知道这些用例都是阳性,我想测试某个检测器是否能正确地将它们标记为阳性,或者是否错误地将一些标记为阴性。在数据集 A 中,我测试了所有 400 个样本,发现有 5 个被错误地标记为阴性(如下图中的红点所示),这意味着我的检测器在整个数据集上的假阴性率为 1.25%。太好了!
另一方面,在宇宙 B 中,由于某种原因,我的资源有限。我只能测试 400 个样本中的一小部分。这意味着我必须抽取一个样本(理想情况下是随机样本)进行测试。假设我可以测试 40 个样本,即总样本量的 10%。以下是三种不同的样本选择方法,每种方法都会导致不同的假阴性率。
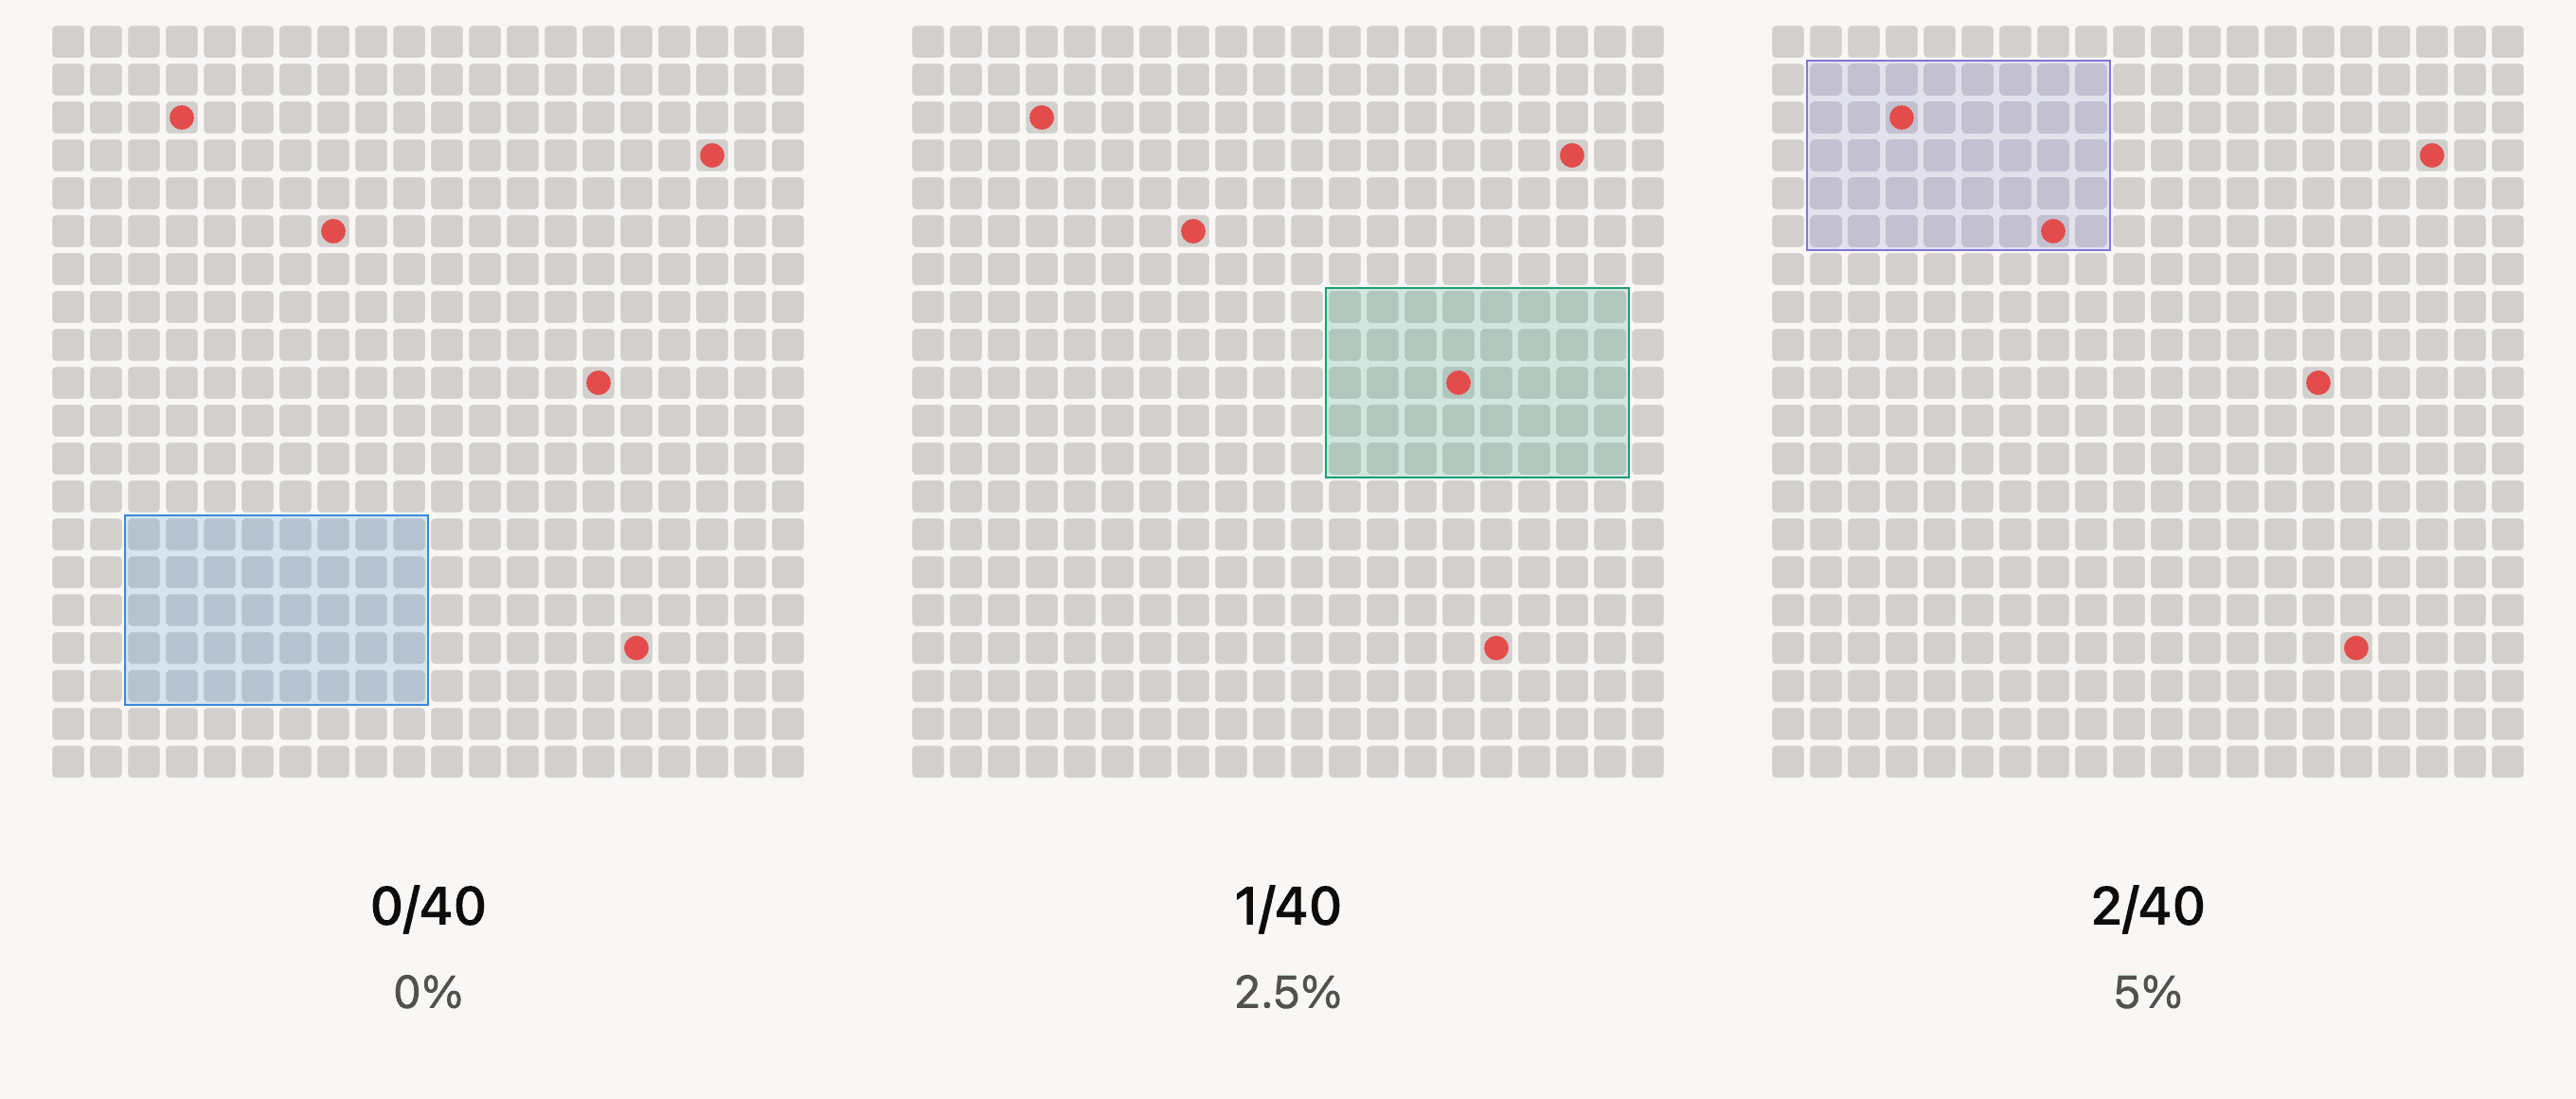
每个样本的假阴性率都不同,而且没有一个与我们在A宇宙中测得的检测器“真实”假阴性率1.25%相符。预期在这个网格中随机抽取40个方格应该能检测到半个红点,但根据抽样情况,可能一个红点都没检测到(如蓝色样本),一个红点,或者两个红点(如紫色样本)。运气极差的样本甚至可能检测到所有红点,在这种情况下,观察到的假阴性率将为5/40,即12.5%。
然而,出现这种不幸的样本的可能性非常小。从该集合中随机抽取 10% 的样本,99% 的情况下会发现 0 到 2 个点——这个范围源于所谓的抽样分布。实际上,这意味着从 400 个可能的样本中抽取 40 个样本(来自总体 B),实际上无法区分潜在的假阴性率为 0% 和 5% 之间的差异。样本越大,这个范围就越小:如果我们从总共 400 个点中抽取 125 个点,99% 的情况下会发现 0 到 4 个点,或者说观察到的假阴性率为 0-3.2%。
同样的逻辑也适用于我们的 Gemini 3.1 Pro 基准测试,两个不同的漏报结果并不矛盾。但这种差异仍然可能让您疑惑应该更相信哪一个。通常,判断的关键在于样本量:更大的样本意味着更具代表性,误差范围也更小。因此,按照这个逻辑,您应该更信任技术报告中的基准测试结果,而将此结果仅作为参考。
两个基准测试结果可能存在其他差异。与网格示例不同,我使用的基准测试集并非技术报告中使用的 20,000 个 Chatbot Arena 提示的严格子集:总共有两个 Gemini 3.1 Pro 基准测试共享了 286 个完全相同的提示。这意味着我使用的基准测试问题中,可能有 714 个问题比 Pangram 4 技术报告中使用的问题更有利于产生可检测的 AI 输出。
情况似乎并非如此。两组数据都排除了其他语言、数学和代码输出。然而,两者之间确实存在差异:与技术报告组相比,我的测试组中每条 Gemini 3.1 Pro 回复的单词数中位数更高,而且我们知道,较长的文本更容易评分。但是,哪一组测试更能公平地检验模型呢?如果我们控制了输出长度和样本量,哪一组提示更能代表总体 A?
真正的答案是我不知道,也无法断言。要创建一个能够完美且精确地代表真实世界的数据集几乎是不可能的。这是统计学的核心局限。实际上,每个基准测试都只是众多样本拼凑而成的一幅微不足道的拼图,这些样本共同构成了宇宙A(或“外部世界”)的底层现实。从某种意义上说,这可以被解读为所有基准测试结果都是错误的,这并非完全错误,但这并不意味着它们毫无用处。通过将许多不同数据集上的众多不同结果拼凑在一起,我们可以很好地近似真实的底层现实。这就是为什么我们要运行多种不同类型的基准测试,包括针对特定模型、语言、内容和人机交互的测试。
为了获得更精确的模拟结果,我计划对基准测试集的生成流程进行一些改进。今后,我将从一个更大的数据集中随机选择 Chatbot Arena 的提示,而不是每次发布新模型都使用相同的提示。此外,我还会稍微放宽筛选条件,允许出现更多样化的提示,例如技术问题,并向提示池中添加一些额外的提示,以丰富我们收到的回复类型。
与技术报告相比,这些博客文章的风险很低,但这并不意味着我们不应该追求严谨,即使是在 B 宇宙中。
结论
Pangram 对 Gemini 3.8 Flash 在自然语言提示方面表现出良好的鲁棒性,检测准确率高达 99.80%。它对 Gemini 3.1 Pro 的检测准确率也达到了 99.70%,两种型号的综合准确率达到了 99.75%(2000 次测试中识别出 1995 次)。Pangram 能够泛化到新型号,因为新型号通常会继承其前代型号的大部分风格和语音特征,所以 Pangram 无需针对每个新版本进行重新训练。
以下是 Gemini 3.8 Flash 和 Gemini 3.1 Pro 与我们近期其他前沿机型基准测试结果的对比:
| 型号 | 被检测为人工智能 | 准确性 |
|---|---|---|
| 双子座3.8闪光灯 | 998/1,000 | 99.80% |
| Gemini 3.1 Pro | 997/1,000 | 99.70% |
| 克劳德作品 5.5 | 997/1,000 | 99.70% |
| 寓言 5.1 | 1,093/1,097 | 99.64% |
| 克劳德·作品第5号 | 1,105/1,107 | 99.82% |
| GPT-5.6 | 3,408/3,423 | 99.56% |
| 克劳德·索内特 第5首 | 1,145/1,147 | 99.83% |
| 双子座3号 | 28/28 | 100% |
如果您想检查特定的文档,可以在这里试用 Pangram。